 Pocchito
第1章 大規模言語モデルとは何か
リマインダーの依頼を雑談と分類した小型モデルの実験から、言語モデルのしくみとアプリの役割を考えます。
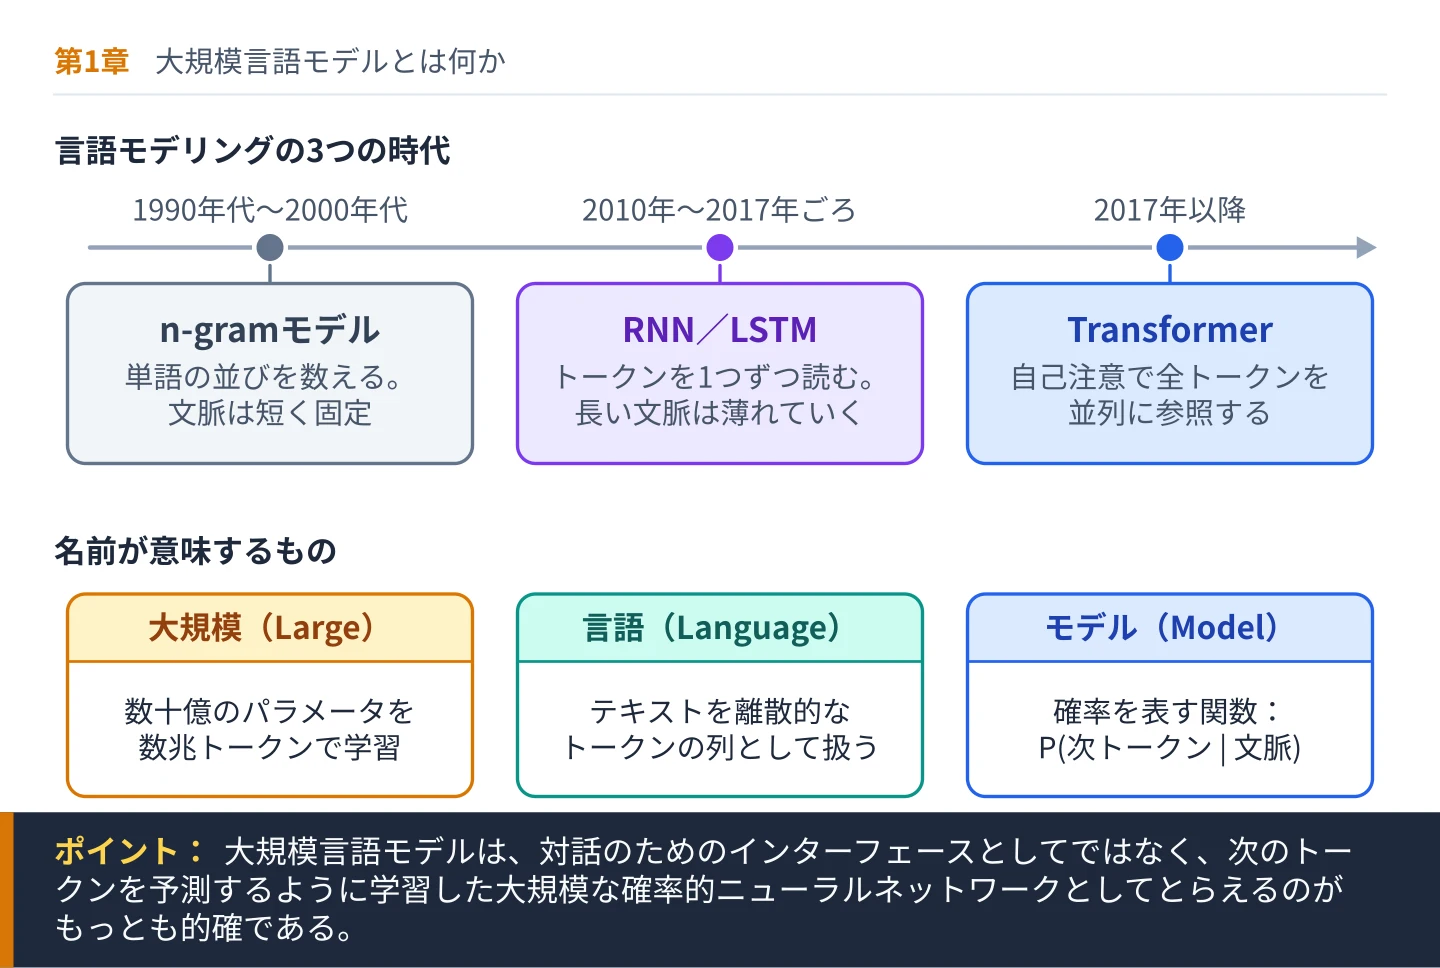
「大規模言語モデル」という言葉は広く使われているが、その使われ方はしばしば大ざっぱだ。チャット画面、文章の生成、コーディング支援、AIを使った検索などと結びつけて語られる。しかし、これらのシステムがどう動くのか、あるいはどう作り、どう評価するのかを理解するには、その前に正確な定義が必要になる。第1章では、その定義を定め、言語技術の大きな発展の流れのなかに位置づける。
本章のねらいは2つある。1つ目は、技術的な観点から、何をもって大規模言語モデルと呼ぶのかをはっきりさせること。2つ目は、LLM を歴史と概念の文脈のなかに置き、人の手で書いた言語規則から、膨大なデータセットで学習した大規模なニューラルシステムへとどう移ってきたのかをたどることである。本章を読み終えれば、LLM とは何か、何ではないのか、そしてなぜAIエンジニアリングにおける大きな転換点なのかについて、揺るがない理解の枠組みが得られるはずだ。
1.1節「『LLM』が意味するもの」では、この言葉そのものを分解する。「大規模」がパラメータ、データ、計算量の点で実際に何を意味するのか、「言語」がトークン列や記号による表現について何を含意するのか、そして思考する存在ではなく「モデル」と呼ぶことが何を意味するのかを検討する。この節で、概念を正確に押さえる。
1.2節「言語モデルの歴史」では、n-gram のような初期の統計的手法から、ニューラルな系列モデルを経て、今日の Transformer にもとづくシステムに至るまで、言語モデリングの発展をたどる。この流れを追うと、現代の LLM は突然のブレークスルーではなく、段階的な進歩の積み重ねの到達点であることがわかる。
1.3節「ルールベースから統計モデルへ」では、さらにさかのぼり、より根本的な考え方の転換を検討する。明示的にプログラムされた言語規則から、データにもとづく確率的な学習への移行である。この転換が、現代のAIの全体を支えている。
1.4節「なぜ今LLMが重要なのか」では、規模、アーキテクチャ、データがそろったことで現在のモデルが可能になった経緯を分析する。汎用的な次トークン予測が柔軟なタスク転移を可能にすること、そしてそれがソフトウェアシステムと産業にとってなぜ重要なのかを論じる。
1.5節「よくある誤解を解く」では、理解、知能、記憶、推論をめぐる誤解を取り上げる。これらの誤解を早い段階で解いておけば、のちの技術的な議論での混乱を防げる。
まずは用語そのものから見ていこう。
1.1 「LLM」が意味するもの
LLM は Large Language Model の略で、日本語では「大規模言語モデル」と訳される。一見すると内容を表した言葉のようだが、中身はあいまいだ。正確に理解するには、「大規模」「言語」「モデル」の各語を注意深く見ていく必要がある。
かみくだいて言うと
LLM は Large Language Model(大規模言語モデル)の略です。「大規模」とは、システムが内部に数十億もの設定値(パラメータと呼ばれます)を持っていることを指し、最大級のシステムでは1兆を超えます。「言語」とは、テキストを扱うということです。「モデル」とは、学習によって作られた「推測する仕組み」であり、データベースでも人間でもないということです。まとめると、LLM とはテキストについての巨大な推測の仕組みです。
「大規模(Large)」が指しているのは、主に規模である。現代のシステムでは、規模は互いに結びついた3つの側面に現れる。パラメータの数、学習データセットの大きさ、そして学習に使われる計算資源である。パラメータとは、ニューラルネットワーク内部の数値の重みのことだ。
パラメータは、入力の信号が計算の層を通り抜けるときに、どう変換されるかを決める。モデルが数十億のパラメータを持つというのは、データから学習された調整可能な数値を数十億個含んでいるということだ。パラメータの数を増やせば、ネットワークはより複雑な関数を表現できるようになる。ただしそれは、十分なデータと計算に支えられている場合に限られる。したがって「大規模」とは単なる大きさの話ではなく、モデルの容量、データ量、学習基盤を足並みをそろえて拡大することを表している。パラメータ数という数字も、以前ほど単純ではなくなった。最先端のシステムでいまや一般的になった混合エキスパート(MoE)モデルでは、各トークンを処理するのはネットワークのごく一部だけだ。そのため、総パラメータ数が数千億、ときには1兆を超えていても、1つのトークンに使うのは数百億程度ということがある。モデルを比べるときには、その数字が総パラメータ数なのか、実際に使われるアクティブパラメータ数なのかが重要になる。この区別は11.1節で詳しく扱う。
「言語(Language)」は、モデルが扱う領域を示している。言語モデルは、人間の言語を表すトークンの系列を処理する。トークンとは、テキストを区切った離散的な単位で、単語、単語の断片、あるいは句読点のこともあり、数値の識別子(ID)に変換されている。モデルは文字や単語を直接「見て」いるわけではない。見ているのは、トークンに対応する整数の並びである。現在の多くのモデルは同じ考え方をテキスト以外にも広げ、画像、音声などの信号をトークンに似たベクトルに変換して、同じ系列に入れている。この発展については7.5節と11.3節で改めて取り上げる。
言語モデルの仕事は、それまでのトークンが与えられたときに、次のトークンの確率を推定することだ。人間の知識は、文書、会話、コードのリポジトリといったテキストの形で記録されている。そのため、言語を統計的にモデル化できるシステムは、推論、構造、コミュニケーションのパターンに間接的に触れることになる。
「モデル(Model)」という語は、これが数学的な構成物であることを強調している。モデルとは、ある関数を近似するものだ。LLM の場合、その関数はトークンの系列を、次に来うるトークンの確率分布へと対応づける。従来の意味でのデータベースのように、事実を項目として保存しているわけではない。学習の過程で得たパターンを、分散した数値表現の形で符号化している。テキストを生成するときには、学習した確率分布からサンプリングを行う。その結果として出てくるのは、学習データと統計的に整合し、さらに指示チューニングや選好最適化といった事後学習の段階によって形を整えられた系列である。
3つの語を合わせると、大規模言語モデルとは、膨大なテキストコーパスで学習し、トークン系列の確率を推定する、大容量のニューラルネットワークだということになる。質問に答える、文書を要約する、コードを生成するといった一見した能力は、この確率的な予測という目的が大規模に働いた結果である。
この考え方がどのように発展してきたのか、そしてなぜ以前の手法では同じような柔軟性を実現できなかったのかを理解するには、現代の LLM に先立つシステムを見る必要がある。次の1.2節「言語モデルの歴史」で、その発展をたどる。
1.2 言語モデルの歴史
大規模言語モデルがなぜ今日のような姿をしているのかを理解するには、ここに至るまでの道のりをたどるとよい。現代のシステムは、完成した姿で突然現れたわけではない。言語をどう表現し、どう予測するかをめぐる数十年にわたる試行錯誤の成果である。
かみくだいて言うと
コンピュータは何十年ものあいだ、人の手で書いた文法規則を使うか、本の中で単語の組み合わせが何回現れるかを数えるかして、言語を扱ってきました。現代の LLM はその次の段階です。規則や回数に頼る代わりに、大量のテキストを読むことで、そこからパターンを直接学びます。考え方そのものは昔からあります。新しいのは、その規模と、システムの学習のさせ方です。
言語を計算機で扱う初期の手法は、数えることに大きく頼っていた。とりわけ大きな影響を与えた考え方のひとつが、n-gram モデルである。n-gram とは、連続する n 個のトークンの並びのことだ。たとえばバイグラムモデル(n = 2)では、ある単語の確率は直前の1語だけで決まる。トライグラムモデルでは、直前の2語で決まる。これらのモデルは、大規模なコーパスの中で特定の並びが何回現れるかを数えることで確率を推定する。「機械学習」という言葉がひんぱんに現れるなら、モデルは「機械」の次に「学習」が来る確率を高く見積もる。
n-gram モデルは単純で解釈しやすく、当時としては効果的だった。初期の音声認識システムや機械翻訳のパイプラインを支えていたのも、このモデルである。しかし、根本的な限界を抱えていた。データのスパース性(疎らさ)の問題である。より長い文脈を捉えようと n を大きくすると、ありうるトークンの組み合わせの数は指数関数的に増えていく。
非常に大きなデータセットでも、ありうる並びの大半はカバーできない。その結果、もっともらしい並びの多くがほとんど、あるいはまったく現れず、確率の推定が当てにならなくなる。この問題を和らげるためにスムージングなどの手法が導入されたが、根本的な限界は残った。
次の大きな転換は、ニューラル言語モデルとともに訪れた。研究者たちは、単語を互いに無関係な記号として表すのをやめ、ベクトル、つまり意味の関係を符号化した数値の並びとして表すようになった。こうした分散表現では、意味の似た単語は高次元空間の中で近い位置を占める。これにより、モデルは単語の完全な一致を超えて汎化できるようになった。ある並びが一度も現れたことがなくても、単語どうしの類似性をもとに、その並びのもっともらしさを推し量れるのである。
再帰型ニューラルネットワーク(RNN)は、さらなる前進をもたらした。n-gram モデルは固定された長さの文脈しか見ないが、RNN はトークンを1つずつ処理しながら、情報を先へと運ぶ隠れ状態を保持する。これにより、テキストのより長い範囲にわたる依存関係をモデル化できるようになった。長短期記憶(LSTM)ネットワークなどの派生形は、長い系列にわたって情報を保持する能力を高めた。一時期は、これらのアーキテクチャが最先端を担っていた。
それでも、RNN にもとづくシステムは非常に長い文脈を苦手とし、大規模に効率よく学習させるのも難しかった。逐次的に処理する性質のせいで並列計算がしにくく、学習中にパラメータを更新するための信号である勾配は、長い系列をたどるうちに弱まってしまうことが多かった。こうした課題が、新しいアーキテクチャの発想が入り込む余地を生んだ。のちに Transformer の基盤となる自己注意である。
2017年に登場した Transformer は、再帰を自己注意に置き換え、学習時に系列のすべての位置を並列に処理できるようにした。その後の数年で、いまも使われている型が確立した。まず1つの大きな Transformer を、次トークン予測という目的で幅広いテキストを使って事前学習する。次に、指示チューニングと選好最適化によって、依頼に役立つ形で応えられるように適応させる、という型である。さらに最近では、数学やプログラミングの課題のように答えを自動で確かめられる問題を使って、強化学習による追加の学習を行うようになった。これによって、答える前に長い中間ステップを生成する推論モデルが生まれている。疎な混合エキスパート層、はるかに長いコンテキストウィンドウ、テキスト以外の入力も一般的になった。どの変化も中核となる目的は変えていない。それぞれが変えたのは、その目的からモデルがどれだけ多くを学べるか、あるいはその予測をどう活用するかである。
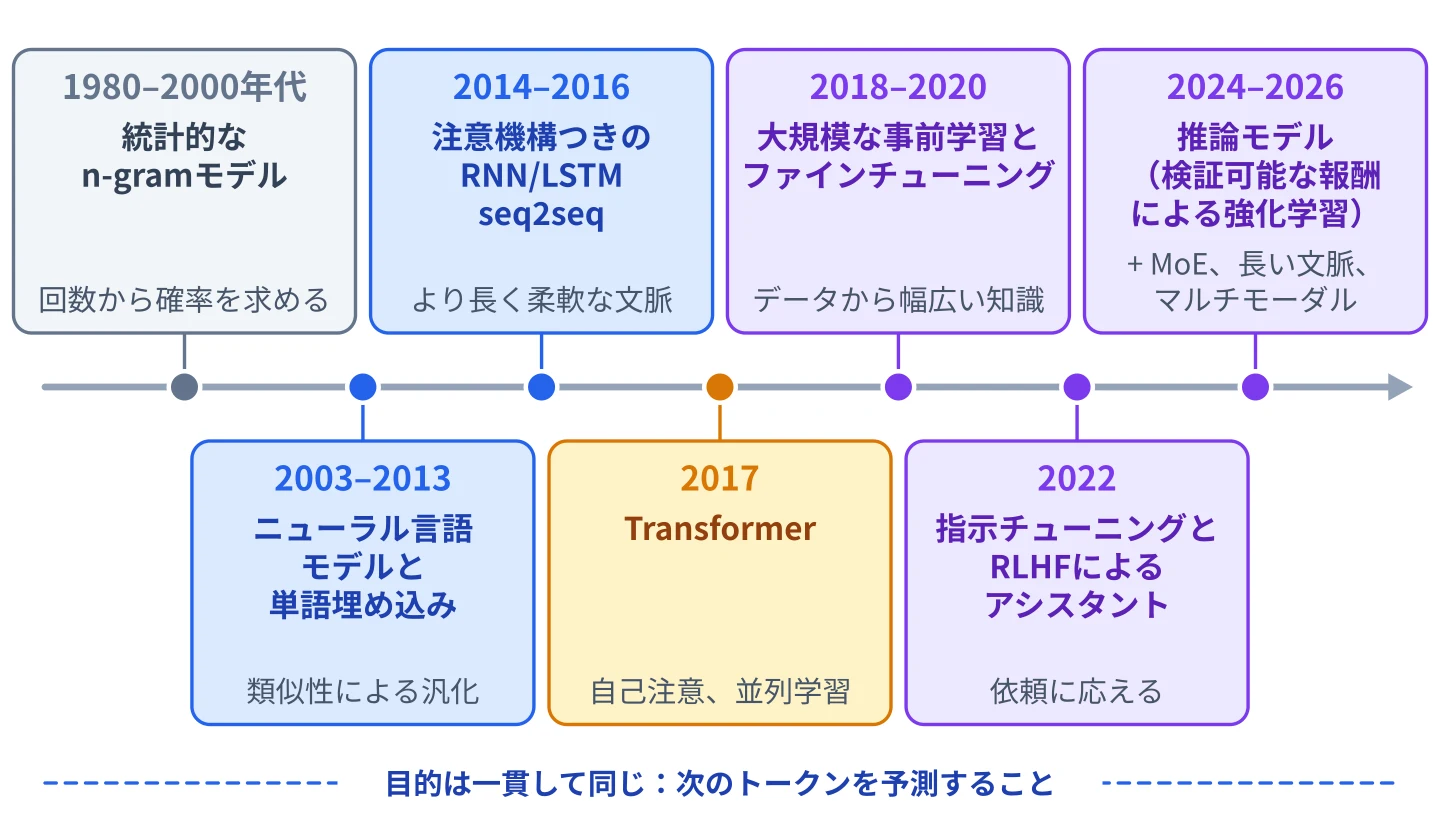
言語モデルの歴史とは、つまり柔軟性と規模を高めてきた歴史である。出現頻度の集計から分散表現へ、固定された窓から系列を捉えるニューラルネットワークへと、どの段階も、より多くの文脈を捉え、データからよりよく汎化することを目指してきた。大規模言語モデルはこの系譜の上に立ち、確率的なモデリング、ベクトル表現、規模を拡大できるニューラルアーキテクチャを1つのシステムに統合している。
この発展を可能にした考え方の転換を十分に理解するには、さらにさかのぼって、明示的なルールにもとづくシステムからデータにもとづく統計的手法への移行を見ておく必要がある。それが次の1.3節「ルールベースから統計モデルへ」のテーマである。
1.3 ルールベースから統計モデルへ
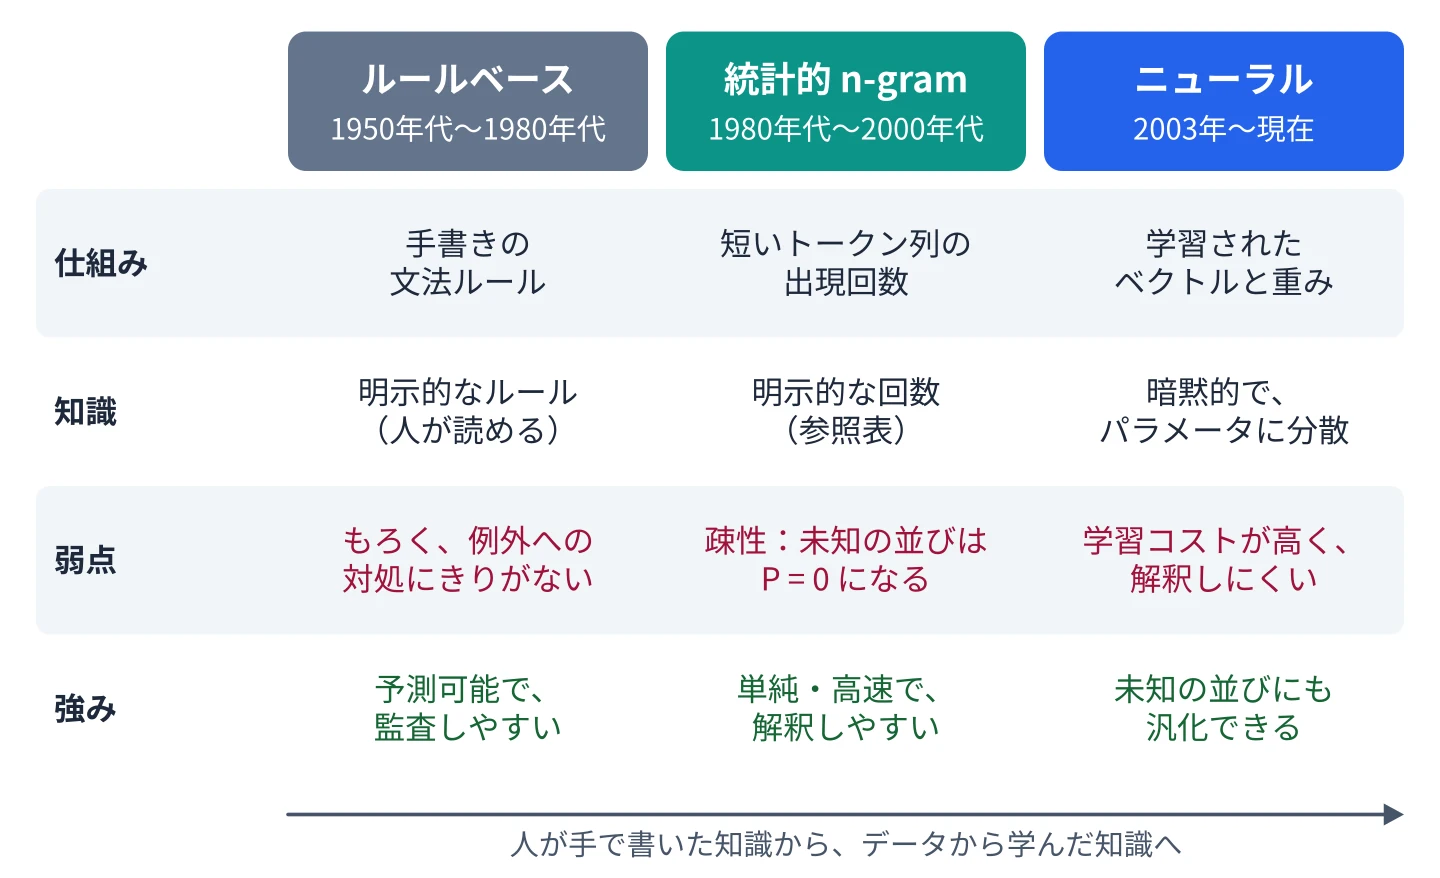
確率分布とニューラルネットワークが言語処理の中心になる前は、多くのシステムが明示的なルールに頼っていた。エンジニアや言語学者は、文法、構文、分野の知識をソフトウェアに直接書き込もうとした。ルールベースのシステムには、たとえば「文に X と Y がこの順序で含まれていれば、Z と解釈する」といった、人の手で作ったパターンが含まれていた。こうした手法は、狭い分野の中では正確であることが多かった。帳票の処理や決まった形式のコマンドを受け付けるシステムのように、条件が管理された環境では、安定して動いた。
かみくだいて言うと
古いやり方は、すべてのレシピを手書きした料理本のようなものだと考えてください。正確ですが、融通がききません。新しいやり方は、100万回の食事を味わい、その経験からパターンを身につけた料理人に近いものです。料理本も料理人も、何もかも正しいわけではありません。けれども料理人は、初めての状況にも応用がききます。
限界は、規模を広げられないことにあった。人間の言語はあいまいで、文脈に左右され、たえず変化する。あらゆる文法上の変種、慣用表現、例外を固定されたルールの集合で捉えようとすると、すぐに手に負えなくなる。新しい特殊なケースが出てくるたびに、ロジックを追加しなければならない。システムは複雑になっていくが、それで頑健になるとは限らない。保守には費用がかさみ、汎化する力は弱いままだ。ルールベースのモデルは、言われたことを言われたとおりに実行し、それ以上のことはしない。
統計的なモデリングへの移行は、言語処理の基本的な考え方を変えた。ルールを手作業で書き込む代わりに、研究者たちは、システムがデータから直接パターンを学べないか、と問い始めた。統計モデルでは、振る舞いを決めるのは明示的な命令ではなく、大規模なコーパスから推定した確率である。文は特定の文法の型に従わなければならない、と定める代わりに、システムは観測された頻度のパターンにもとづいて、どのトークンの並びが起こりやすいかを学ぶ。
この転換がもたらした影響は大きかった。第一に、不確実さを中心的な概念として扱うようになった。文が正しいか誤りかを判定する代わりに、モデルは候補にそれぞれ確率を割り当てる。第二に、汎化が可能になった。見たことのない並びに出会っても、関連するパターンにもとづいて、それなりに妥当な推定ができる。第三に、ボトルネックが、手作業によるルール設計から、データの質と計算能力へと移った。
ルールから統計への移行は、知識の役割も定義し直した。ルールベースのシステムでは、知識は明示的で、人が読んで理解できる。統計的なシステムでは、知識は暗黙的で、学習によって得られたパラメータの中に符号化されている。この違いは、しばしば混乱のもとになる。統計モデルは、データベースと同じ意味で事実を「知って」いるわけではない。膨大なデータセットにわたる相関や構造上の規則性を符号化しているのである。現代の大規模言語モデルはこの考え方を押し広げたものだ。その知識は数十億のパラメータに分散しており、それらが全体として言語の使われ方のパターンを近似している。
この考え方の転換を理解しておくと、大規模言語モデルがなぜあのように振る舞うのかを説明しやすくなる。LLM は、規模からの学習が手作業のルール構築に取って代わった、データ駆動の考え方の到達点である。次の節では、この転換がいま、技術的、経済的、社会的に何を意味するのかを考える。
1.4 なぜ今LLMが重要なのか
人工知能の歴史の多くの局面で、進歩は少しずつ積み重なるものだった。手法が改良され、ベンチマークの数値がわずかに上がり、システムは少しだけ効率的になる。大規模言語モデルがもたらしたのは、それとは種類の違う転換である。LLM が今日重要なのは、幅広い言語タスクを1つの学習目的と1つのアーキテクチャのもとにまとめ、しかも実用上の能力を一変させるほどの規模でそれを実現しているからだ。
かみくだいて言うと
LLM がいま重要なのは、テキストを扱える技術が LLM しかないからではありません。以前なら別々のツールがいくつも必要だった仕事を、1つの汎用的なシステムでこなせるようになったからです。翻訳、要約、コードの下書き、質問への回答、文書の説明。これらはかつて、それぞれ別の製品でした。現代の LLM は、1つでそのすべてをそれなりにうまくこなせます。
第一に、LLM はタスクをまたいだ転移を示す。次のトークンを予測するためだけに事前学習し、そのあと比較的軽い汎用の事後学習を施したモデルが、タスクごとに学習し直さなくても、翻訳、要約、質問応答、コード生成、対話をこなせる。それぞれのタスクのために明示的にプログラムされたからではない。トークン系列の確率をモデル化するという根底の目的が、汎化する構造上の規則性を捉えているからである。
十分に多様なデータで学習すれば、同じ予測の仕組みを新しい文脈に柔軟に応用できる。そのため、問題ごとに別々のモデルを作る必要が少なくなる。
第二に、LLM はソフトウェア開発の経済性を変える。言語そのものがインターフェースになるのである。変換処理のたびに硬直したパイプラインを組み立てる代わりに、開発者は目的を自然言語で記述し、途中の表現はモデルに生成させられる。エンジニアリングの規律が不要になるわけではない。ただ、労力の向け先が、ルールを書き込むことから、入力を整え、データを選び、評価の枠組みを設計することへと移る。抽象化の層が変わり、それに伴って、知的なシステムを作るのに必要な技能も変わる。さらに、検索、コード実行、データベース、業務アプリケーションといった外部のツールをモデルに使わせ、いつ呼び出すかをモデル自身に判断させることも増えてきた。そうしたツールをどう記述し、どう接続するかは、いまでは Model Context Protocol(MCP)のようなオープンなプロトコルで標準化されつつある。こうしたエージェント型のパターンは8.7節で検討する。
第三に、規模の拡大は創発的な振る舞いを生んだ。小さなモデルでは弱かった、あるいは見られなかった能力が、パラメータ数と学習データが増えるにつれて安定して現れるようになる。長い文脈にわたる推論の向上、複数の段落にまたがる一貫した文章の生成、複雑な指示へのより的確な従い方などである。ただし「創発」という言葉は、しばしば大げさに使われる。突然の飛躍に見えるものの多くは、モデル自体の不連続な変化ではなく評価指標の選び方によるもので、より滑らかな指標で測れば、たいていは着実な向上が見えてくる。この点は9.1節で改めて取り上げる。それでも、これらの能力が大規模になって初めて安定するという点に異論はない。だからこそ、規模をどうするかという判断が戦略的に重要になる。
第四に、LLM は知識へのアクセスと統合のしかたに影響を与える。文書をそのまま取り出すのではなく、モデルはユーザーの問いに合わせて、情報をまとめた説明を生成できる。検索システムと組み合わせれば、この能力によって情報との新しい関わり方が生まれる。検索の役割の重心は、リンクの一覧を示すことから、構造化された出力を生成することへと移る。これは教育、企業のシステム、ナレッジマネジメントに影響を及ぼす。
最後に、LLM が重要なのは、新しい能力とともに新しい課題も持ち込むからである。ハルシネーション、バイアス、安全性のためのアライメント、セキュリティ、コストの管理は、脇に置いておける問題ではなく、エンジニアリングの中心的な制約である。プロンプトインジェクションとは、文書、Webページ、ツールの実行結果などに隠された指示によって、モデルの振る舞いが乗っ取られることをいう。これはいまや LLM アプリケーションにとって最大のセキュリティリスクと広く見なされている。その理由はまさに、モデルがコンテキストの中にある信頼できる指示と信頼できないテキストとを確実には区別できないことにある。LLM の重要性は、何ができるかだけにあるのではない。確率的なシステムにおける信頼性、評価、ガバナンスを考え直すよう私たちに迫る点にもある。
ただ、影響力が増すにつれて、誤解も広がっている。理解、知能、自律性についての主張は、技術的な実態をぼやけさせることが多い。本書の残りの部分のために安定した土台を築くには、仕組みとたとえを切り分けておく必要がある。次は1.5節「よくある誤解を解く」に進もう。
1.5 よくある誤解を解く
大規模言語モデルが目に触れる機会が増えるにつれて、それが何であり、どう動くのかについての誤解も目立つようになった。こうした誤解を解くことは、単なる学問上の関心事ではない。これらのシステムについて誤った考え方をすれば、設計も、運用も、評価も誤ったものになる。
かみくだいて言うと
LLM は、人間と同じ意味で理解しているわけではありません。モデル自体は、前回の会話を覚えていません。製品が覚えているように見えるときは、メモを別に保存しておき、それをテキストとしてモデルに入力し直しているのです。LLM は単独では、データベースで事実を調べることもしません。ただし、そうした調べものをする検索ツールにつなぐことはできます。LLM がしているのは、それまでの内容を踏まえて、次に来る可能性がもっとも高いテキストの断片を予測することです。LLM が何を「知って」いて何を「考えて」いるのかをめぐる混乱の多くは、この単純な点を忘れることから生じています。
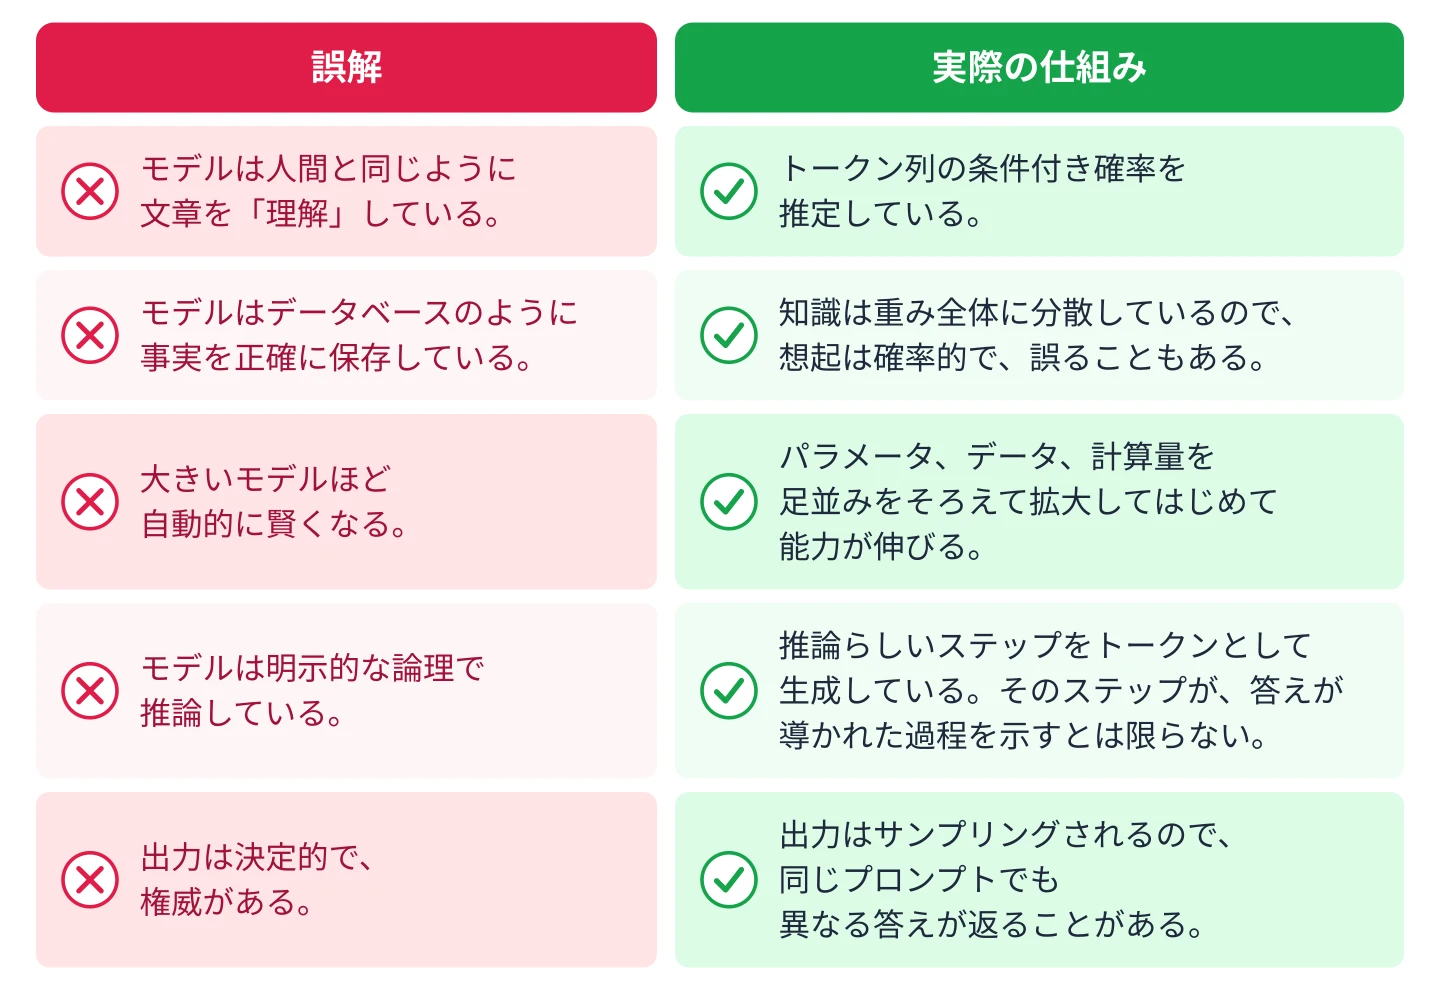
よくある誤解の1つは、LLM が人間と同じように言語を「理解」しているというものだ。モデルが筋の通った説明を出力すると、そこに理解や意図があると考えたくなる。しかし技術的には、モデルはトークン系列についての条件付き確率を推定しているにすぎない。意識も、信念も、内的な目標も持っていない。出力に表れているのはデータから学んだ統計的な規則性であって、意識的な推論ではない。だからといって出力がつまらないものになるわけではない。出力は確率的なものだ、ということである。
もう1つの誤解は、LLM がデータベースのように事実を保存しているというものだ。実際には、情報はパラメータ全体に分散している。特定の事実が置かれている単一の場所は、モデルの中には存在しない。共起のパターンや文脈上の関係が、数値の重みの中に符号化されているのである。これが、モデルの柔軟さと誤りやすさの両方を説明する。モデルは決まった項目を取り出すのではなくパターンから汎化するので、もっともらしいが誤った文を生成することがある。この現象はよくハルシネーションと呼ばれる。学習と評価のやり方がこれを悪化させることもある。ベンチマークが、不確かだと認めることよりも自信たっぷりの当て推量を高く評価すると、モデルは当て推量をするように学んでしまう。この点は10.1節で改めて取り上げる。
3つ目の誤解は、パラメータ数が多ければ自動的に知的になる、というものだ。規模は重要だが、データの質、学習の目的、アーキテクチャと相互に作用する。学習がまずい大きなモデルは、よりよく最適化された小さなモデルに劣ることがある。能力は、パラメータ、データの多様性、計算量を足並みをそろえて拡大することから生まれるのであって、大きさだけから生まれるのではない。
推論をめぐる混乱もある。LLM が何段階にもわたる議論を展開したり、構造のある問題を解いたりすると、記号的に推論しているように見えることがある。しかし実際には、学習データに含まれる推論のパターンに統計的に似た系列を生成しているのである。答える前に長い中間ステップの連なりを生成するよう強化学習で訓練された推論モデルは、この境界を大きく押し広げた。2025年には、この種の実験的なシステムが、自然言語で書かれた国際数学オリンピック(IMO)の問題で金メダル水準の成績に達している。それでも仕組みのうえでは、これは依然としてトークンの生成であり、1つの答えにより多くの計算を費やすようになっただけである(11.5節を参照)。また、目に見える推論の過程が、答えが実際にどう導かれたのかを忠実に反映している保証はない。信頼性を確保するには、いまも多くのタスクで外部ツール、検索システム、あるいは検証が必要になる。この境界を理解しておくことは、システム設計に欠かせない。
最後に、LLM の出力は決定的で、権威あるものだと思われがちだ。実際には、生成の過程ではしばしば確率分布からのサンプリングが行われる。温度(temperature)などのデコーディングのパラメータが、出力のばらつきに影響する。温度をゼロにしても、クラウドで提供されるサービスでは、同じ入力に対してわずかに異なる出力が返ってくることが多い。推論処理の数値的な結果が、サーバー上でリクエストがどうまとめて処理される(バッチ化される)かに左右されることがあるからだ。同じ入力に対する2つの出力が異なりうるのは、モデルが唯一の「正解」を選んでいるのではなく、確率の高い続きの候補の中からサンプリングしているからである。
ポイント:大規模言語モデルは確率的な系列予測器であり、その強みと限界は、この定式化からそのまま導かれる。
誤解が解けたところで、次トークン予測を支える形式的な仕組みを調べる準備が整った。これらのシステムがテキストをどう数値で表し、不確実さをどう定量化するのかを理解するために、第2章「確率、トークン、テキスト」へ進もう。
ポチっとでの実践
ポチっとでは、判断の後にもう一段ある
小型モデルQwen3-0.6Bで「明日の朝9時に、薬を飲むよう知らせて」を分類する実験を行いました。
| 段階 | 「明日9時に知らせて」の例 |
|---|---|
| モデルの出力 | リマインダーの依頼か、別の種類の発言かを分類する |
| アプリの確認 | 何を知らせるか、日時はいつか、進行中の依頼の続きかを確かめる |
| 実行 | ユーザーが確認した内容でリマインダーを登録する |
実験では、16件の入力を4条件で比較しました。64回とも有効なJSONを返しましたが、具体例も文脈も与えない条件では6/16件、両方を与えた条件では14/16件が正解でした。この依頼は、両方を与えても雑談のままでした。この数字は、開発用に用意した16件での結果です。実際の利用全体での正答率を示すものではありません。
日常の頼みごとを安心して任せてもらうには、分類の精度に加えて、必要な条件がそろったか、本人が確認したか、登録が成功したかも確かめる必要があります。小型モデルの研究では、この流れのどこをモデルに任せられるかを一つずつ検証しています。
第2章では、確率とトークンを取り上げます。同じ日本語でも、モデルがどんな単位で読み取り、次の候補を選ぶのかを見ていきます。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る