 Pocchito
第2章 確率、トークン、テキスト
文章がどんな単位に分かれ、どうモデルに渡るのか。日本語の例から、トークンと確率の基本を学びます。
トークン化とは、文章をモデルが扱える単位に分けることです。一つひとつの単位をトークンと呼びます。
図解 日本語の文章がモデルへの入力になるまで
1.文章を入力する
明日、雨が降る↓
2.語彙にある単位に分ける
明日|、|雨|が|降る↓
3.単位を語彙の番号に置き換える
41|7|92|16|305
区切り方と番号は説明用の例です。実際の結果はトークナイザーによって異なります。番号の大小は意味の近さを表しません。
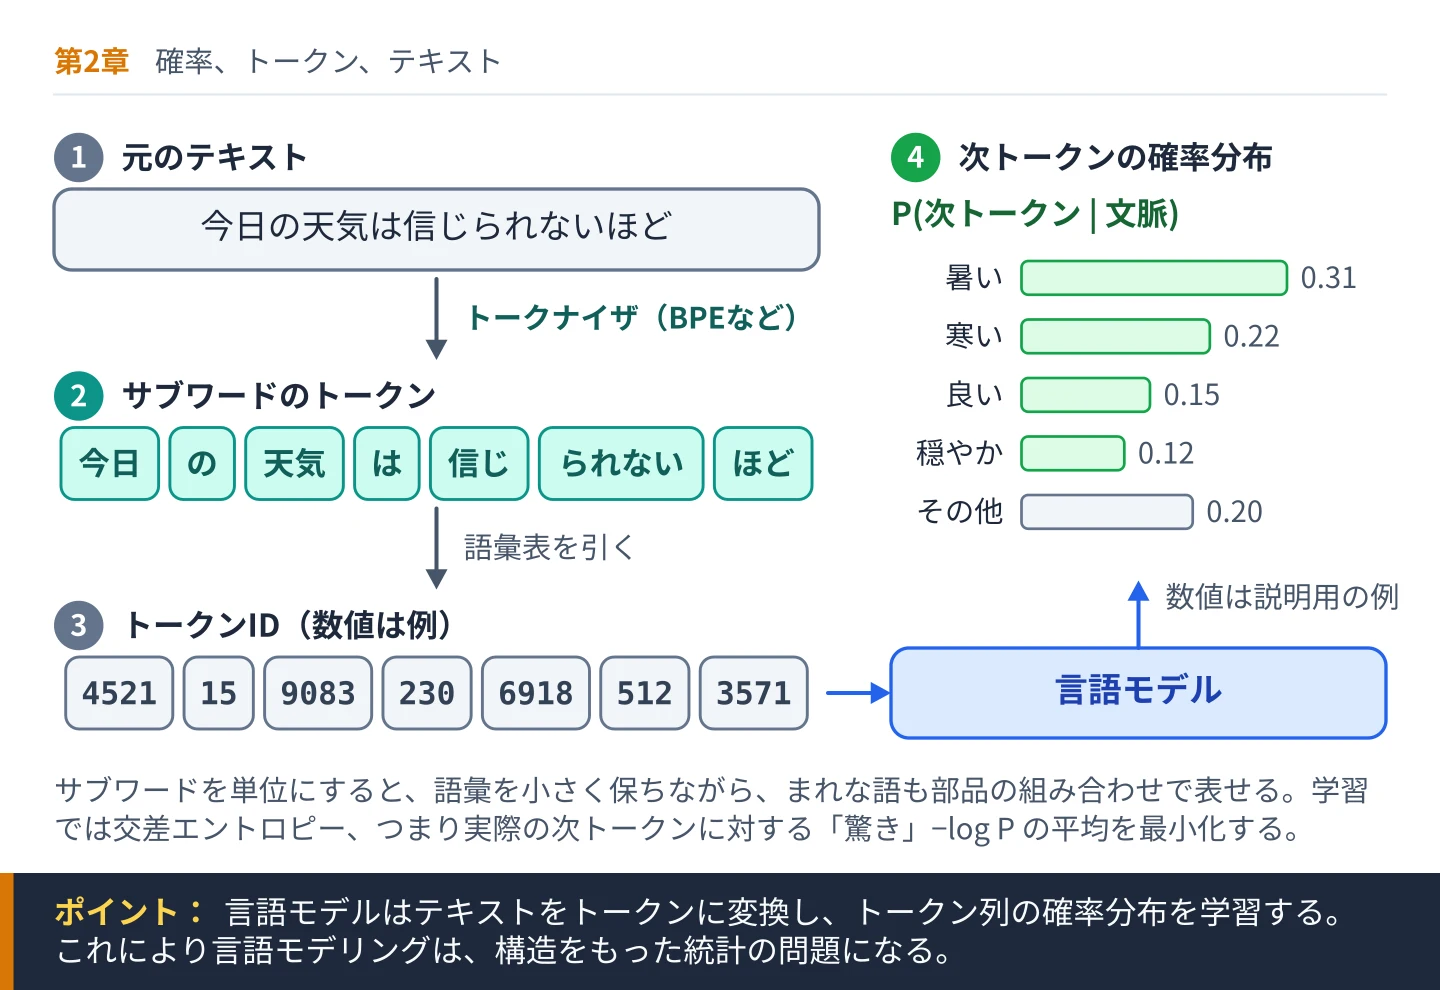
第1章では、大規模言語モデル(LLM)とは何かを定義し、その歴史的な位置づけを確認した。核心だけを取り出せば、LLMは系列の次のトークンを予測するように学習された確率モデルである。第2章では、それを可能にしている数学的な土台と、テキストの表現方法を見ていく。第1章が「何か」に答えたとすれば、第2章は「どうやって」に答える章だ。
本章では、言語を構造化されたデータとしてとらえ直し、予測を確率の言葉で定式化する。まず、人間にとっては意味に満ちたテキストが、モデルに処理される前にどのように離散的な数値の単位へ変換されるのかを確認する。次に、確率論が系列をモデル化するための厳密な枠組みをどう与えるかを見る。最後に、モデルがうまく学習できているかを測る指標を導入する。
2.1「トークン列としてのテキスト」では、自然言語が離散的なトークンの列へ変換される過程を示す。トークン化がなぜ必要なのか、トークンIDが数値の記号としてどう働くのか、そしてモデル化において順序とコンテキスト長がなぜ重要なのかを説明する。
2.2「トークン化:Byte Pair EncodingとWordPiece」では、現代のシステムがサブワードのアルゴリズムでトークンを組み立てる方法を取り上げる。語彙サイズと表現力のバランスをどう取っているのか、トークン化の設計がモデルの性能とコストにどう響くのかを分析する。
2.3「予測タスクとしての言語モデリング」では、条件付き確率を用いて次トークン予測を定式化する。交差エントロピー損失を導入し、学習した確率分布からのサンプリングを繰り返すことで文章の生成が生まれる仕組みを説明する。
2.4「n-gramモデルとニューラルなアプローチ」では、従来の出現回数に基づくモデルとニューラルネットワークを比較する。この比較から、局所的な頻度パターンを記憶する方式から、文脈をまたいで汎化する分散表現を学ぶ方式への転換が浮かび上がる。
2.5「エントロピー、パープレキシティ、評価指標」では、予測の不確実性を測るための情報理論の道具を導入する。流暢さという主観的な印象に頼らず、エントロピーとパープレキシティでモデルの性能を定量化する方法を説明する。
まずは、システム全体でもっとも基本的な変換、つまりテキストをトークン列に変換する処理から始めよう。
2.1 トークン列としてのテキスト
私たちは文を読むとき、そこに意味を読み取る。考えや意図、文の構造だ。言語モデルは違う。モデルにとってのテキストは、まず離散的な数値の単位の列に変換されなければならない。この変換が、大規模言語モデルのあらゆる計算の出発点になる。
かみくだいて言うと
トークンとは、テキストの小さな断片のことだ。よく使われる単語がまるごと1つのトークンになることもあれば、長い単語の一部、たとえばよく現れる接頭辞や接尾辞、文字の並びが1つのトークンになることもある。モデルは何よりも先に、入力された文をトークンに切り分け、それぞれを数値に変換する。モデルから見れば、言語は文字の並びではなく数値の並びなのだ。
基本となる単位はトークンである。トークンは、あらかじめ決まった語彙から取り出される離散的な記号で、それぞれに整数の識別子(ID)が割り当てられている。たとえば「モデルはパターンを学ぶ」という短い文は、[1543, 982, 4417, 305, 2210] のような整数列に変換されるかもしれない。数値そのものは任意の識別子にすぎないが、いったん割り当てれば、モデルは言語を構造化されたデータとして扱えるようになる。
注意したいのは、トークンが必ずしも単語と一致しないことだ。現代のシステムでは、トークンはしばしば単語より小さいサブワードの断片になる。英語の「learning」という単語なら「learn」と「ing」に分かれるかもしれないし、めったに使われない専門用語はさらに細かい部品に分解されるかもしれない。この柔軟さのおかげで、ありうる単語をすべて個別の項目として持たなくても、膨大な語彙を表現できる。日本語でも同様に、「機械学習」が「機械」と「学習」に分かれるといったことが起きる。
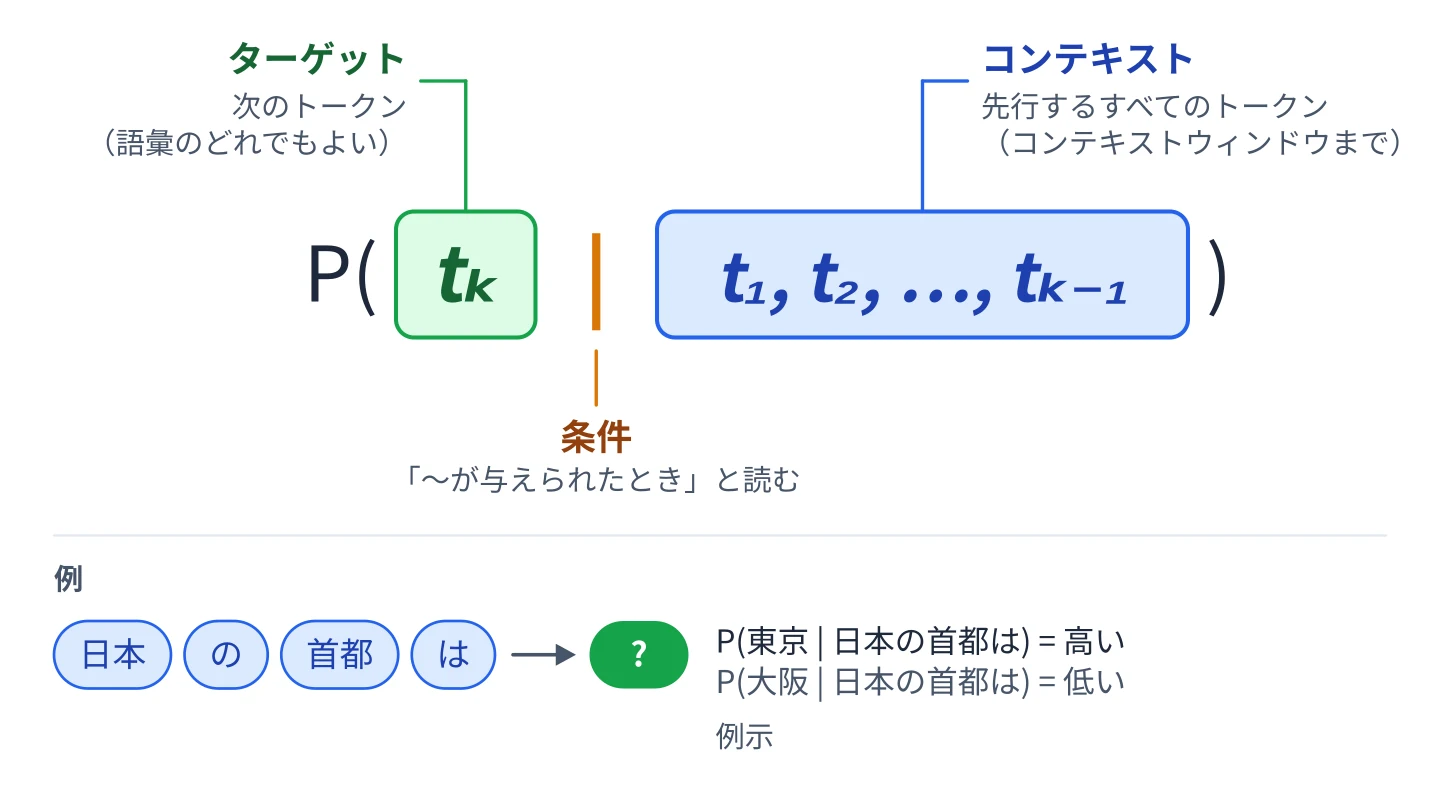
トークン化が済むと、テキストは系列になる。すると言語モデリングは、整数の系列に対する操作として定式化できる。トークンを t_{1},t_{2},t_{3},…,t_{n} と表すと、モデルの仕事は、それまでのトークンを条件として各トークンの確率を推定することだ。つまり P(t_k | t_1, t_2, ..., t_{k-1}) を近似しようとする。文書全体が、条件付き予測の連鎖として表されることになる。
この系列としての見方には、重要な含意が2つある。第一に、順序が意味を持つ。「犬が人をかんだ」と「人が犬をかんだ」は同じトークンを含むが、意味はまったく違う。したがってモデルは、トークンが何であるかだけでなく、どの位置にあるかという情報もとらえる必要がある。第二に、コンテキストの長さは有限である。言語は原理的にはいくらでも続けられるが、実際のモデルが処理できる系列の長さには、決まったトークン数の上限がある。この上限によって、次のトークンを予測するときにどれだけ前の情報まで考慮できるかが決まる。
トークン列は、時系列データに似たものと考えるとわかりやすい。各トークンはそれ以前のトークンに依存し、モデルはさまざまな長さの文脈にまたがるパターンを学ばなければならない。ただし数値の時系列と違って、トークンは離散的な記号のカテゴリを表す。数学的に扱えるようにするため、モデルはこれらの整数IDをベクトル表現、つまり高次元空間の数値のリストに変換する。このベクトルが、トークン同士の意味的・構文的な関係をとらえる。
テキストがトークンで表されるとわかると、自然に次の疑問がわく。トークンは具体的にどう定義され、どこからどこまでを1つのトークンとするのかは、どう決めるのか。この問いに答えるため、2.2節「トークン化:Byte Pair EncodingとWordPiece」に進もう。
2.2 トークン化:Byte Pair EncodingとWordPiece
モデルが処理する前にテキストをトークンに変換しなければならないとすると、次の問いは単純だが決定的に重要になる。そのトークンをどう選ぶのか。空白で区切って単語ごとに分けるのが自然に思えるが、この方法はすぐに効率が悪くなる。複数形や動詞の活用形、複合語、分野ごとの専門用語まで含めると、自然言語には数十万もの異なる単語がある。それぞれを別のトークンにすれば語彙は膨大になり、しかも見たことのない単語にはうまく対処できない。そもそも日本語は単語の間を空白で区切らない(分かち書きをしない)ので、空白による分割はそのままでは使えない。
かみくだいて言うと
モデルが持つトークンの語彙は決まっていて、数に限りのあるLEGOブロックのセットのようなものだ。よく使う単語は、それぞれ1個のブロックになる。あまり使わない単語は、小さなブロックを組み合わせて作る。段落の長さやコストが単語数ではなくトークン数で測られるのはこのためであり、同じ内容の文でも言語によって必要なトークン数が多くなるのもこのためだ。日本語は、多くのトークナイザで英語よりトークン数が増えやすい言語の1つである。
現代の言語モデルは、この問題をサブワードトークン化で解決している。単語ごとに固有のトークンを割り当てるのではなく、よく現れる文字の並びを表すトークンを組み立てるのだ。広く使われている方式に、Byte Pair Encoding(BPE)とWordPieceがある。どちらも、語彙サイズと表現力のバランスを取ることを狙っている。
Byte Pair Encodingの中心にあるのは、繰り返しの併合(マージ)という考え方だ。アルゴリズムは、個々の文字だけからなる語彙から出発する。次に大規模なコーパスを走査し、隣り合う記号のペアのうちもっとも頻繁に現れるものを見つけ、そのペアを新しい1つのトークンにまとめる。これを繰り返し、各ステップでもっとも頻度の高い隣接ペアを1つのトークンに統合していく。
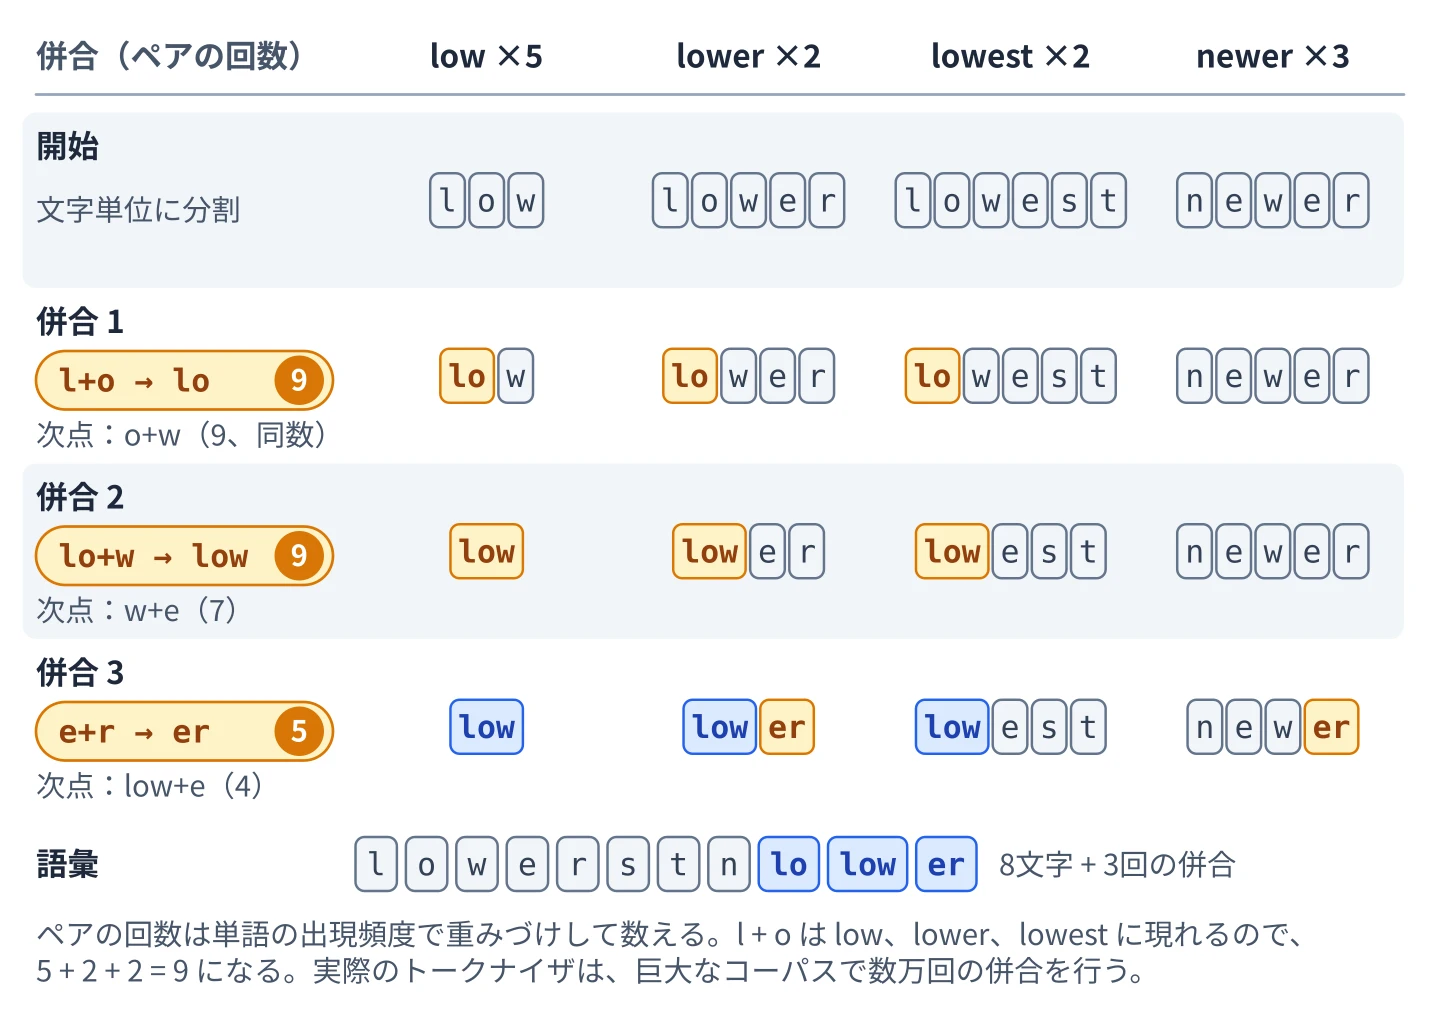
この過程を続けると、「th」や「ing」のような頻出パターン、さらには「model」のような単語全体が単一のトークンになり、まれな単語は小さな部品に分解されたまま残る。その結果、語彙が爆発的に大きくならないまま、よく現れる構造を効率よくとらえた語彙ができあがる。日本語のテキストで学習すれば、「です」や「ます」、よく使う熟語などが同じようにひとまとまりのトークンになりやすい。
WordPieceも似た原理で動くが、併合の基準が生の出現頻度ではなく尤度である。言語モデリングの目的関数のもとで、学習データの確率を最大にするサブワード単位を選ぶ。実際には、どちらの方式も似たふるまいをする。よく使う単語は単一のトークンになり、まれな単語や新しい単語は意味のある部品に分割される。たとえば「tokenization」のようなまれな語は「token」「##iza」「##tion」と表されるかもしれない。ここで「##」は単語の途中から続く断片を示し、接頭辞や接尾辞は多くの単語で使い回される。日本語向けのBERTでは、まずMeCabなどの形態素解析器で単語に区切り、そのうえでWordPieceを適用する構成も使われてきた。
この設計にはいくつかの利点がある。第一に、語彙サイズを抑えながら、幅広いテキストを表現できる。第二に、見たことのない単語でも、既知のサブワードを組み合わせて扱える。第三に、意味上の規則性が保たれる。関連する単語はサブワードの部品を共有することが多く、それが埋め込み空間での汎化を助ける。
一方で、トークン化はトレードオフも持ち込む。トークナイザが違えば、同じテキストでもトークン数が変わり、メモリ使用量や推論処理のコストに影響する。LLMの料金体系やコンテキストの上限の多くは、文字数や単語数ではなくトークン数で定められているため、トークナイザの選択はシステムのふるまいとコスト効率を直接左右する。さらに、トークンの境界は、意味がベクトルにどう配分されるかにも影響する。設計のまずいトークン化は、有用なパターンを分断したり、重要な区別を圧縮しすぎたりしかねない。語彙サイズが大きくなってきたのも、こうした理由による。初期のモデルの語彙はおよそ3万〜5万トークンだったが、現在の多くのモデルは12万8,000から25万以上のトークンを持つ。埋め込みの表が大きくなる代わりに系列を短くできるからで、その効果は英語以外のテキストやコードで特に大きい。日本語はこの影響を強く受ける言語の1つだ。UTF-8ではひらがなや漢字の多くが1文字3バイトで表されるため、日本語をあまり学習していないバイトレベルのトークナイザでは、1文字が1トークン以上に分かれることも珍しくない。同じ内容を訳した文でも、言語によってトークン数に最大で15倍ほどの差が出るという報告もある(Petrovら、2023年)。語彙を日本語向けに拡張すれば改善できる。たとえば東京工業大学などが開発したSwallowでは、Llama 2のトークナイザに日本語のトークンを約1万6,000個追加し、日本語テキストのトークン長を元の56.2%まで縮めた。日本語でLLMを使うときは、同じ文章量でも料金とコンテキストの消費が英語より大きくなりうることを念頭に置いておくとよい。
テキストを明確に定義されたトークン列として表せるようになったので、学習を駆動する中心的なタスクを定式化できる。次節では、表現の話から目的の話へと移り、2.3節「予測タスクとしての言語モデリング」を見ていく。
表2.1 主なトークン化手法
| 手法 | 仕組み | 主な採用例 |
|---|---|---|
| Byte Pair Encoding(BPE) | 目標の語彙サイズに達するまで、もっとも頻繁に現れる隣接記号ペアを繰り返し併合する。 | 初期のGPTモデルと、その流れをくむ多くのオープンソースモデル。実際には下のバイトレベル版にほぼ置き換えられている |
| WordPiece | BPEに似ているが、単純な頻度ではなく学習コーパスの尤度を最大にするペアを併合する。 | BERTと、その流れをくむ多くのエンコーダ専用モデル |
| Unigram/SentencePiece | トークン化を確率的な推論の問題として扱い、ユニグラム言語モデルのもとでコーパスの尤度が最大になるように候補の断片を絞り込む(SentencePieceはこの手法を広めたライブラリで、BPEも実装している)。SentencePieceは事前の単語分割を必要とせず生の文から直接学習できるため、分かち書きのない日本語でも扱いやすい。 | T5、いくつかの多言語モデル |
| バイトレベルBPE | Unicodeの文字ではなく生のバイト列を単位に処理するため、語彙にないトークン(未知語)がなくなり、多言語の扱いも単純になる。 | GPT-2とその後継、現在の多くのオープンウェイトモデル |
| 文字レベル | 1文字を1トークンとする。単純で頑健だが系列がずっと長くなり、注意機構の計算コストが増える。 | 実用のLLMではほとんど使われない。一部の研究用システムで使われる程度 |
2.3 予測タスクとしての言語モデリング
テキストをトークン列に変換できたので、言語モデリングの中心的な問題を正確に述べられるようになった。トークン列 t_{1},t_{2},t_{3},…,t_{k-1} が与えられたとき、モデルは次に来うるトークン t_{k} についての確率分布を推定しなければならない。簡潔に書けば、目的は条件付き確率 P(t_k | t_1, t_2, ..., t_{k-1}) を近似することだ。質問に答える、長い文章を書く、コードを書く。大規模言語モデルが行うことはすべて、この予測ステップを繰り返し適用するところから生まれる。
かみくだいて言うと
モデルの仕事は、各ステップで次のトークンを当てること、ただそれだけだ。ほかには何もしない。文章を書く、質問に答える、コードを生成するといったモデルのあらゆる能力は、この1つの作業を小さな断片ごとに何度も何度も、きわめて上手に繰り返すことから生まれている。
一見すると、次のトークンを予測するのは簡単なことに思えるかもしれない。だが、それが何を求めているかを考えてみよう。たとえば文脈が「日本の首都は」だとする。モデルは「東京」に高い確率を、無関係なトークンには低い確率を割り当てなければならない。文脈が「この関数は、要素を昇順に並べた」なら、「リスト」や「配列」といったプログラミングの用語が続くと予測できなければならない。
正確に予測するには、文法、事実、慣用表現、分野固有の知識、そして離れた位置にある語どうしの依存関係まで、モデルが内部に取り込んでいる必要がある。次トークン予測は狭いタスクではない。言語の構造を確率の形に圧縮したものなのだ。
形式的には、長さ n の系列全体の確率は、確率の連鎖律を使って P(t_1, t_2, ..., t_n) = P(t_1) × P(t_2 | t_1) × P(t_3 | t_1, t_2) × ... × P(t_n | t_1, ..., t_{n-1}) と分解できる。システムは同時確率を直接モデル化するのではなく、条件付きの各ステップをモデル化する。学習中は、大規模なコーパスから取り出した多数の系列をモデルに見せ、各位置で実際に来る次のトークンに割り当てる確率が高くなるように最適化する。
最適化には損失関数を使う。一般的なのは交差エントロピー損失だ。直感的には、交差エントロピーはモデルの予測分布が真の分布からどれだけ離れているかを測る。真の分布では、実際の次トークンの確率が1、ほかのトークンはすべて0とみなす。モデルが正しいトークンに高い確率を割り当てれば損失は小さく、低い確率しか割り当てなければ損失は大きい。学習では、何兆ものトークン位置にわたってこの損失が小さくなるように、モデルのパラメータを調整する。現在の大規模モデルは、15兆トークン以上で事前学習されるのが普通になっている。
大事な点がある。モデルは学習中に、もっとも確率の高い次のトークンを1つ選ぶことを学ぶのではない。語彙全体にわたる確率分布を丸ごと学ぶ。推論時には、そこからさまざまなデコーディング戦略を適用できる。貪欲デコーディングは、各ステップでもっとも確率の高いトークンを選ぶ。サンプリングは、分布から確率的に取り出すことでランダム性を持ち込む。温度スケーリングは分布の鋭さや平坦さを変え、創造性と決定性のあいだの度合いを調整する。top-kやtop-p(nucleus)サンプリングのような切り詰めの手法はさらに進んで、サンプリングの対象を確率の高いトークンに限定し、ありそうにないトークンが延々と並ぶ裾の部分から選ばれないようにする。これらのデコーディング戦略はモデルそのものを変えるわけではない。学習した確率をどう使うかを決めているだけだ。
もう1つの重要な要素がコンテキストである。原理的には、条件付き確率は先行する系列全体に依存する。しかし実際には、モデルは決まった最大長のコンテキストウィンドウで学習される。たとえばウィンドウが12万8,000トークンなら、位置 k の予測は直前の12万8,000トークンにしか依存できない。2026年の時点では数十万トークンのコンテキストウィンドウはごく普通になっており、最先端のモデルの多くは100万トークン前後かそれ以上を受け付ける。第1世代の大規模言語モデルが数千トークンのウィンドウしか持たなかったことを考えると、大きな変化だ。ただし、これほど大きくなってもウィンドウは有限であり、その上限のあり方は、能力やコスト、非常に長い入力に対する注意の質に影響し続けている。理論上使えるコンテキストと、実際に有効に使えるコンテキストが一致することはまれなのだ。
言語モデリングを圧縮としてとらえる見方も役に立つ。モデルが正しい次のトークンに高い確率を割り当てられるなら、データの規則性を実質的にとらえていることになる。完全に予測できる系列はほとんど情報を含まず、非常に意外なトークンほど多くの情報を運ぶ。したがって、予測誤差を減らすことは、言語構造についての不確実性を減らすことと密接に結びついている。
現代のニューラルなアプローチが以前の統計的な手法とどう違うのかを理解するため、次は世代の異なるモデルでこの確率的な枠組みを比べてみよう。2.4節「n-gramモデルとニューラルなアプローチ」である。
2.4 n-gramモデルとニューラルなアプローチ
言語モデリングを次トークン予測として定式化したので、必要な条件付き確率を推定する、根本的に異なる2つの方法を比べられるようになった。出現回数に基づくn-gramモデルと、ニューラルネットワークに基づくモデルである。どちらも P(t_k | t_1, …, t_{k-1}) を近似しようとするが、文脈の表し方とデータからの汎化のしかたが大きく異なる。
かみくだいて言うと
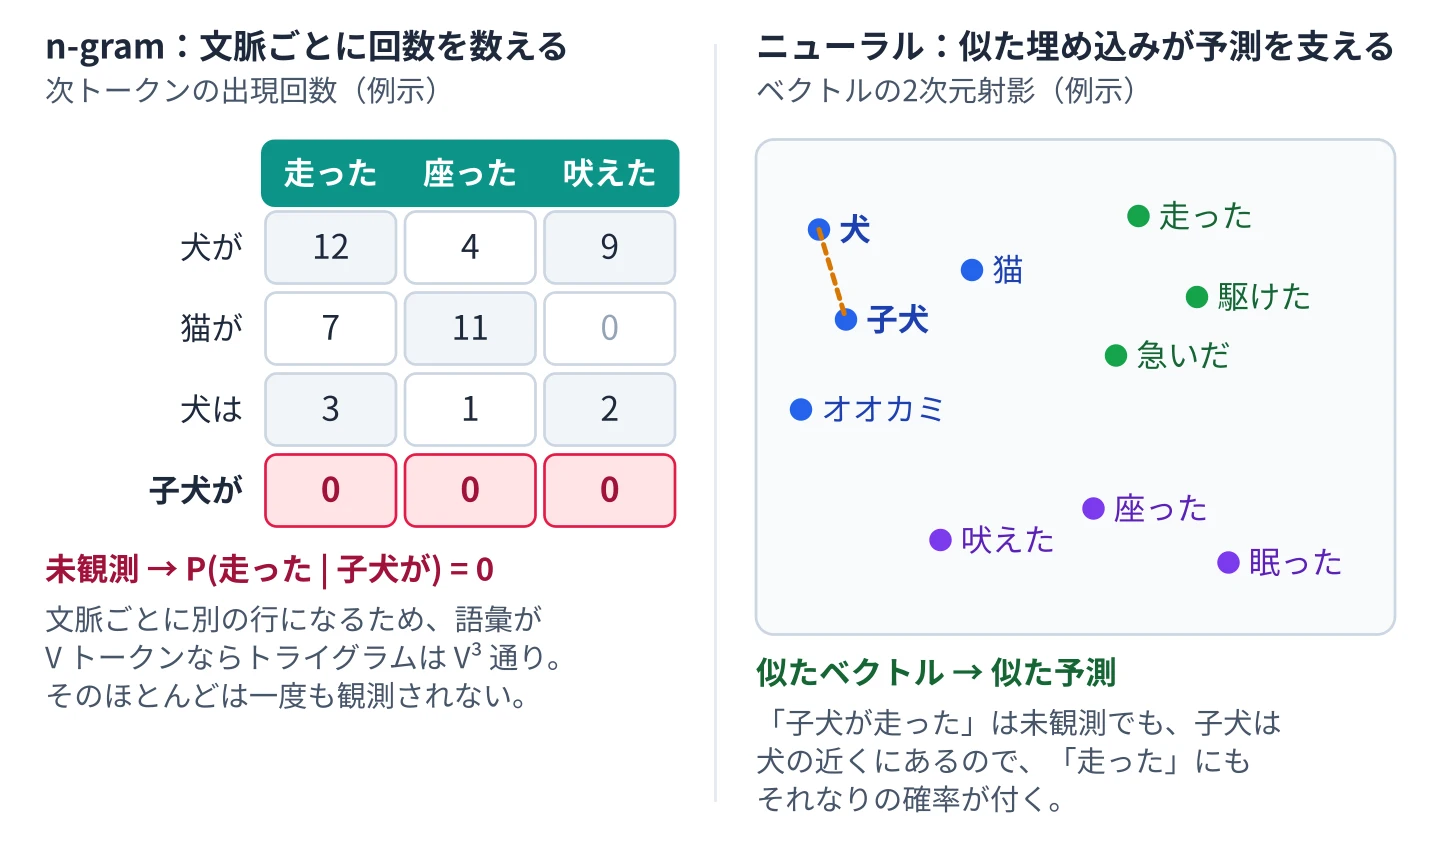
古いやり方は、それまでに見たことのある短いフレーズをすべて覚えておき、次に来そうな語を表で引くというものだった。新しいやり方は、言語がどう働くかについての一般的なパターンを学ぶので、一度も見たことのないフレーズにも対応できる。古いやり方は記憶の量に縛られ、新しいやり方は汎化する。
n-gramモデルは、マルコフ仮定と呼ばれる単純化を置く。次のトークンの確率は、直前の n−1 個のトークンだけで決まるという仮定だ。たとえばトライグラム(3-gram)モデルでは、P(t_k | t_1, …, t_{k-1}) を P(t_k | t_{k-2}, t_{k-1}) で近似する。そしてこの確率を、学習コーパスで各トライグラムが現れた回数を数え、直前2トークンの組(バイグラム)の出現回数で割って推定する。「機械」「学習」「モデル」という並びがよく現れるなら、「機械」「学習」のあとに「モデル」が来る確率は高くなる。
この方法は概念的にわかりやすく、n が小さければ計算効率もよい。しかし、構造的な限界にぶつかる。第一に、ありうるn-gramの数は、文脈の長さに対して指数的に増える。語彙が V トークンなら、ありうるn-gramは V^n 個あり、5万トークンの語彙でもトライグラムの候補は10^14個(100兆)を超える。大規模なコーパスを使っても、ありうる系列のほとんどは一度も現れないため、もっともらしいのにたまたま見たことのない組み合わせの確率が0になってしまう。ラプラススムージングやKneser–Neyスムージングのような平滑化の手法は、確率の一部を未観測の事象に配り直すが、データの疎性の問題を完全には解決できない。
第二に、n-gramモデルは各トークンを内部構造のない離散的な記号として扱う。「走る」と「走った」は、まったく同じ形がたまたま似た文脈に現れない限り、無関係なものとして扱われる。頻度のパターンが共通していること以外に、トークン同士の類似性という概念がないのだ。これが汎化を制限する。見たことのない系列に対しては、推定の拠り所がほとんどない。
ニューラル言語モデルは、分散表現によってこうした限界に対処する。各トークンを、出現回数を記録した巨大な参照表の中の別々の記号として表すのではなく、連続的なベクトル空間に埋め込む。埋め込み(エンベディング)とは、学習を通じて獲得した意味的・構文的な性質を符号化した実数のベクトルである。
似た文脈に現れる単語は、似たベクトルを持つ傾向がある。これによってモデルは汎化できる。ある系列そのものは一度も現れたことがなくても、その構成要素は埋め込み空間で近い領域にあるかもしれず、それを手がかりに妥当な確率を推定できるのだ。
ニューラルモデルでは、文脈はトークンを決まった個数だけ並べた組として保存されるわけではない。文脈は何層もの計算を経て隠れ表現、つまり先行するトークンについての情報をとらえた高次元のベクトルに変換される。モデルはこの表現を最終の射影層に通し、さらにsoftmax関数を適用して、語彙全体にわたる確率分布を計算する。softmax関数は、生のスコアを合計が1になる確率に変換する関数である。
ニューラルなアプローチの大きな利点は、パラメータの共有にある。n-gramモデルでは、文脈の組み合わせごとに別々の確率推定が必要になる。ニューラルモデルでは、同じパラメータが多くの文脈で再利用される。この共有があるので、モデルは孤立した系列を丸暗記するのではなく、広く当てはまるパターンを学べる。スケールも可能になる。パラメータ数と学習データを増やしていくと、複雑な依存関係を表現するモデルの能力は、組み合わせ的にではなく滑らかに伸びていく。
もう1つの大きな違いは、コンテキストの長さにある。従来のn-gramモデルは、組み合わせの爆発のせいで短いウィンドウに制限される。ニューラルなアーキテクチャ、特に自己注意に基づくものは、ありうる組み合わせをすべて列挙しなくても、はるかに長い文脈を取り込める。トークンの組み合わせごとに出現回数を明示的に保存する代わりに、推論処理の中で重みづけした相互作用を動的に計算するからだ。
ただし、ニューラルモデルにもトレードオフがある。学習には大きな計算コストがかかり、大規模なデータセットが必要になる。学習された表現は、出現回数の表よりも解釈しにくい。明示的な記号的推論を伴わずに相関をとらえているだけのこともある。それでも、疎性を克服し、スケーラブルに汎化できるという理由から、現代の言語モデリングではニューラルなアプローチが主流になっている。
モデルが確率をどう推定するかがわかると、次は、その推定の質をどう測るのかという疑問が自然に出てくる。次節では、不確実性と予測性能を評価するための形式的な道具を、2.5節「エントロピー、パープレキシティ、評価指標」で導入する。
2.5 エントロピー、パープレキシティ、評価指標
言語モデリングが次のトークンを予測することだとすれば、モデルがそのタスクをどれだけうまくこなしているかを測る、筋の通った方法が必要になる。流暢さだけでは不十分だ。もっともらしい文章を出力しながら、評価では的外れな確率を割り当てているモデルもありうる。主観的な判断から離れるため、情報理論の概念であるエントロピーとパープレキシティを使う。
かみくだいて言うと
ここでいうエントロピーは「不確実さ」、つまりモデルの予想がどれだけ散らばっているかを表す。パープレキシティは、その不確実さを1つの数値で表す便利な方法だ。値が小さいほど、モデルは平均して次に来るものに自信を持っていることになる。技術者がモデルを比べるときに使う物差しで、「自信がある」「自信がない」の度合いとして読めばよい。
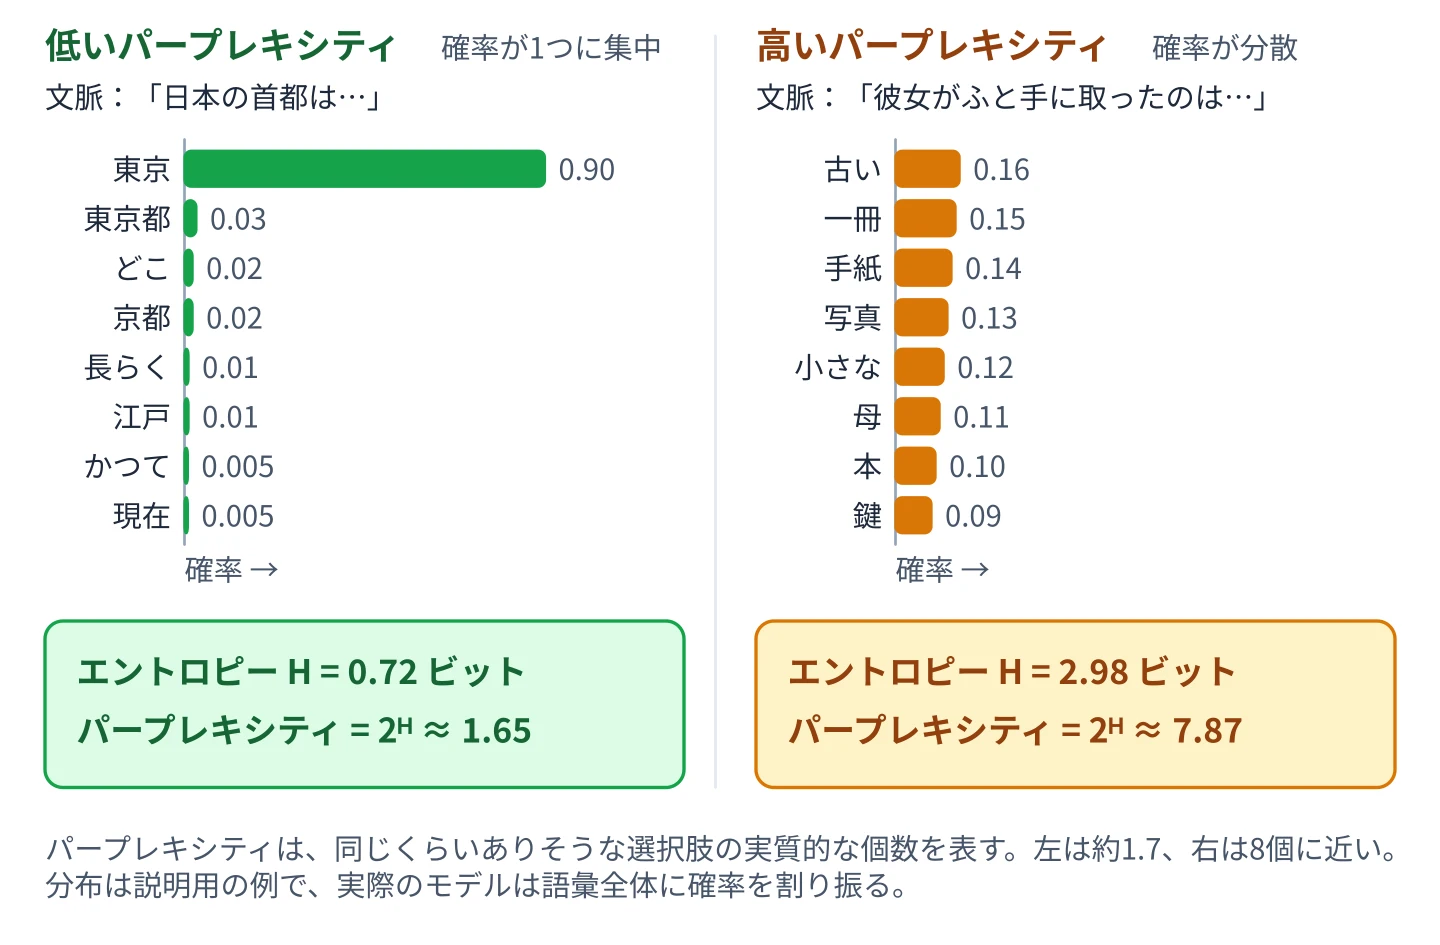
エントロピーは、確率分布の不確実性を測る量である。分布がほぼすべての確率を1つの結果に集中させていれば、不確実性は低い。確率が多くの結果に均等に散らばっていれば、不確実性は高い。言語モデリングでいえば、エントロピーはモデルが次のトークンについてどれだけ迷っているかを表す。文脈が「日本の首都は」なら不確実性は低いはずで、1つのトークンが圧倒的に有力になる。文脈が「彼女がふと手に取ったのは」なら、もっともらしい続きがたくさんあり、不確実性は高くなる。
形式的には、エントロピーは確率分布に対して定義され、その分布から取り出した結果を符号化するのに必要なビット数の期待値を表す。式で書くと H = −Σ p(x) log₂ p(x) で、和はありうるすべての結果 x についてとる。直感的には、次のトークンに平均してどれだけ驚かされるか、という問いに答える量だ。よく学習されたモデルは、データに実際に現れるトークンに高い確率を割り当てることで、驚きを減らしていく。
学習中、モデルは交差エントロピー損失を使って最適化される。これは予測分布と真の分布を比べる量で、モデルの予測確率のもとで真の次トークンを符号化するのに必要な平均ビット数と理解できる。交差エントロピーが低いほど、予測性能は高い。モデルが正しいトークンに一貫して高い確率を割り当てるようになれば、交差エントロピーは下がる。
パープレキシティは交差エントロピーを直接変換した量で、言語モデリングの評価で広く使われている。ビット単位で測った交差エントロピーを指数として2を累乗した値に等しい(ナット単位で測ったなら e を累乗した値になり、結果は同じ)。パープレキシティは、モデルが各ステップで実質的に何個の同じくらいありそうな選択肢を検討しているか、と解釈できる。たとえばパープレキシティが10なら、モデルは平均して、同じくらいもっともらしい10個のトークンから選んでいるかのようにふるまっていることになる。パープレキシティが低いほど、モデルの確信は強く、データに対する予測の当てはまりもよい。
注意すべきなのは、パープレキシティをホールドアウトデータ、つまり学習中に見せていないテキストで測ることだ。こうすることで、評価が記憶ではなく汎化を反映するようになる。学習データではパープレキシティが低いのに新しいデータでは高いモデルは、過学習している。特定の系列を覚え込んでいるだけで、より広い構造をとらえていないのだ。ただし、公開されたWebの大部分を使って事前学習されたモデルについては、評価用のテキストが本当に未見であると保証することが難しくなっている。ベンチマークの問題と答えが学習コーパスに紛れ込むことが多く、この問題は汚染(contamination)と呼ばれる。汚染があると、本当の汎化を反映しないままスコアが水増しされることがある。
とはいえ、パープレキシティにも限界がある。測っているのはトークン単位の予測精度であって、タスクとしての有用性ではない。パープレキシティがわずかに低いモデルが、より役に立つ要約や、より優れた推論の連鎖を生み出すとは限らない。実際に応用されるシステムの評価では、タスクの正答率、人間による評価スコア、頑健性テスト、安全性ベンチマークといった追加の指標が必要になることが多い。こうしたベンチマークはすぐに古くなる。かつては難関だったMMLUのようなテストでも、最先端のモデルは今や90%を超える正答率を出しており、評価の重心は、専門家が作成したより難しい問題集、複数ステップにわたるエージェント型のタスク、人間や別のモデルが採点する一対比較へと移っている。それでもエントロピーとパープレキシティが基礎であり続けるのは、中核の目的である次トークン予測がどれだけ達成できているかを定量化できるからだ。
もう1つ見落としやすい点として、パープレキシティはトークン化に依存する。予測の単位はトークンなので、トークナイザを変えると評価の尺度そのものが変わる。より細かいトークンを使うモデルは、根本的な能力が同程度でも、異なるパープレキシティの値を示すことがある。指標を解釈するときには表現の選択を理解しておくことが重要だ、ということがここでも確認できる。このため、トークナイザの異なるモデルを比べるときは、損失をトークン数ではなくバイト数や文字数で正規化し、バイトあたりのビット数(bits per byte)として報告することが多い。この量は、テキストがどう区切られたかに左右されない。
ポイント:エントロピーとパープレキシティは、モデルが次のトークンについてどれだけ不確実かを定量化する。流暢さという主観的な印象を超えて、予測性能を厳密に測るための物差しになる。
確率に基づく評価の枠組みが整ったので、大規模な確率推定を実現可能にしている計算の構造を調べる準備ができた。次章では、統計的な定式化からアーキテクチャとしての実装へと進み、第3章「言語のためのニューラルネットワーク」を見ていく。
ポチっとでの実践
短い返事をどう受け取るか
「11時で」を理解できたかは、文章の予測しやすさだけでは分かりません。進行中の作業がある場合とない場合を対にして、時刻の回答として受け取るべきときと、何の時刻か聞き返すべきときを測ります。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る