 Pocchito
第9章 性能、スケーリング、コスト
日常の短い頼みごとでは、結果が返るまでの待ち時間が体験を左右します。モデルを選ぶときは、品質と一緒に時間、費用、必要なメモリを測ります。
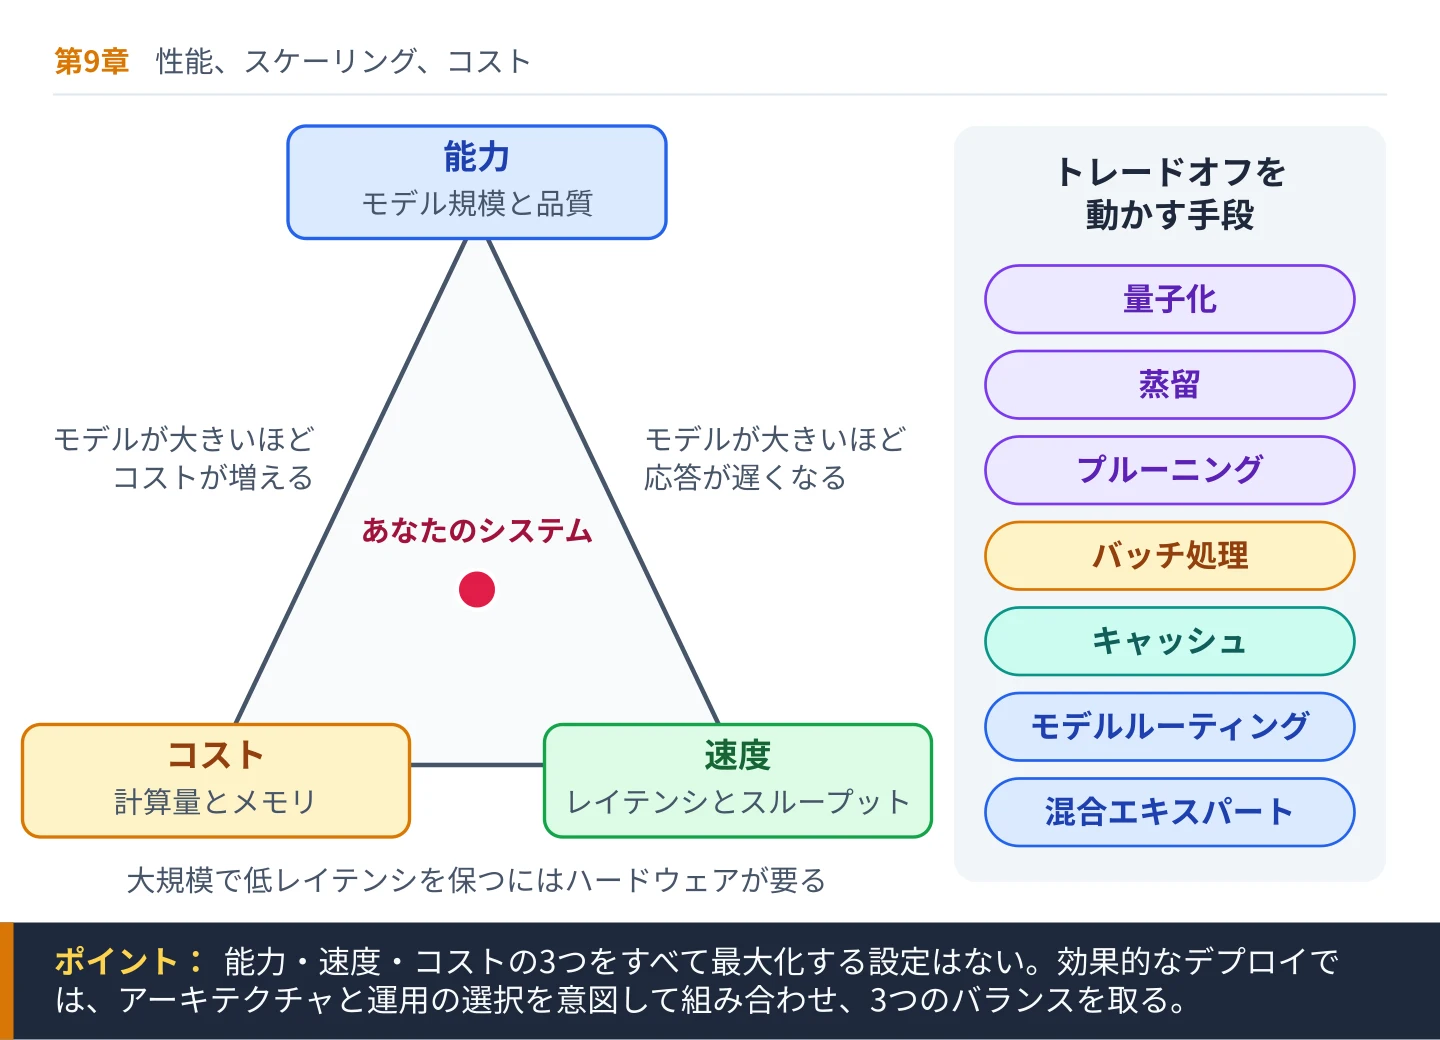
ここまでの章では、大規模言語モデルがどう作られ、どう学習され、どう応用されるかを見てきた。しかし、こうしたシステムを本番環境に展開すると、運用上の制約というもう一段の複雑さが加わる。十分な速さで応答できない、負荷がかかると安定して動かない、予算内に収まらない。そうしたモデルでは、理論上の能力が高くてもあまり意味がない。第9章では、実世界でのLLM展開を左右するエンジニアリング上のトレードオフを検討する。
本章の焦点は、性能特性とコストの力学である。大きなモデルほど性能は高くなりやすいが、そのぶんメモリも計算量もエネルギーも多く必要になる。応答が速ければユーザー体験は良くなるが、レイテンシを下げるにはアーキテクチャ上の妥協が要ることもある。インフラの選択は、スケーラビリティと持続可能性の両方に影響する。
9.1節「モデルサイズと能力」では、パラメータ数と性能の関係を分析する。経験的なスケーリング則、収穫逓減、そして「大きなモデルが追加コストに見合うのはどんなときか」という実務上の問いを扱う。能力はあるかないかの二択ではなく、アーキテクチャ・データ・規模によって形づくられる連続的なものである。
9.2節「レイテンシとスループット」では、システムの応答性を掘り下げる。レイテンシは1件のリクエストにかかる時間、スループットは単位時間あたりに処理できるリクエスト数を表す。ユーザー体験とインフラ効率の両方に効いてくる、バッチ処理の戦略、キャッシュ、並行処理の管理を論じる。
9.3節「コストの考慮とトレードオフ」では、経済的な現実を見る。計算資源、メモリ要件、エネルギー消費、API利用料はいずれも展開の判断材料になる。コストのモデル化と、アーキテクチャや運用の選択が総保有コストにどう影響するかを論じる。
9.4節「量子化と効率的な推論処理」では、性能を大きく落とさずに計算需要を減らす手法を分析する。低精度演算、プルーニング(枝刈り)、蒸留によって、小さく速いモデルで大きなモデルを近似できる。投機的デコーディングのように、出力を変えずに生成を速める手法もある。
9.5節「エッジとオンデバイスでの展開」では、集中型のクラウドインフラではなく、手元の端末でモデルを動かす場面を検討する。オンデバイスでの推論処理にはメモリ・計算能力・消費電力の制約がつきまとうが、プライバシーとレイテンシの面では利点がある。
まずは、スケーリングの最もわかりやすい次元である、モデルサイズと能力の関係から始めよう(9.1節)。
9.1 モデルサイズと能力
現代のAIで繰り返し観察されてきたことの一つに、言語モデルは大きいほど性能が高くなりやすい、という傾向がある。パラメータ数が数百万から数十億、さらにその先へと増えるにつれ、推論、翻訳、要約、コード生成など幅広いタスクで性能が向上する。このサイズと性能の関係は偶然ではない。モデルの容量が、データや最適化とどう相互作用するかを反映している。
かみくだいて言うと
大きなモデルはおおむね能力が高いが、サイズが大きくなるほど伸び幅は小さくなる。2倍の大きさのモデルが2倍賢いということはまずなく、少し良くなる程度のことが多い。実際のアプリケーションでは、最大級のモデルを使うより、周辺のエンジニアリングをしっかり作った小さめのモデルのほうが良い選択になる場面が多い。
モデルサイズとは、主に学習可能なパラメータの数を指す。最先端のモデルや大規模なオープンウェイトモデルで一般的になった混合エキスパート(MoE)では、二つの数字が重要になる。一つはメモリ要件を決める総パラメータ数、もう一つは計算コストを決める、トークンごとに実際に使われる(はるかに少ない)パラメータ数である。広く研究されているあるオープンモデルは、総パラメータ数が6710億でありながら、1トークンあたりに使うのは約370億にすぎない。パラメータを増やすと表現能力が広がる。大きなモデルはより複雑な関数を近似でき、より微妙な統計的依存関係をとらえ、より多くの知識を分散的に蓄えられる。十分なデータと計算資源が伴えば、この容量の増加は学習損失の低下と汎化性能の向上につながる。
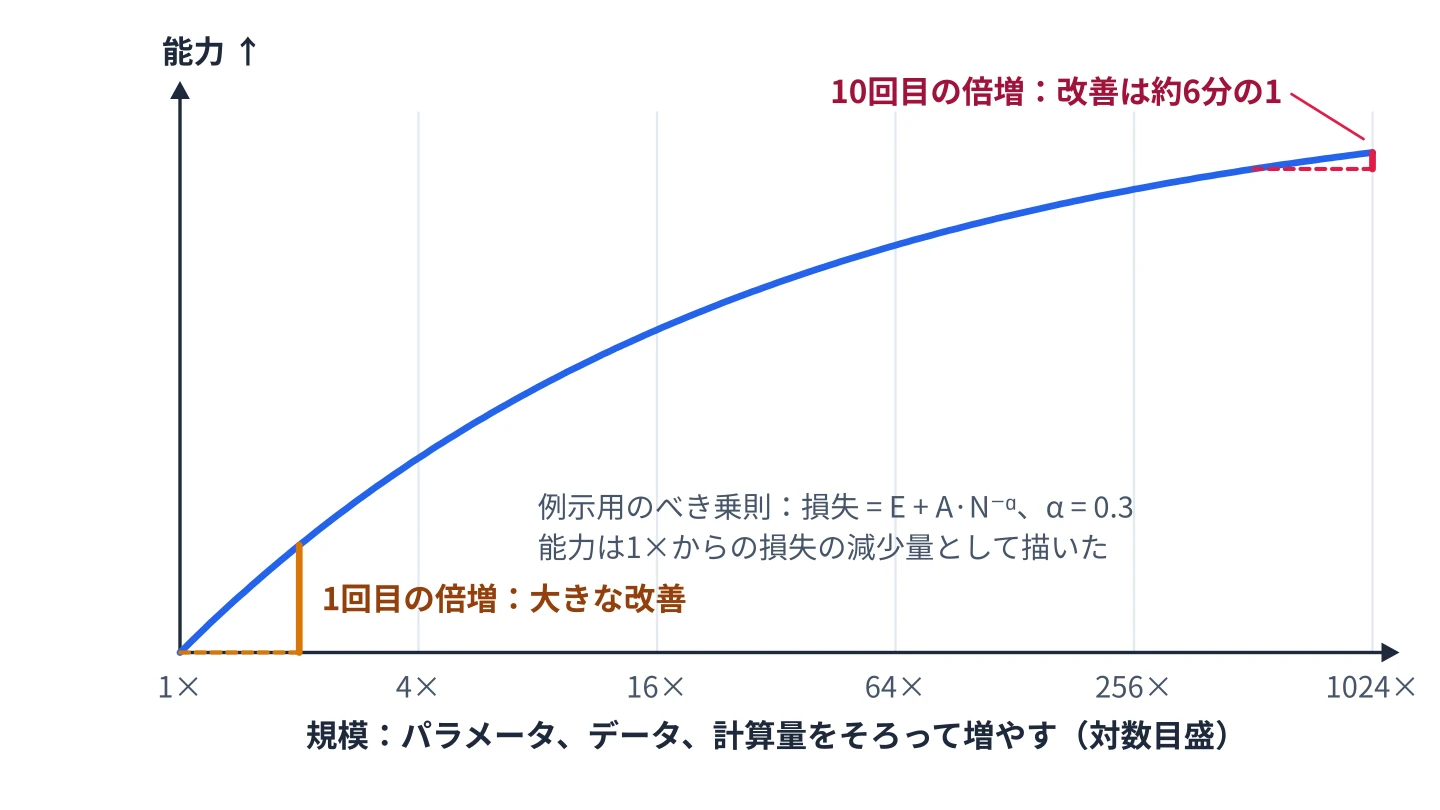
経験的なスケーリング則によれば、モデルサイズ、データ量、計算量をそろって増やすと、性能はしばしば予測可能な形で向上する。損失は規模のべき乗則にほぼ従って減っていく。重要なのは、能力の中には突然ではなく徐々に現れるものがあることだ。大規模になって「創発的な振る舞い」に見えるものも、多くの場合、根底にある統計的な改善がなめらかに続いた結果である。
とはいえ、スケーリングにも限界はある。いずれ収穫逓減が現れる。パラメータ数を2倍にしても、性能が2倍になるとは限らない。特にデータや計算資源が限られている場合、得られる改善は少しずつになる。さらに、大きなモデルはメモリ使用量も推論コストも増やすので、多くの用途ではわずかな改善のために見合わないこともある。
もう一つ見落とされがちなのが、タスクによる感度の違いである。自由度の高い推論や長いコンテキストの理解のように、規模の恩恵を強く受けるタスクがある。一方、単純な分類のように、小さなモデルで十分な性能に届くタスクもある。したがって、モデルサイズは「大きいほど良い」と決めつけずに、用途に応じて選ぶ必要がある。
アライメントと制御可能性の問題もある。大きなモデルは生成能力が豊かになる一方で、より慎重なガードレールを必要とすることがある。能力が高まれば、長所もリスクも増幅されうる。
実務では、組織は能力とコストのフロンティアに沿ってモデルを選ぶことが多い。深い推論を要する重要度の高い用途なら、大きなモデルを使う理由がある。リアルタイム処理や大量処理のワークフローなら、小型のモデルや蒸留モデルのほうが総合的な価値が高いことがある。
能力を買う手段は、もはやパラメータ数だけではない。推論モデル(reasoning model)は、多くの場合、答えを自動で検証できるタスクでの強化学習によって、回答の前に長い中間的な推論の連鎖を生成するよう訓練されている。数学、コーディング、計画立案のタスクでは、考えるためにより多くのトークンを使わせるほど精度が上がる。このため、推論時計算(test-time compute)がモデルサイズと並ぶ第二のスケーリング軸になっている。展開の観点では、中規模のモデルに大きな推論予算を与えると、大きなモデルがそのまま答える場合に匹敵することがある。ただしその代償として、レイテンシが伸び、1リクエストあたりの課金トークンも増える。
モデルサイズがシステムに何ができるかを左右する一方で、ユーザーの使い心地を決めるのは応答性である。
9.2 レイテンシとスループット
能力の高いモデルでも、応答が遅すぎたり同時利用者をさばけなかったりすれば、本番システムとしては失格である。展開時の性能を主に左右するのは、レイテンシとスループットという二つの指標だ。両者の違いと、アーキテクチャ上の選択がそれぞれにどう影響するかを理解することは、実用的なシステム設計に欠かせない。
かみくだいて言うと
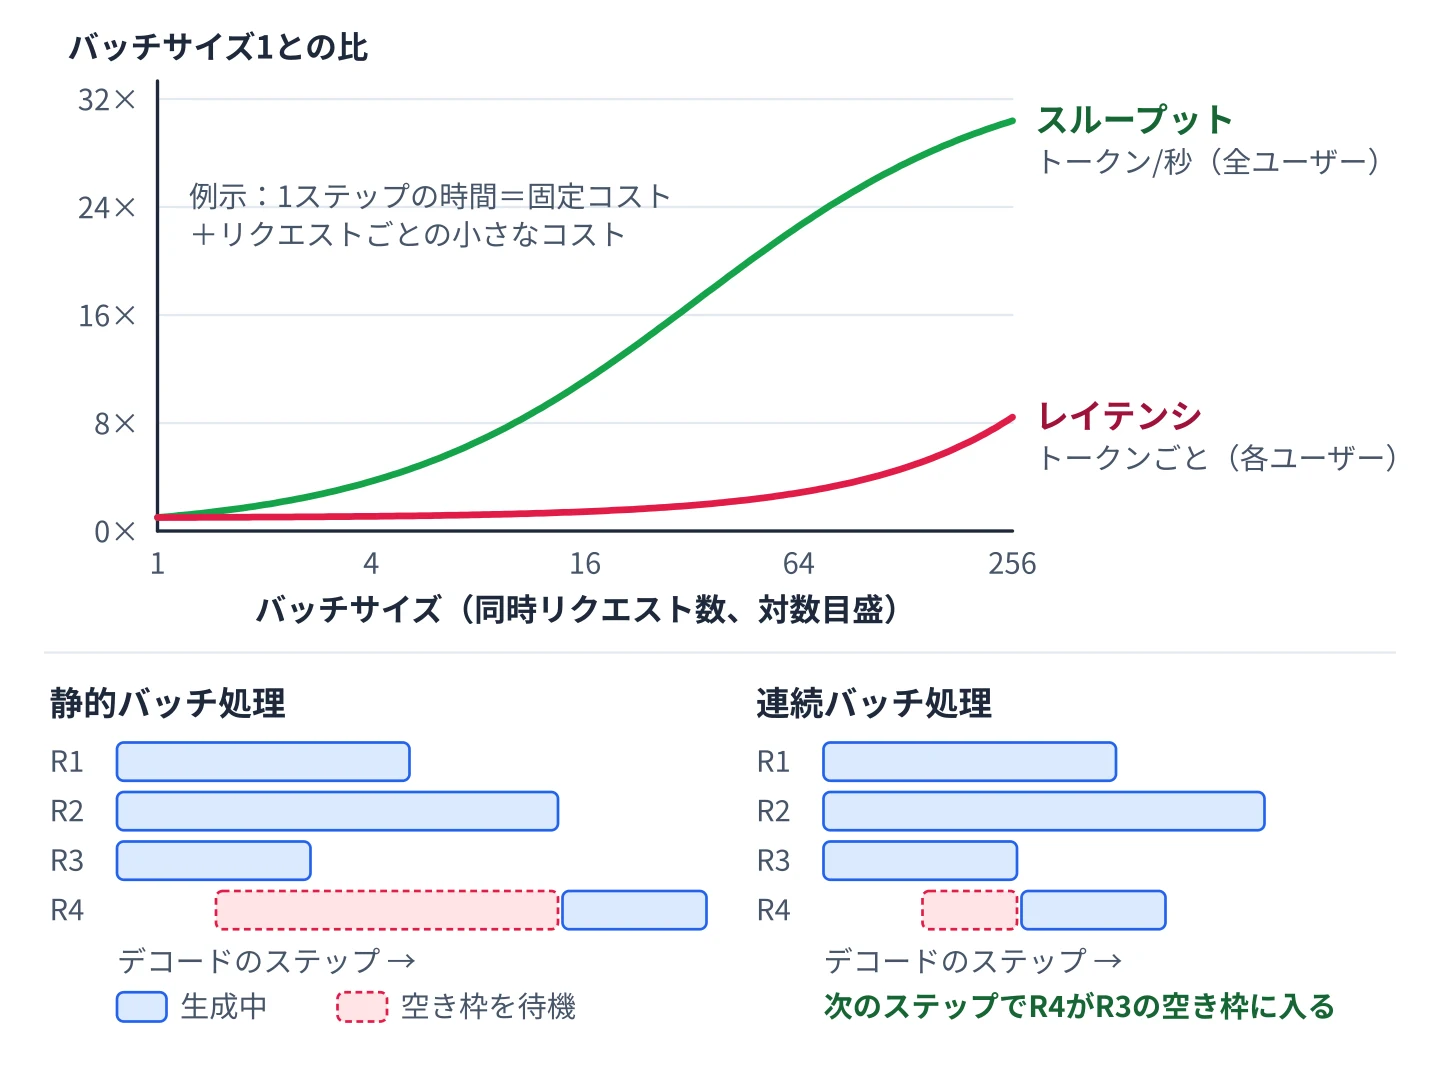
レイテンシは、ユーザーが答えを待つ時間である。スループットは、システムが1秒あたりに処理できるリクエストの数である。この二つは逆方向に引っ張り合う。多くのリクエストをまとめて処理(バッチ処理)すればスループットは上がるが、一人ひとりの待ち時間は伸びる。実際のシステムを設計するとは、両者の間で意図的にバランスを取ることである。
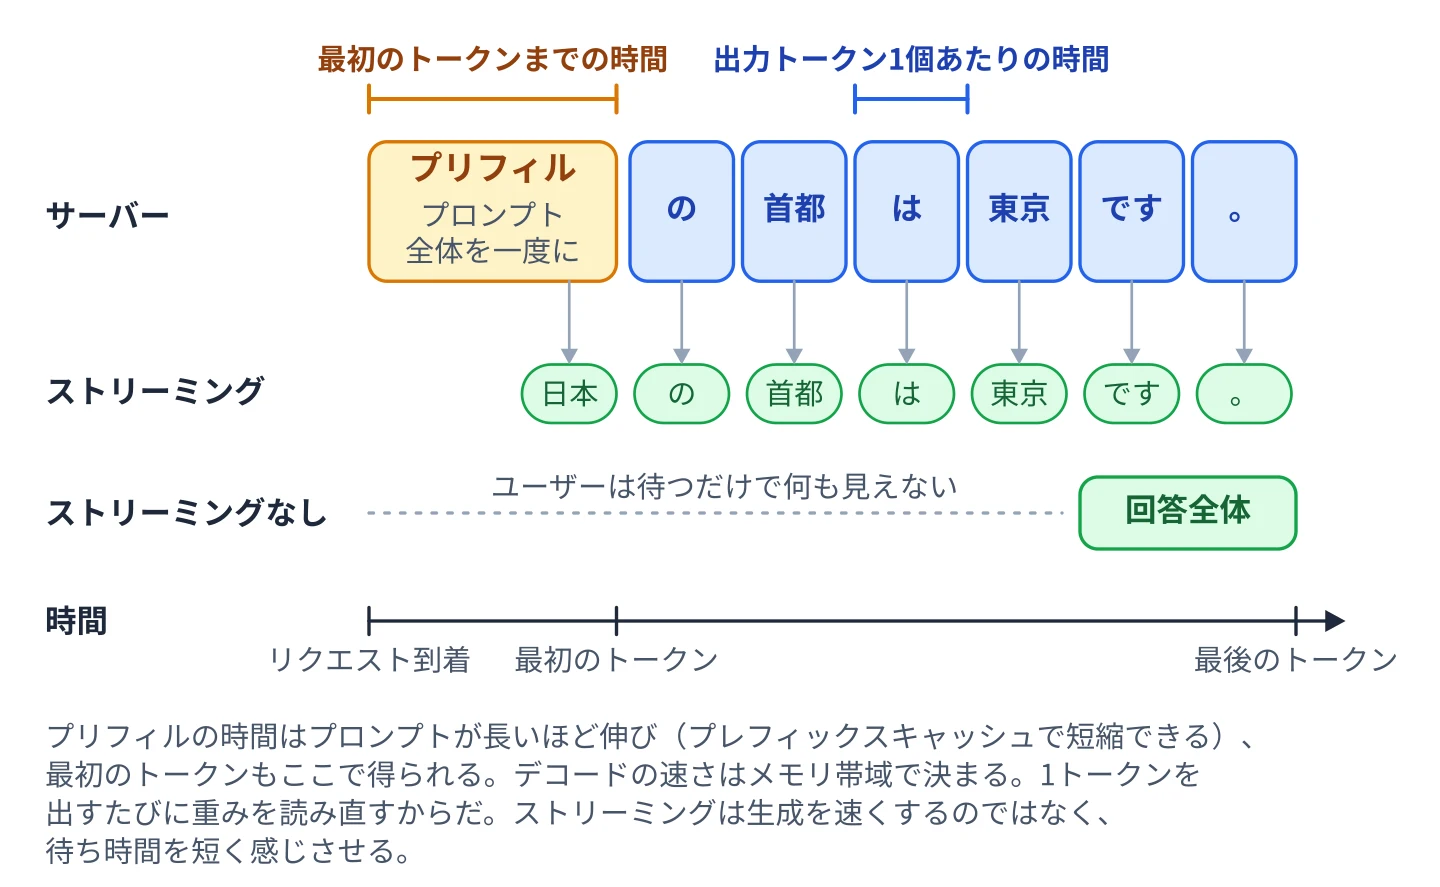
レイテンシとは、1件のリクエストに対する応答を生成するのに要する時間を指す。対話型システムでは、通常二つの成分を分けて測る。一つは最初のトークンが出るまでの時間(time to first token)で、主にプロンプトの処理にかかる時間で決まる。もう一つは出力トークン1個あたりの時間で、応答の残りがどれだけ速く流れ出てくるかを左右する。バッチ型のワークフローでは、1件のタスクが完了するまでの総時間を指すこともある。レイテンシは、モデルサイズ、ハードウェアによる高速化、コンテキスト長、デコーディング戦略の影響を受ける。
大きなモデルほど、1トークンあたりの計算量が多い。プロンプトが長くなると注意機構の計算が増え、その量は系列長の2乗に比例して増える。ビームサーチのようなサンプリング戦略も、単純な貪欲デコーディングに比べて処理時間を伸ばすことがある。
スループットは、システムが単位時間あたりに処理できるリクエスト数を表す。個々の応答速度ではなく、システム全体の処理能力を反映した指標である。スループットは、バッチ処理の戦略、並列化、ハードウェアのスケーリング、負荷分散によって決まる。顧客サポートの自動化や文書処理パイプラインのような大量処理の用途では、1件ごとのレイテンシよりスループットのほうが重要になることが多い。
この二つの指標は、しばしば緊張関係にある。複数のリクエストをまとめてバッチ処理すれば、ハードウェアを効率よく使えてスループットは向上するが、個々のユーザーのレイテンシは伸びかねない。現代の推論サーバーは、この緊張を二つの工夫でやわらげている。一つは連続バッチ処理で、バッチが埋まるのや全件が終わるのを待たずに、デコードの各ステップでリクエストを実行中のバッチに出し入れする。もう一つはKVキャッシュのページ単位の管理で、注意機構用のメモリを小さなブロック単位で割り当てることで、1台のアクセラレータにより多くの同時リクエストを載せられるようにする。同様に、コンテキストウィンドウを大きくすると品質は上がるが、リクエストあたりの計算量が増え、レイテンシとスループットの両方に影響する。
ストリーミング生成は、レイテンシの問題を部分的に解消する。応答全体ができあがるのを待たず、生成されたトークンから順に送り出すのである。生成にかかる総時間は変わらなくても、体感上の待ち時間は短くなる。対話型のアプリケーションでは、計算そのものの時間より体感の応答性のほうが重要なことが多い。
キャッシュも実用的な最適化手段である。繰り返し現れるプロンプトや検索結果をキャッシュすれば、重複する計算を減らせる。特に効果が大きいのがプレフィックスキャッシュだ。長いシステムプロンプトや参照文書のように、多くのリクエストが同じ冒頭部分を共有している場合、その部分について計算したKVキャッシュを保存して再利用する。これにより、最初のトークンまでの時間とコストの両方を削減できる。ホスト型のAPIでは、こうしたキャッシュ済みの入力トークンを大幅に割り引いて課金するのが一般的なので、変わらない内容をプロンプトの先頭に、変わる内容を末尾に置く設計が報われる。対話型システムでは、検索層の埋め込みをキャッシュしておくと、ユーザーが似た質問を繰り返したときの性能が上がる。
並行処理の管理も重要な役割を果たす。複数のアクセラレータに推論処理を分散させれば、システムを水平にスケールできる。ただし大規模になると、同期のオーバーヘッドと通信帯域が制約になる。ボトルネックを生まずに負荷を分散するには、効率的なオーケストレーション層が必要である。
性能上の制約は、必然的に経済の問題につながる。あらゆる最適化の判断が、インフラコストと資源配分に影響するからだ。
9.3 コストの考慮とトレードオフ
大規模言語モデルのあらゆる展開の背後には、コスト構造がある。計算サイクル、メモリ割り当て、ストレージ、ネットワーク帯域、エネルギー消費は、すべて金銭的な支出に換算される。規模を大きくすればモデルの能力は向上しやすいが、運用コストも増える。効果的なシステム設計には、最大規模が最適だと決めつけるのではなく、トレードオフを明示的に分析することが求められる。
かみくだいて言うと
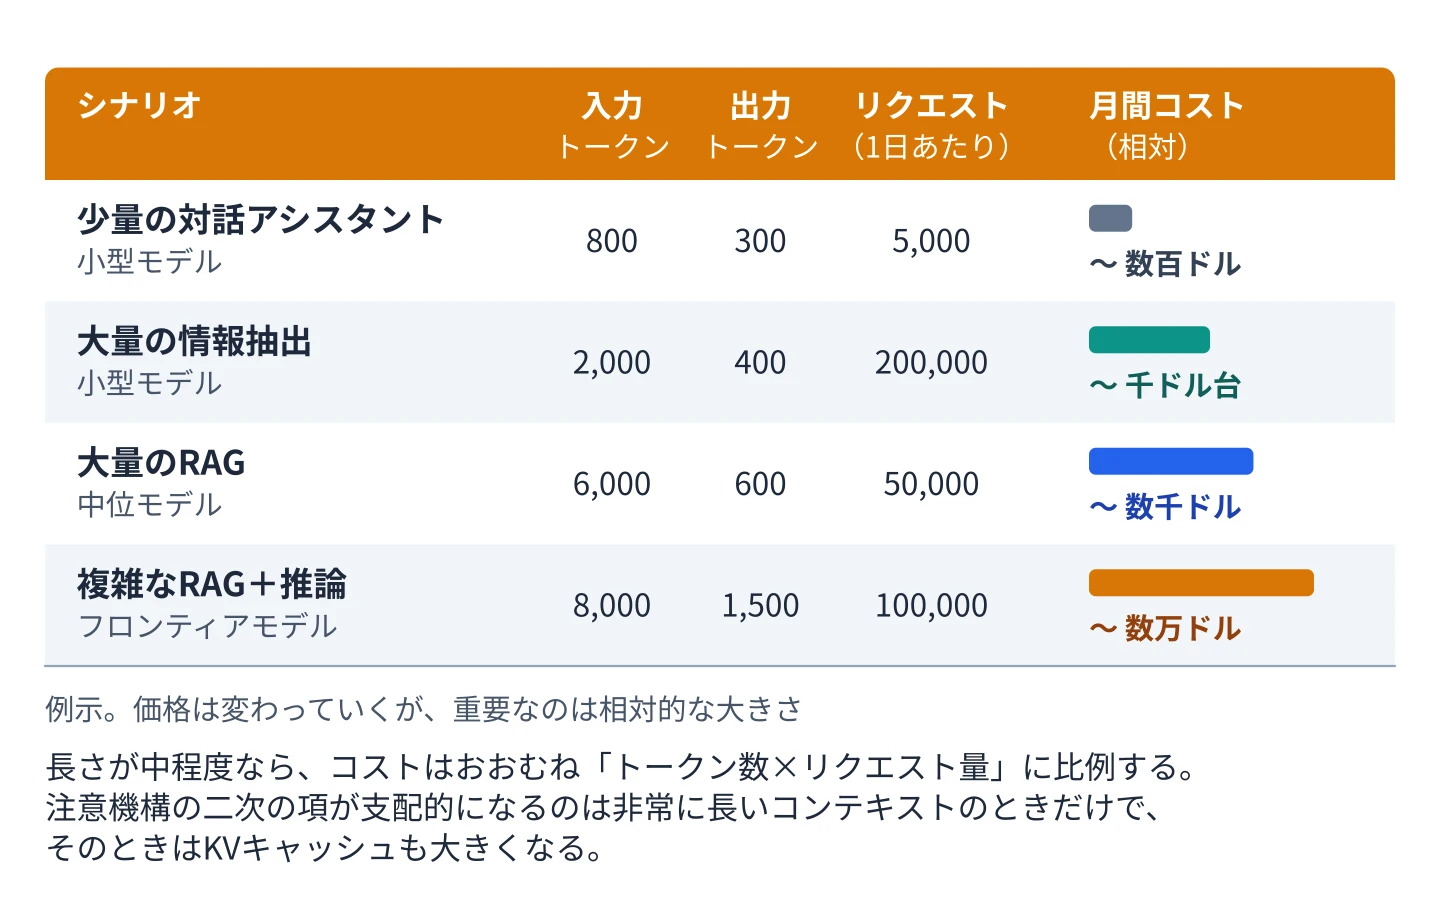
LLMを動かすと、リクエストのたびにお金がかかる。どのリクエストも計算能力を消費するからだ。長い会話は短い会話より高くつき、推論モデルは通常のモデルより高くつく。一度作ってしまえば利用者が増えても追加費用がほとんどかからない通常のソフトウェアとは、コスト構造がまったく違う。
最も目に見えるコスト要因は、推論処理の計算である。トークンを1つ生成するたびに、モデル全体を通る順伝播が必要になる。大きなモデルほど、1トークンあたりの浮動小数点演算が多く、パラメータをメモリとプロセッサの間で移動させるためのメモリ帯域も多く必要になる。長い応答を生成したり、多数の同時リクエストを処理したりするアプリケーションでは、こうしたコストがすぐに積み上がる。推論モデルにはさらに別のコスト要因がある。生成される中間的な推論トークンは、ユーザーに表示されない場合でも通常は出力トークンとして課金される。そのため、目に見える答えは短くても、その裏に数千トークン分のコストが隠れていることがある。
コンテキスト長もコストに影響する。注意機構の計算量は系列長の2乗に比例するため、コンテキスト長を2倍にすると注意機構のコストは2倍以上になる。もっとも、中程度のコンテキスト長では計算の大半をフィードフォワード層が占めるため、総コストはトークン数にほぼ比例して増える。2乗の注意機構の項が支配的になるのはコンテキストが非常に長くなってからであり、KVキャッシュも保持するトークンが増えるたびに大きくなる。したがって、長い文書や複数ターンの会話を扱うアプリケーションでは、トークン予算を慎重に管理する必要がある。ホスト型APIは毎ターン、すべての入力トークンに課金するのでなおさらである。
インフラの選択もコストを左右する。クラウドでモデルを動かせば、計算インスタンスの料金とデータ転送の費用がかかる。ピーク時のトラフィックに合わせて追加のハードウェアを確保すれば、閑散時には遊休資源が増える。逆に確保が足りなければ、性能が落ちてユーザーの不満を招くおそれがある。
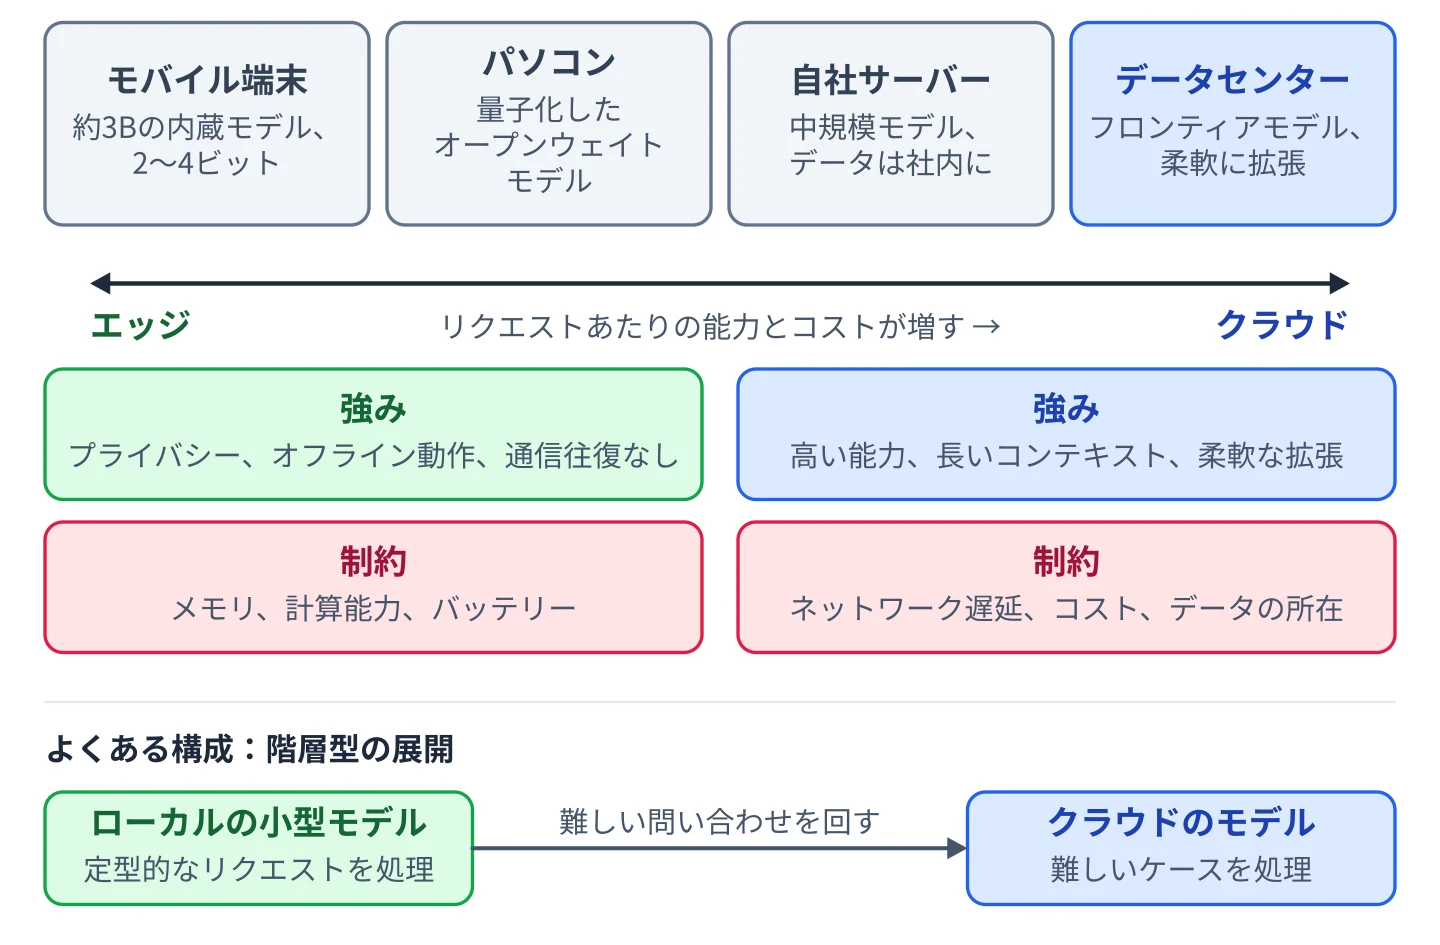
モデルの選択も経済的な要因である。あらゆるタスクに最大のモデルを使うのは、費用対効果が高いとは限らない。定型的なタスクなら、小型のモデルや蒸留モデルでも、わずかな費用で十分な精度が得られることがある。単純な問い合わせは小さなモデルで処理し、複雑なケースだけを上位のモデルに回す階層型のアーキテクチャは、全体として効率が良くなることが多い。
エネルギー消費と持続可能性も無視できない。大規模な推論処理のワークロードは大量の電力を消費する。責任あるAI展開の一環として、エネルギー使用量を評価する組織が増えている。効率的な推論処理の手法は、コストだけでなく環境負荷も減らす。
コストのモデル化は先回りして行うべきである。リクエストあたりの計算コスト、平均生成トークン数、予測トラフィックを見積もっておけば、スケールする前に費用を予測できる。継続的に監視すれば、実際の利用状況が想定どおりかどうかを確かめられる。
性能をあまり犠牲にせずにコストを下げるには、モデルのレベルでの技術的な戦略が必要になる。
9.4 量子化と効率的な推論処理
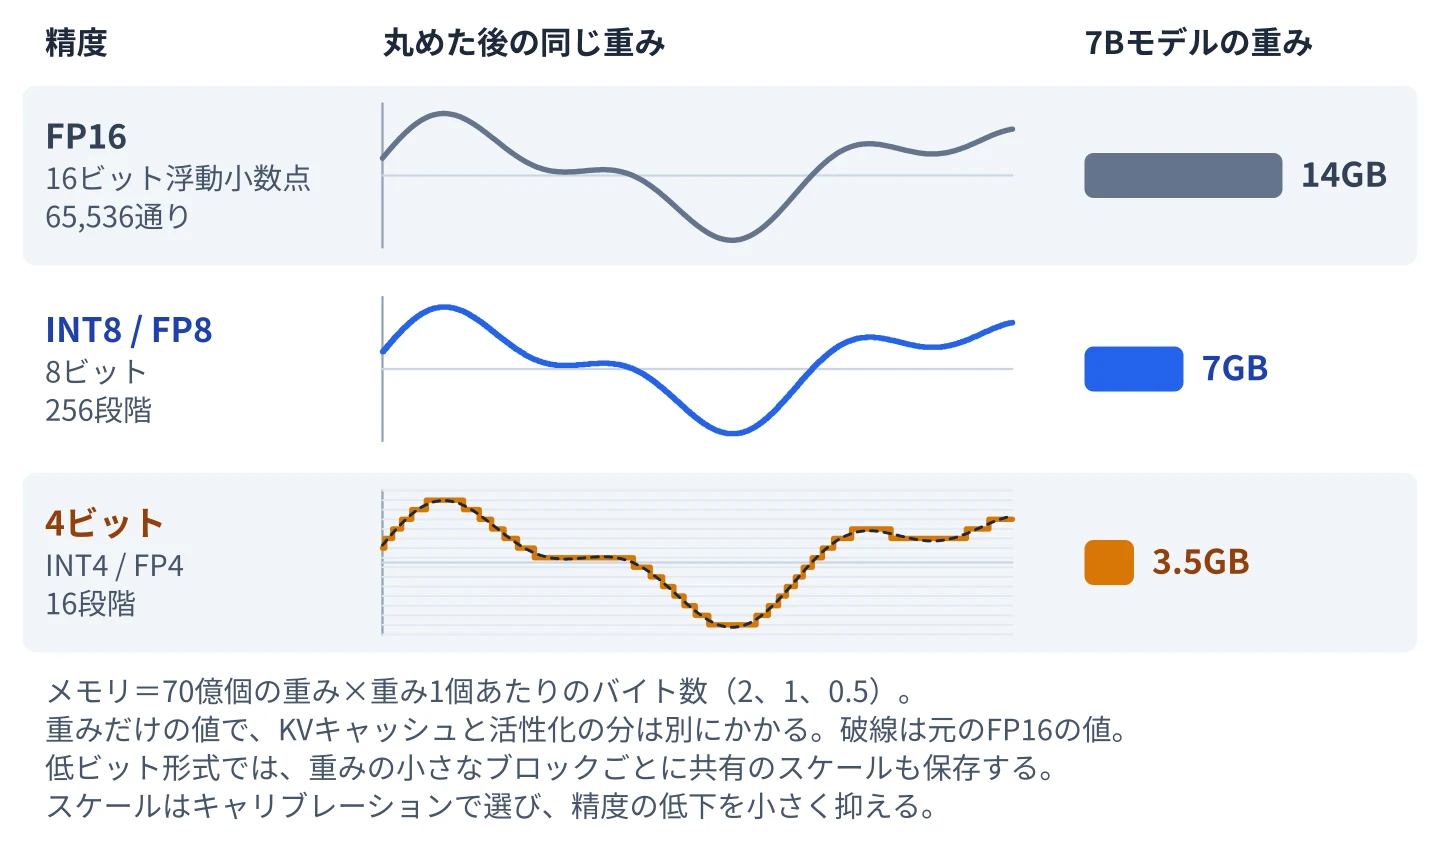
大規模言語モデルの学習では、従来、パラメータと活性値を32ビットまたは16ビットの浮動小数点で表現してきた。最近の大規模な学習では、行列積の大半を8ビット浮動小数点(FP8)で行い、マスター重みや精度に敏感な演算だけを高精度に保つ例が増えている。こうした高精度の形式は、安定した最適化と正確な勾配計算を支える。しかし推論処理、つまり学習済みモデルが出力を生成する段階では、同じ水準の数値精度が常に必要なわけではない。量子化はこの違いを利用し、重みと活性値の精度を低ビットの表現に落とすことで、メモリ使用量と計算コストを減らす。
かみくだいて言うと
量子化とは、モデルの数値を低い精度で保存する技術的な工夫である。写真を画質を落として保存するのに似ている。これによりモデルのメモリ使用量が減り、動作も速くなる。慎重に行えば、回答の質の低下はわずかで済む。大きなモデルを小さなハードウェアに押し込めるのは、この技術のおかげである。
大まかに言えば、量子化は連続的な浮動小数点値を、少数の離散的なレベルに写像する。たとえば32ビットの浮動小数点は数十億通りの値を表せるが、8ビット整数が表せるのは256段階だけである。パラメータの値を注意深くスケーリングして丸めれば、モデルは8ビット、さらには4ビットの表現でも、性能をほとんど落とさずに動作できる。
量子化の最大の利点は効率である。重みを低精度にするとメモリの使用量が減り、大きなモデルを小さなハードウェアに収められる。低精度の演算は一般に高精度の演算より速く、消費エネルギーも少ないので、計算も速くなる。低精度とは、もはや整数だけを意味しない。最近のアクセラレータは8ビットや4ビットの浮動小数点形式をネイティブにサポートしている。これらの形式では、値を小さなブロックに分けて共通のスケール係数を持たせることで、4ビットの数でも実用的なダイナミックレンジを確保している。こうしてスループットが向上し、運用コストが下がる。
ただし、量子化は近似誤差を持ち込む。精度を大胆に落としすぎると、学習された重みの分布がゆがみ、精度が下がるおそれがある。これを抑えるため、現代の量子化手法はキャリブレーションを行う。代表的なデータでモデルの挙動を評価し、スケール係数を調整して性能の低下を最小限にするのである。重みだけを量子化して活性値は高精度のまま残す手法もあれば、影響を受けやすい層により多くのビットを割り当てる混合精度の戦略もある。
量子化のほかにも、効率的な推論処理の手法としてプルーニングと蒸留がある。プルーニングは、出力の品質にほとんど寄与しないパラメータを取り除き、モデルを小さくする。蒸留は、大きな「教師」モデルの出力をまねるように小さな「生徒」モデルを学習させ、能力の多くを保ちながら必要な資源を減らす。これらを組み合わせれば、フルサイズのモデルでは現実的でない展開シナリオも可能になる。
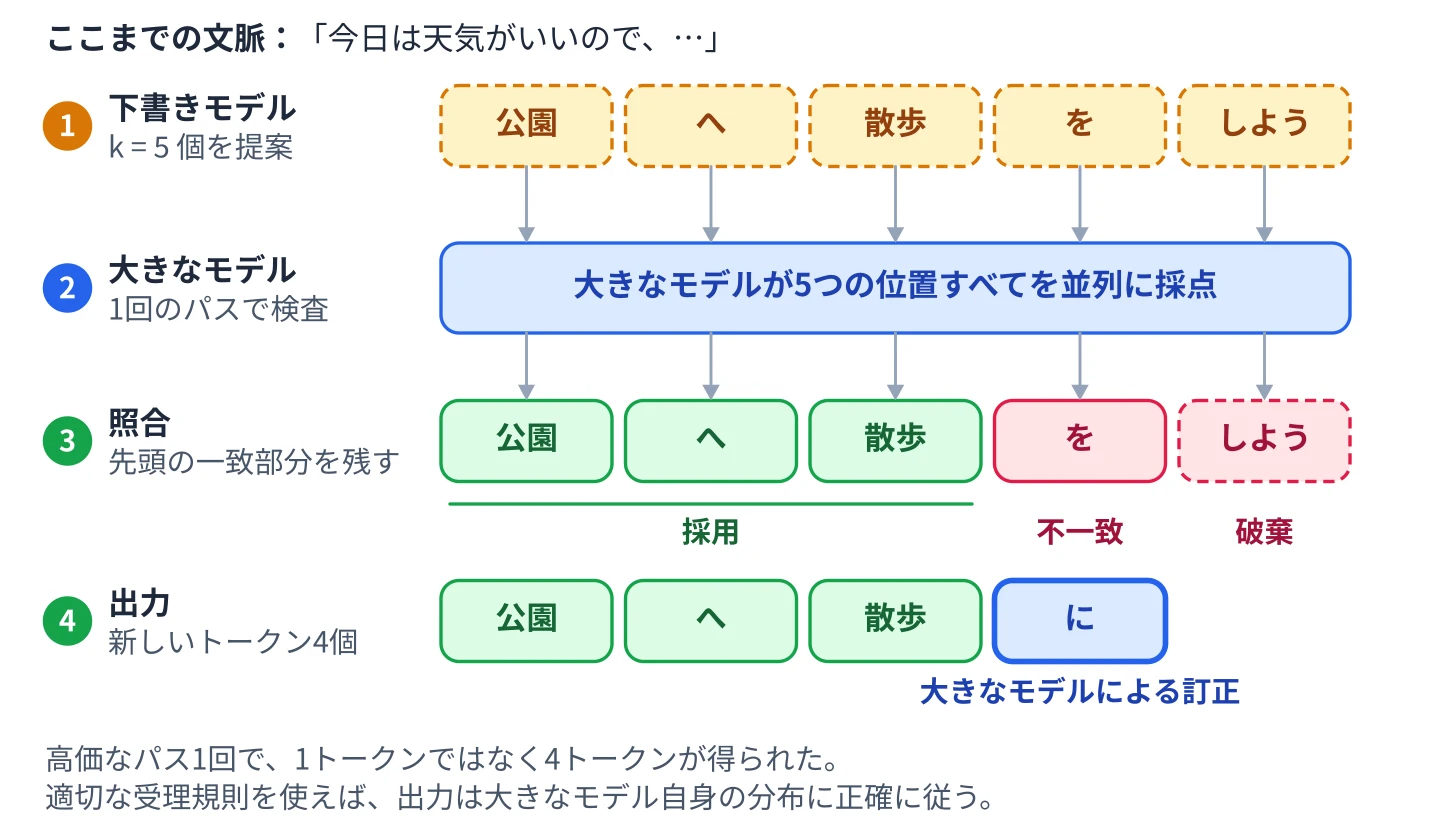
これとは別の種類の手法として、モデルにはまったく手を加えずに生成を速めるものがある。投機的デコーディングは、大きなモデルに、はるかに安価な下書き役(小さなモデルや追加の予測ヘッド)を組み合わせ、下書き役に数トークン先まで提案させる。大きなモデルは提案されたトークンすべてを1回の順伝播でまとめて検査し、自身の分布と整合する最長の先頭部分を採用して、最初の不一致を訂正する。複数のトークンを並列に検証するコストは1トークンを生成するコストとほぼ同じなので、高価な1回のパスで複数のトークンが得られる。しかも適切な受理規則を使えば、出力の分布は大きなモデル単独の場合と数学的に同一になる。この手法は、今では本番用の推論サーバーで標準的に使われている。
効率的な推論処理は、最適化されたカーネルとハードウェアの支援にも依存する。専用のライブラリが、低精度での行列積や注意機構の演算を高速化する。そうした支援がなければ、理論上の効率向上が実際の速度向上につながらないこともある。
量子化とその関連手法は、重要な原則を示している。能力はパラメータ数だけで決まるのではなく、推論処理の際にそのパラメータをどれだけ効率よく活用できるかによって決まる、ということである。
さらに深く:LLM Primer VI — Scaling AI Systems(英語版)では、本番規模での推論処理を取り上げている。第I部〜第IV部でKVキャッシュ、量子化、バッチ処理、投機的デコーディングを、第VI部でトークンの経済性とコストのモデル化を扱う。
こうした効率化の手法によって、クラウド規模のインフラが使えない、あるいは使いたくない環境への展開にも道が開ける。
9.5 エッジとオンデバイスでの展開
今日の大規模言語モデルの多くは、集中型のデータセンターに展開され、強力なアクセラレータとスケーラブルなインフラが推論処理を担っている。しかし、すべてのアプリケーションがクラウドへの常時接続を前提にできるわけではない。エッジやオンデバイスでの展開は、スマートフォン、ノートPC、組み込みシステム、ローカルサーバーの上でモデルを動かし、言語モデルをユーザーの手元に近づける。
かみくだいて言うと
ネットワーク接続を当てにできないアプリケーションや、データをユーザーの端末から出したくないアプリケーションがある。「オンデバイス」や「エッジ」での展開では、小さく強く圧縮したモデルを、スマートフォンやノートPC上で直接動かす。その代償は能力である。エッジ向けのモデルはクラウドの巨大モデルより単純なことが多いが、オフラインで動き、プライバシーも守れる。
エッジ展開の動機はいくつもある。第一に、プライバシーへの配慮からローカル処理が求められる。推論処理がユーザーの端末上で直接行われれば、機微なデータを外部のサーバーに送る必要がない。これにより漏えいのリスクが減り、規制への対応も簡単になることがある。第二に、ネットワークの往復がなくなるのでレイテンシが改善する。音声アシスタントや拡張現実のようなリアルタイムのアプリケーションは、ローカルで即座に応答できることの恩恵を受ける。第三に、オフラインで動けるので、接続が不安定な環境でもシステムが機能する。
こうした利点には厳しい制約が伴う。エッジ端末のメモリ、計算能力、電力の予算は限られている。数十GBのメモリを必要とするモデルは、大幅に圧縮しなければスマートフォンでは動かない。量子化、プルーニング、蒸留といった効率的な推論処理の手法は、もはや最適化ではなく前提条件になる。
アーキテクチャの設計も変わる。オンデバイスでは、コンテキストウィンドウの狭い小型のモデルのほうが好ましい場合がある。主要なモバイルOSやデスクトップOSには、いまや約30億パラメータの言語モデルが、重みあたり2〜4ビットに圧縮された形で組み込まれている。アプリケーションはこれをローカルで呼び出して、要約、情報抽出、ツール呼び出しに使える。ハイブリッドな構成も一般的だ。定型的なタスクは軽量なローカルモデルが処理し、複雑な問い合わせはクラウド側のシステムに回す。この階層型のアーキテクチャによって、応答性と能力のバランスを取るのである。
エネルギー効率が最重要の検討事項になる。モバイル端末はバッテリーを長持ちさせなければならない。モデルがメモリに収まったとしても、計算が長く続けば電力をすぐに使い果たしかねない。オンデバイスでの推論処理を現実的なものにするうえで、低精度演算をハードウェアで高速化する仕組みが決定的な役割を果たす。
セキュリティ上の考慮事項も変わる。ローカルに展開すれば、ユーザーのデータをネットワーク上での傍受から守れる一方、モデルの重みがリバースエンジニアリングにさらされるおそれがある。商用の展開では、知的財産の保護がアーキテクチャの選択に影響することもある。
エッジ展開は、スケーリングが常に「大きくすること」を意味するわけではないことを示している。有用性を保ちながら小さくすることが課題になる場面もある。制約の厳しい環境向けにモデルを設計するには、クラウド規模の巨大なシステムを作るのとは異なる、エンジニアリング上のトレードオフが求められる。
ポイント:エッジやオンデバイスでの展開は、プライバシー、低レイテンシ、オフライン動作を優先する。厳しいハードウェアの制約の中で動かすために、圧縮したモデルと効率を重視した設計が必要になる。
性能、スケーラビリティ、コストは、システムが実際にうまく動くかどうかを決める。しかし、完璧に最適化されたモデルであっても、もう一つの観点から評価されなければならない。安全性と責任である。
ポチっとでの実践
利用者が待つ時間を測る
将来の端末内処理を見据え、まず短い依頼の初動を対象にします。分類が曖昧なときに確認へ戻る時間や、より大きなモデルへ渡す割合も含めて測ると、利用者が体験する全体の待ち時間に近づきます。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る