 Pocchito
第8章 アプリケーションでのLLM活用
会話アプリでは、分類、要約、検索、文章作成、ツール操作で求められる正しさが異なります。何をモデルに任せるかは、誤った場合に起こることから考えます。
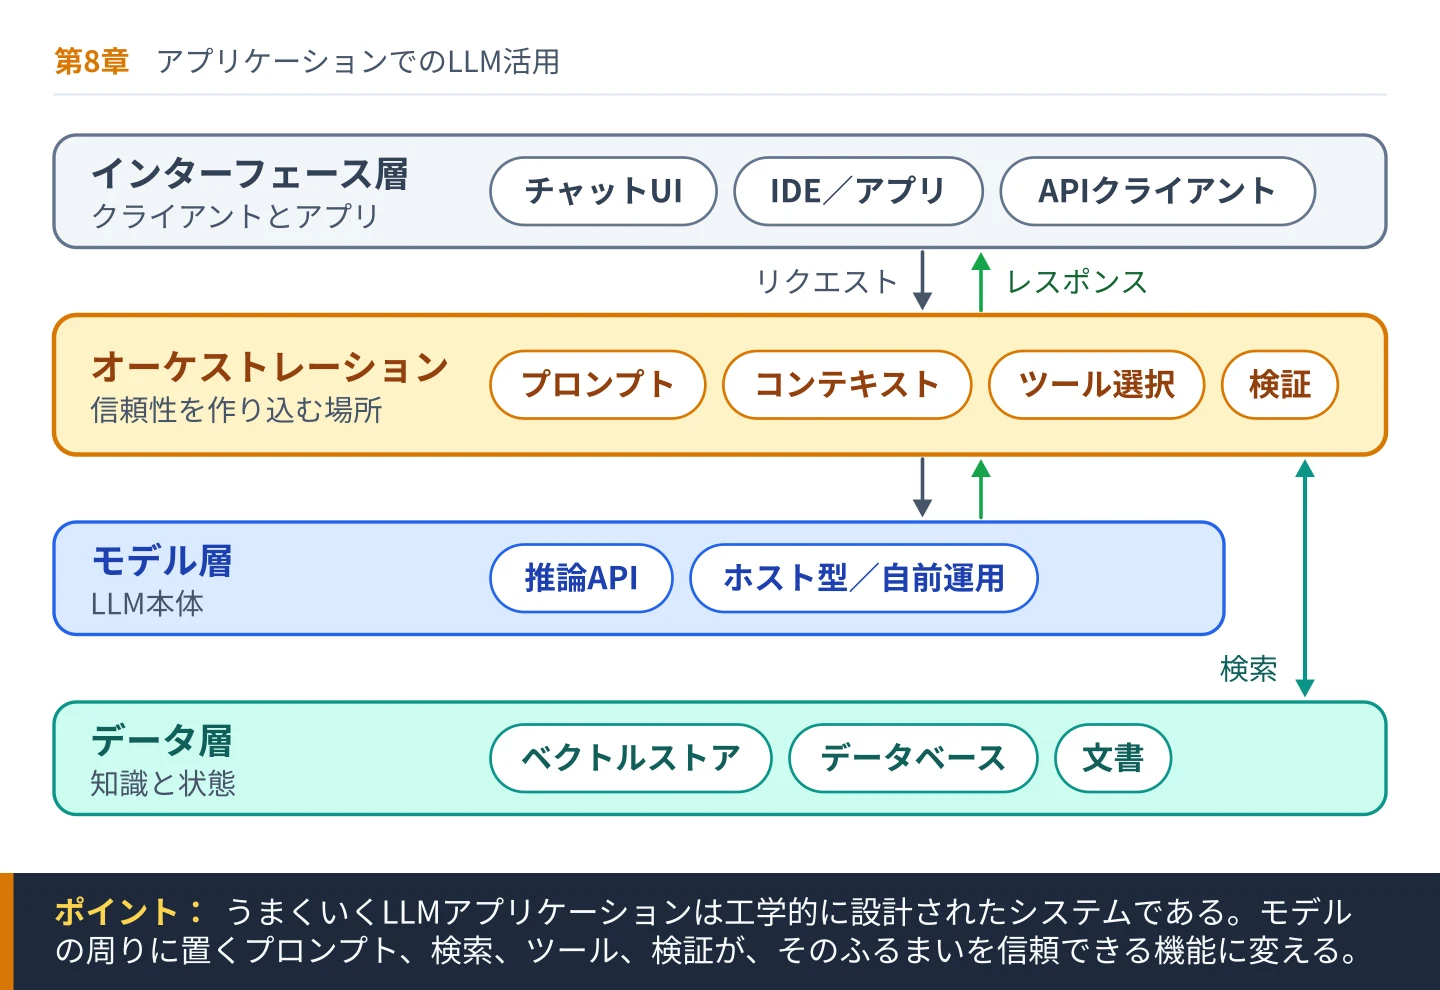
ここまでで、大規模言語モデルがどのように作られ、学習され、適応されるかは理解できたはずだ。しかし、仕組みを理解することは話の一部にすぎない。モデルの真価が問われるのは、ユーザーが頼りにするシステムの中でどう振る舞うかである。第8章では理論から応用へと移り、LLMが製品、ワークフロー、ツールにどのように組み込まれているかを見ていく。
本章が焦点を当てるのは、アプリケーションの設計パターンである。LLMが単独で動くことはまれで、通常はオーケストレーションのロジック、検索層、構造化されたプロンプト、評価パイプラインに包まれている。問うべきは「モデルは何を生成できるか」だけではない。「信頼できる結果を得るために、モデルの周りにどのようなシステムを設計すべきか」である。
8.1節「チャットボットと対話エージェント」では、LLMのもっとも目に見える用途の一つである対話型インターフェースを取り上げる。対話状態の管理、コンテキストウィンドウ、システムプロンプト、メモリの戦略、安全のためのガードレールを検討する。対話が単発のプロンプトとどう違うのか、構造化された制御がどのように信頼性を高めるのかを論じる。
8.2節「要約と検索」では、LLMが情報を凝縮し、検索システムを強化するためにどう使われているかを分析する。抽出型要約と抽象型要約の違い、クエリ拡張、検索拡張型のパイプラインがどのように精度を高めるかを検討する。要約タスクに特有の評価の難しさにも触れる。
8.3節「コード生成とアシスタント」では、言語モデルが開発者をどう支援しているかを見る。コードで学習することがモデルの振る舞いをどう変えるか、複数ファイルにまたがるプロジェクトでコンテキストが果たす役割、安全でない提案や誤った提案をガードレールでどう防ぐかを分析する。この節では、構造化されたプロンプトと反復的な改善の重要性を強調する。
8.4節「知識抽出」では、LLMが非構造化テキストを構造化データに変換する方法を探る。エンティティ抽出、分類、レポート生成といったタスクを、実運用のワークフローの文脈で検討する。スキーマの設計、出力の検証、データベースや下流システムとの統合についても論じる。
8.5節「評価と反復」では、展開は一度きりの出来事ではないことを強調する。モデルは継続的に評価されなければならない。定量的な指標、人によるレビューのループ、A/Bテスト、プロンプトやパイプラインの反復的な調整について論じる。信頼できるシステムは、一度のデモの成功からではなく、体系的な評価から生まれる。
8.6節「ベンチマークとモデル選定」では、モデルの発表でもっともよく引用される公開ベンチマークを概観し、それぞれが実際に何を測っているのかを説明する。そのうえで、ベンチマークは大まかなふるいとして役立つものであり、特定のアプリケーションへの適合性を示す証拠にはならないと論じる。
8.7節「エージェント型・ツール利用のパターン」では、モデルが構成要素ではなく制御役になるアーキテクチャを取り上げる。モデルはどのツールを呼び出すかを決め、結果を読み、タスクがいつ完了したかを判断する。構造化されたツール呼び出し、それが生み出す推論処理のループ、そしてそこから生じるエンジニアリング上・安全上の懸念について論じる。
まずは、多くのユーザーがLLMに触れるもっともなじみのある入口、対話システムから始めよう。
8.1 チャットボットと対話エージェント
対話型インターフェースは、大規模言語モデルのもっとも目に見える姿である。ユーザーがメッセージを入力すると、システムが自然言語で応答する。この単純さの裏には、プロンプト、コンテキスト管理、安全の仕組み、ときには検索やツール利用を協調させる階層的なアーキテクチャがある。信頼できる対話エージェントを設計するには、モデルのAPIを呼び出すだけでは足りない。
かみくだいて言うと
チャットボットは「モデルそのもの」ではない。モデルの周りには、それまでの会話の内容を記録し、どのツールを使うかを決め、安全性を確認し、応答を整形するシステムがある。モデルはその構成要素の一つであり、もっとも目立つ部分にすぎない。よいチャットボットの設計とは、主にモデルの周りをどう作るかということである。
チャットボットは、本質的には複数ターンにわたる条件付き生成器として動く。各応答は、コンテキストウィンドウ内の会話履歴全体にもとづいて生成される。そのため、コンテキストの管理が中心的な課題になる。会話が長くなるにつれて、システムは何を残し、何を要約し、何を捨てるかを決めなければならない。管理を怠ると、コンテキストウィンドウはすぐに埋まり、コストが増え、一貫性が損なわれる。
システムプロンプトは、振る舞いに対する初期の制約を与える。システムプロンプトでは、口調、役割、境界、安全方針などを定める。たとえば、簡潔に答える、推測を避ける、安全でない依頼は断る、といった指示を与える。モデルはそれまでのすべてのトークンを条件とするので、システムプロンプトはターンをまたいで一貫した影響を及ぼす。この層の設計には明確さと正確さが求められる。あいまいな指示からは、あいまいな制御しか得られない。
会話の状態は、明示的にも暗黙的にも管理できる。単純なシステムでは、ターンごとに会話全体をモデルに渡し直す。より高度なシステムでは、古いターンを要約してコンパクトな表現にまとめる。要約によって、重要な文脈を保ったままトークン数を減らせる。短期的な会話のコンテキストと、外部に保存した長期メモリを分け、必要に応じて過去のやりとりから関連するものを検索するアーキテクチャもある。
対話システムでは、安全性とガードレールが欠かせない。ユーザーの入力は予測できないため、システムは生成の前後にコンテンツフィルタを組み込むことが多い。生成前のフィルタは有害なプロンプトをふるい分け、生成後のフィルタは応答がユーザーに届く前にそれを評価する。より高度な手法では、構造化された応答形式や制約付きデコーディングを使って、望ましくない出力を減らす。これとは別の種類の脅威がプロンプトインジェクションである。ユーザーの入力、検索された文書、ツールの結果の中に指示を紛れ込ませ、システムプロンプトを上書きしようとする攻撃だ。モデルは、コンテキストの中の信頼できる指示と信頼できないデータを確実に区別できない。そのため、プロンプトインジェクションは現在、LLMアプリケーションにとって最大のセキュリティリスクとして広く位置づけられている。防御策としては、入力の分離、ツールへのアクセスを最小限の権限に絞ること、影響の大きい操作に人の確認を求めることを組み合わせる。
ツールとの連携によって、対話の能力は広がる。チャットボットは、パラメトリックな知識だけに頼るのではなく、モデルが生成した関数呼び出しにもとづいて、計算機、データベース、APIなどの外部ツールを呼び出せる。モデルはユーザーの意図を解釈し、適切なツールを選び、その出力を応答に組み込む。この設計によって、チャットボットは単独の生成器ではなく、全体をまとめるオーケストレーターになる。
対話システムの評価は、静的なタスクの評価とは異なる。ターンをまたいだ一貫性、ペルソナの一貫性、事実への根拠づけ、制約の遵守をすべて測らなければならない。とくにカスタマーサポートや助言を行うシステムのように微妙な判断が求められるタスクでは、対話の質を評価するために人によるレビューが必要になることが多い。
したがって、よく設計された対話エージェントは、単なるモデルではなくシステムである。プロンプトの構造、メモリ管理、安全方針、外部との連携は、根底にあるニューラルネットワークと同じくらいユーザー体験を左右する。
対話はターンをまたいだやりとりに重きを置くが、実際のアプリケーションの多くでは、大量の情報を効率よく処理することが求められる。
8.2 要約と検索
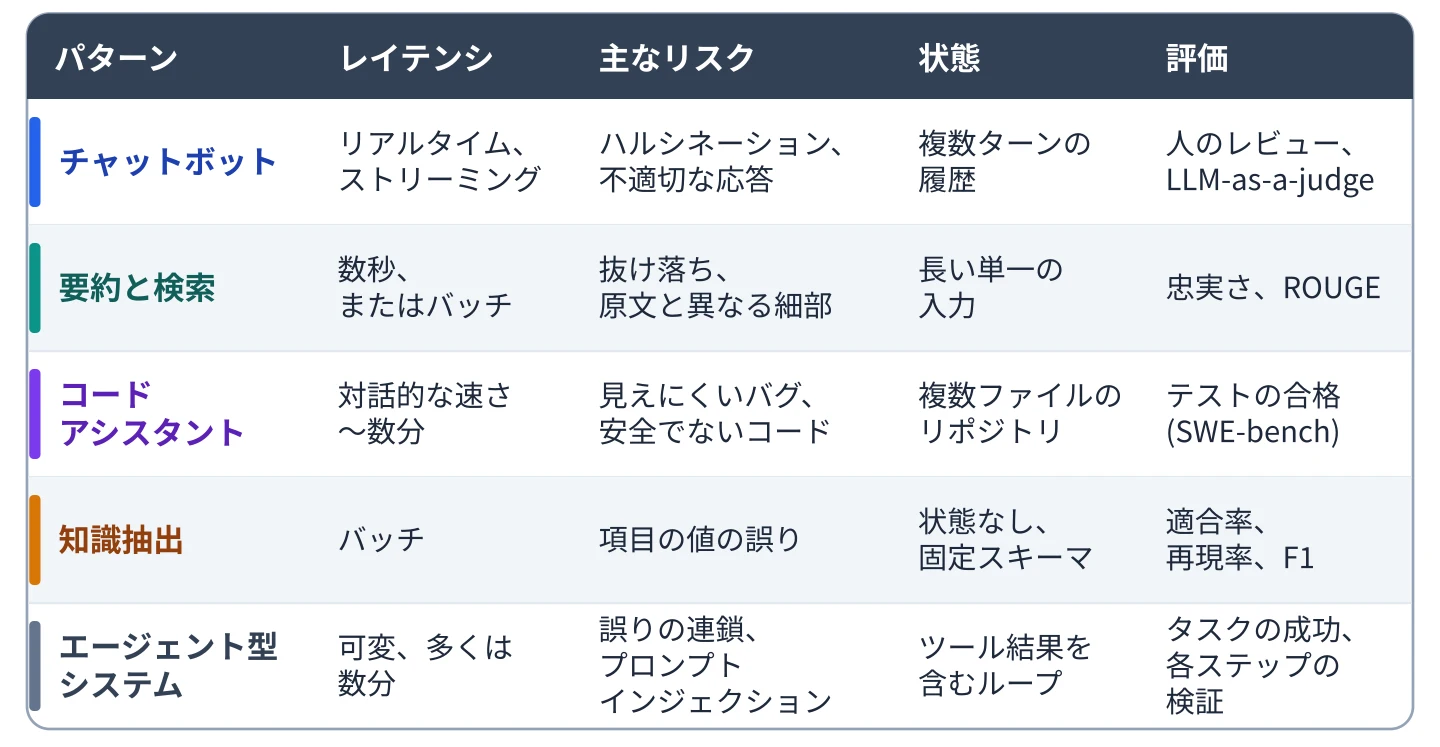
要約と検索は、大規模言語モデルのもっとも実用的な応用の二つである。どちらも大規模なコーパスの中の情報を凝縮したり探し出したりするものだが、その働き方は異なる。LLMがこれらのタスクをどう強化するかを理解すると、確率的な生成と検索の仕組みが現実のシステムの中でどう組み合わさっているかが見えてくる。
かみくだいて言うと
要約は、長い文章を意味を保ったまま短くすることである。LLMを使った検索は、一致する単語だけでなく一致する考えを探す。だから、元の文書が一度も使っていない言い回しの質問にも答えられる。この二つを組み合わせると、関連する資料を見つけ出し、それをかみくだいて伝えてくれるシステムができる。
要約の目的は、長い文章を本質的な意味を保ったまま短い形にまとめることである。主なアプローチは二つある。抽出型と抽象型だ。抽出型要約は、元の文章から重要な文をそのまま選び出す。これに対して抽象型要約は、内容を言い換えたり統合したりした新しい文を生成する。大規模言語モデルは文脈を条件として筋の通ったテキストを生成するように学習しているので、抽象型要約を得意とする。
要約システムの設計は、「これを要約して」とプロンプトを書くだけでは終わらない。コンテキスト長の上限によって、一度に処理できる入力の量は制約される。非常に長い文書には、階層的な戦略がよく使われる。文書をチャンクに分け、チャンクごとに要約し、さらにその要約を要約する。この段階的な方法なら、構造を保ちながら規模の拡大にも対応できる。
要約の評価は難しい。ROUGEのような自動指標は、生成された要約と参照要約の間の語句の重なりを測るが、意味の忠実さを十分にはとらえられない。言い回しが違っていても正確な要約はありうる。とくに影響の大きい分野では、人による評価が今も必要とされることが多い。
一方、検索は情報を凝縮するのではなく、関連する情報を取り出すことに重点を置く。従来の検索エンジンは、キーワードの一致と順位づけのアルゴリズムに大きく依存していた。LLMを使ったシステムは、意味の理解によって検索を強化する。クエリと文書を埋め込みに変換することで、セマンティック検索は正確な言い回しではなく意味にもとづいて情報を取り出す。実際には、実運用のシステムは通常この二つを組み合わせている。ハイブリッド検索でキーワード検索と埋め込み検索の結果を統合し、上位の候補をリランキング用のモデルで採点し直してから生成側に渡す。埋め込みだけでは、正確な識別子、名前、まれな用語を取りこぼすことがあるからだ。
今では主流になったパターンに、検索と要約を組み合わせるものがある。リンクの一覧を返す代わりに、システムが関連文書を検索し、それらを統合した簡潔な回答を生成する。この方法はユーザー体験を向上させるが、生成が検索された根拠の範囲を超えるとハルシネーションのリスクが生じる。適切なシステム設計によって、生成を検索されたテキストに根拠づけ、できれば引用も含めるようにする。よりエージェント的な変種はディープリサーチ(deep research)と呼ばれることが多い。モデルが数秒ではなく数分をかけて何度も検索を行い、結果を読み、クエリを練り直してから、引用付きのレポートを書く。これは8.7節で説明するツール利用のループに沿った動きである。
もう一つの重要な考慮点がクエリ拡張である。LLMは、検索の前にユーザーのクエリを言い換えたり明確にしたりして、検索の精度を高められる。また、細かな基準にもとづいて結果を絞り込んだり順位づけたりすることもできる。この意味で、LLMは従来の情報検索システムの上に乗る推論の層として働く。
コストとレイテンシも設計に影響する。要約とセマンティック検索は、とくに文書の数が多い場合、計算の負荷が大きくなりうる。効率のよいインデックス作成、キャッシュ戦略、慎重なコンテキスト管理が、大規模でも性能を保つ助けになる。
対話や要約といった自然言語のタスクにとどまらず、LLMはソフトウェア開発のワークフローにも深く組み込まれるようになった。
8.3 コード生成とアシスタント
コード生成は、言語モデリングの自然な延長である。ソースコードも自然言語と同じように、構文と意味に支配されたトークンの系列である。多くの大規模言語モデルは、事前学習の段階で自然言語のテキストと並んでコードのリポジトリにも触れている。その結果、プログラムの構造、よく使われるAPI、慣用的な書き方、誤りを生みやすいパターンを学んでいる。
かみくだいて言うと
プログラムのコードも言語の一種で、文法がより厳密なだけである。大量のコードで学習したモデルは、コードの続き、関数まるごと、バグの修正案などを提案できるようになる。こうしてできたアシスタントは、いつも正しい自律的なプログラマーとしてではなく、人がレビューする前提の協力者として使うのがもっともうまくいく。
実際のアプリケーションでは、コードアシスタントは開発環境に組み込まれた条件付き生成器として動く。ユーザーは書きかけのコード、コメント、あるいはタスクの自然言語による説明を与える。モデルは続くトークンを予測し、補完、関数全体、ときには複数ファイルにわたるひな形を提案する。モデルは直前のコンテキストを条件とするので、提案にはその場の変数名、関数のシグネチャ、プロジェクト固有の規約が反映される。
しかし、効果的なコードアシスタントには、単純な生成以上のものが必要である。コンテキストの管理が決定的に重要になる。現実のプロジェクトは複数のファイルやモジュールにまたがっている。短いコード片だけを含むプロンプトでは、筋の通った提案を生み出すには足りないことがある。高度なシステムは、関連するプロジェクトのファイルやドキュメントを検索し、モデルのコンテキストウィンドウに含める。これはソフトウェア開発の分野における検索拡張生成といえる。
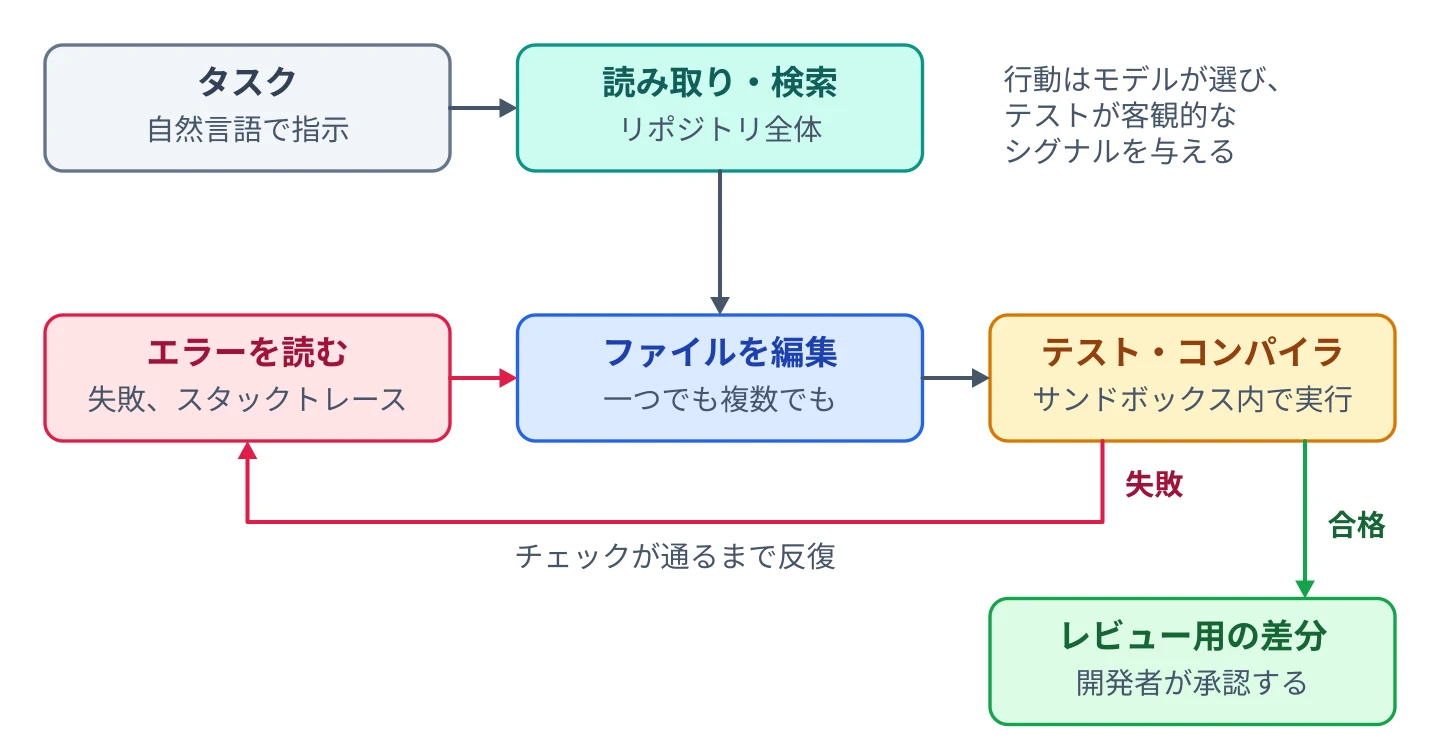
コード生成では正確さが何よりも重要である。対話のテキストと違い、コードはコンパイルが通り、正しく動かなければならない。システムには、生成されたコードを検証するために静的解析ツールやテスト実行のパイプラインが組み込まれることが多い。反復的な改善もよく行われる。開発者が提案をレビューし、編集し、再びモデルに指示を出す。この意味で、コードアシスタントは自律的なプログラマーではなく、協働するパートナーとして機能する。それでも、最先端はエージェント型のコーディングツールへと移ってきた。自然言語でタスクを与えられると、モデルはリポジトリを読み、複数のファイルを編集し、サンドボックスの中でテストスイートやコンパイラを実行し、エラーを読み取って、チェックが通るまで反復する。テストの実行は、多くのテキストタスクにはない客観的なシグナルを与えてくれる。コーディングがエージェント型システムのもっとも成熟した分野になったのはこのためである。開発者の役割は、タスクを定めることと、その結果の変更をレビューすることへと移りつつある。
安全性やライセンスの面での考慮も必要である。公開リポジトリで学習したモデルは、既存のコードに似たパターンを意図せず再現してしまうことがある。学習データの適切なガバナンスと出力のフィルタリングによって、こうしたリスクを抑えられる。さらに、生成されたコードは構文的に正しくても、細かな論理の誤りを含んでいることがある。人による監督は依然として欠かせない。
こうした課題はあっても、コード生成システムは大規模言語モデルの汎用性をよく示している。プログラミング言語を含む多様なコーパスから学ぶことで、LLMは系列をモデル化する能力を自然言語の外にまで一般化している。
コード生成が構造化された出力を作り出すことに重点を置く一方で、多くの企業向けアプリケーションでは、非構造化テキストから構造を取り出すことが求められる。
8.4 知識抽出
大規模言語モデルの応用のすべてが文章の生成を伴うわけではない。多くの企業の現場では、目的はその逆である。非構造化テキストを、下流のシステムが処理できる構造化データに変換することだ。知識抽出では、LLMを使ってエンティティを特定し、内容を分類し、スキーマに値を埋め、文章で書かれた情報を機械が読める形に変換する。
かみくだいて言うと
知識抽出は、文章を書くことの逆である。モデルは雑多なテキストを読み、構造化された項目を出力する。請求書を渡せば、金額、日付、取引先を取り出す。職務経歴書を渡せば、役職名と在籍期間を取り出す。これは、LLMがビジネスの現場ですぐに役立つことの代表例である。
従来の情報抽出は、ルールベースのシステムや、狭いタスク向けに学習した専用の分類器に頼っていた。大規模言語モデルは、より柔軟な代替手段を提供する。幅広い言語的パターンを内部に取り込んでいるので、固有表現認識、関係抽出、構造化されたテンプレートへの要約、分類を、一つの統一的な枠組みの中で行える。
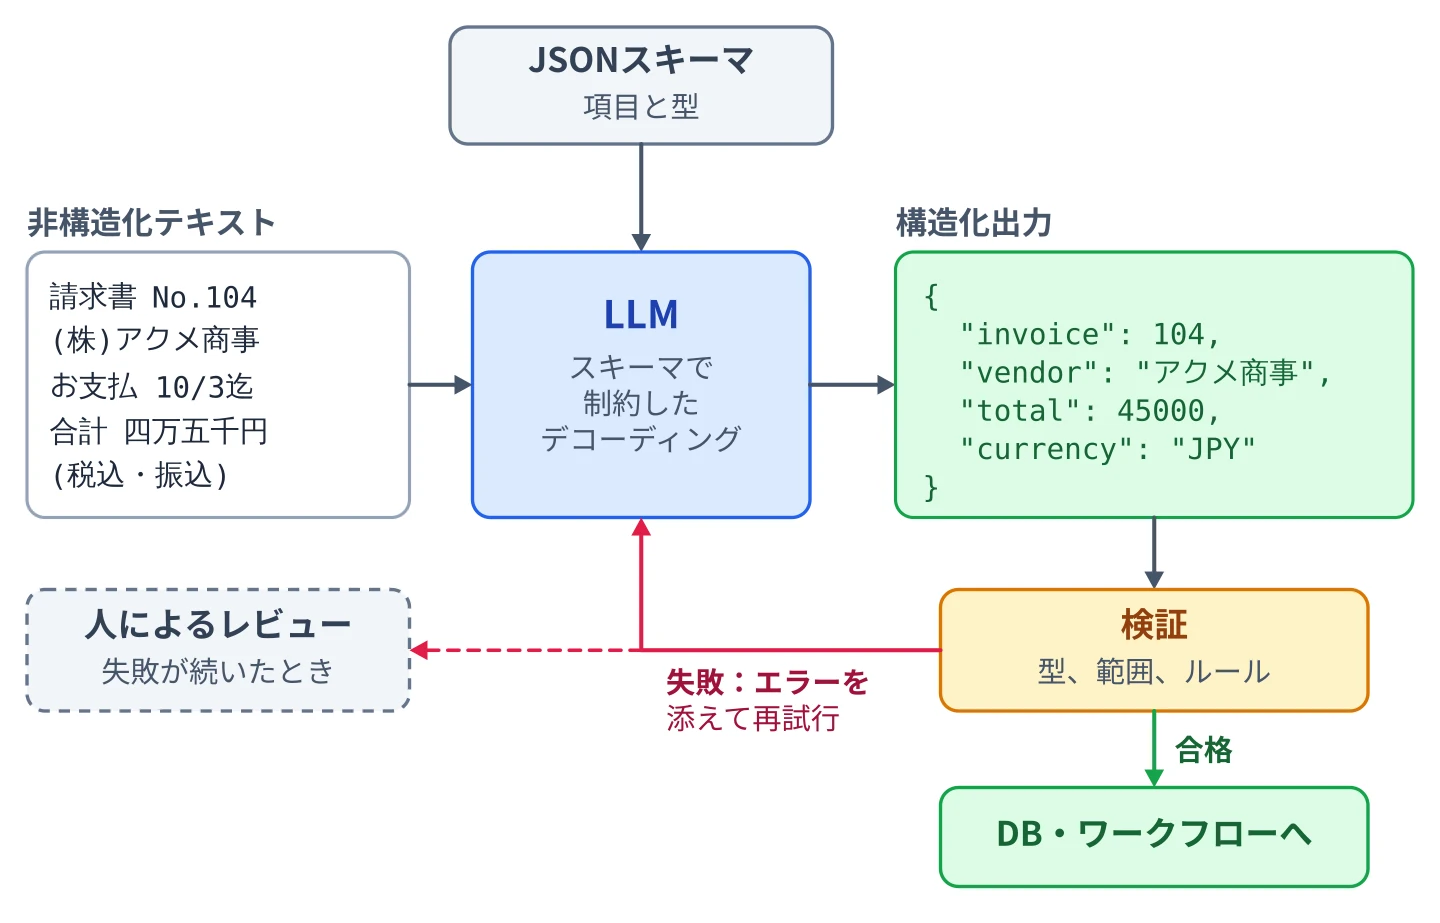
典型的な知識抽出のパイプラインは、スキーマを定義するところから始まる。たとえば、会計書類から請求書番号、日付、合計金額、取引先名、明細行を取り出す必要があるとする。プロンプトでは、JSONのような構造化された形式で結果を出力するようモデルに指示する。この構造を条件とすることで、モデルは自由な形式のテキストをあらかじめ定めた項目に対応づける。
信頼性が決定的に重要である。対話の出力と違って、抽出されたデータはデータベースや自動化されたワークフローに直接流れ込むことが多い。そのため、検証の層が欠かせない。システムは通常、モデルの構造化出力をパースし、スキーマの制約に照らしてチェックする。項目の欠落、型の不一致、形式の崩れた応答があれば、再試行やフォールバックの処理を起動する。制約付きデコーディングは、生成中に選べるトークンを、文法やJSONスキーマのもとで出力が有効であり続けるものだけに制限することで、形式の誤りを減らす。現在では多くのモデルAPIやオープンソースの推論サーバーが、構文的に有効でスキーマに準拠した出力を保証する「構造化出力(structured output)」モードとして、この機能を提供している。ただし、スキーマに準拠していても値が正しいとは限らない。抽出された内容の意味的な検証は、依然として必要である。
もう一つの設計上の考慮点は一貫性である。抽出タスクでは、決定的な振る舞いが望ましい。温度の設定を低くすれば出力のばらつきは減る。ただし、ホスティングされたサービスでは、温度を0にしてもビット単位で同一の結果が得られるとは限らない。サーバー側でリクエストがどうバッチ処理されるかによって、浮動小数点演算の結果が変わりうるからだ。また、推論に特化したモデルの中には、サンプリングのパラメータを制限したり無視したりするものもある。したがって、一貫性は温度だけに頼るのではなく、スキーマ、検証、固定したプロンプトによって確保するほうがよい。大量の処理では、キャッシュやバッチ処理の戦略によって効率とコスト管理が改善する。
知識抽出に検索を組み合わせることもできる。たとえば、長い報告書から構造化された情報を取り出す場合、モデルに指示を出す前に、まず関連する箇所を検索する。これにより、コンテキストのノイズが減り、精度が高まる。
抽出システムの評価は、生成タスクの評価とは異なる。適合率(precision)、再現率(recall)、F1スコアといった指標で、正解ラベルと比べて項目がどれだけ正確に埋められているかを測る。分野固有のワークフローでは、性能が安定するまで人によるレビューが必要になることもある。
知識抽出は、LLMの汎用性を際立たせる。LLMは流暢な文章の生成器であるだけでなく、非構造化の文章と構造化データの間の翻訳者でもある。この二つの能力によって、さまざまな業界での有用性が広がっている。
対話、要約、コード支援、構造化された抽出と応用が広がるなかで、最後に問われるのは、システムの性能を時間をかけてどう測り、どう改善していくかである。
8.5 評価と反復
LLMを使ったアプリケーションの展開は、プロセスの終わりではなく、反復のサイクルの始まりである。静的なソフトウェアの部品と違い、大規模言語モデルは確率的なシステムであり、その振る舞いはプロンプトの設計、データの分布、システムの構成に左右される。そのため、評価と反復は継続的に担うべき責任となる。
かみくだいて言うと
LLMの出力は確率的なので、通常のソフトウェアと同じ方法ではテストできない。代わりに、自動の採点、人によるレビュー、実際の利用状況の継続的な監視を組み合わせて評価する。LLMを使った機能のリリースは、プロジェクトの終わりではなく、改善のループの始まりである。
評価は、成功とは何かを定義するところから始まる。タスクによっては定量的な指標が使える。要約では、ROUGEのような重なりにもとづくスコアが大まかな目安になる。知識抽出では、ラベル付きデータセットに対して適合率と再現率を測れる。分類なら、正解率やF1スコアで足りることもある。しかし、生成タスクの多くには、わかりやすい自動の指標がない。流暢さ、有用性、一貫性、安全性は数値にしにくい。広く使われている妥協策は、強力な言語モデルを評価者(LLM-as-a-judge)として使い、書面の評価基準に照らして出力を採点させたり、二つの候補を並べて比較させたりする方法である。モデルによる評価は安価に規模を広げられるが、長い回答を好む、自分と同じ文体を好む、先に提示された候補を好むといったバイアスがあることが知られている。そのため、そのスコアは定期的に人の評価と照らし合わせて較正する必要がある。
人による評価は、自動テストを補うことが多い。構造化されたレビューのプロセスで、正確さ、口調、バイアス、ガイドラインの遵守を評価する。対話エージェントであれば、レビュー担当者が複数ターンにわたる一貫性や矛盾のなさを確認する。影響の大きい分野では、事実としての信頼性を評価するために、その分野の専門家が必要になることもある。
A/Bテストも重要な手段である。二つのプロンプト設計、モデルのバージョン、パイプラインの構成を実際のトラフィックで比較することで、現実の環境での効果を測れる。ユーザー満足度、タスクの完了率、レイテンシといった指標が、どちらの設計が優れているかの判断材料になる。反復の中では、プロンプトの調整、検索戦略の変更、温度パラメータの調整、モデル規模の切り替えなどを行う。
本番環境での監視も同じくらい重要である。モデルの入力と出力を(適切なプライバシー保護のもとで)記録しておけば、継続的な分析ができる。ドリフト検出によって、ユーザーのクエリの分布が変化し、性能が落ちているおそれがある状況を見つけられる。想定外の振る舞いには、レビューのための目印を付けられる。監視がなければ、表に出ない失敗が気づかれないまま続きかねない。
コストとレイテンシも反復に影響する。より高性能なモデルを使えば出力の質は上がるかもしれないが、費用や応答時間は増える。エンジニアリング上の判断では、性能の向上と運用上の制約とのバランスをとらなければならない。小さなモデルとよく最適化したプロンプトの組み合わせで、より低いコストで十分な品質が得られることもある。
安全性の評価には、専用の取り組みが必要である。システムは、敵対的なプロンプト、センシティブな話題、エッジケースに対してテストされなければならない。レッドチーミング演習では、悪意のある使い方や想定外の使い方を模擬する。反復の中では、ガードレールを強化したり、指示チューニングを見直したりすることが多い。
反復は、問題が起きてから対応するだけのものではなく、先回りして行うものでもある。新しい使い方が現れるにつれて、評価の基準も変わりうる。継続的な改善は、LLMシステム設計の本質的な特徴である。これらのモデルは確率的な性質を持つので、個別の事例による印象評価ではなく、体系的な測定が求められる。
さらに深く:評価と本番環境での監視については、LLM Primer V — Building Real-World LLM Applications(英語版)の第5章「Evaluating LLM Applications」と第6章「AI Observability and Tracing」で詳しく扱う。
ポイント:LLMの効果的な展開は、定量的な指標、人によるレビュー、安全性テスト、運用上の制約にまたがる継続的な評価にかかっている。反復こそが、時間をかけてシステムの信頼性を形づくる。
8.6 ベンチマークとモデル選定
LLMの文献では、いくつかのベンチマークが標準的な参照点になっており、論文やリリースノートを読むエンジニアは何度もそれらに出会う。非公開でタスク固有のデータで評価するアプリケーションを作る場合でも、それぞれのベンチマークが何を測っているのかを実務的に知っておくと役に立つ。以下は、モデルの発表や比較表でもっともよく引用されるベンチマークである。
| ベンチマーク | 測っているもの |
|---|---|
| MMLU | 57の学術・専門分野にわたる多肢選択式の試験。事実の知識と推論の知識の幅を測る。最先端のモデルは上限近くのスコアに達しているため、より難しい後継のMMLU-Pro(選択肢10個、推論の比重が大きい問題)が代わりに報告されることが増えている。 |
| GPQA-Diamond | 専門家が作成し、インターネット検索では解けないことを確認した大学院レベルの物理学・生物学・化学の問題。分野の深い推論を測る。 |
| HumanEval | 単体テスト付きの小さなPythonプログラミング問題。基本的なコード生成の正しさを測る。元の形ではPythonのみだが、MultiPL-Eのような多言語版も作られている。 |
| MBPP | Mostly Basic Python Problems。HumanEvalの姉妹版で、より簡単で多様なタスクを含む。 |
| SWE-bench | オープンソースプロジェクトの実際のGitHubのissueとプルリクエスト(主にPython)。リポジトリのテストスイートを通るパッチをモデルが作れるかを測る。もっともよく報告されるのはSWE-bench Verifiedで、あいまいな問題や解決できない問題を人間のエンジニアが取り除いた500タスクのサブセットである。その後、マルチモーダル版や多言語版も公開されている。 |
| GSM8K | 小学校レベルの算数の文章題。多段階の算術推論を測る定番のテストだが、最先端のモデルではほぼ飽和している。 |
| MATH | 競技レベルの数学の問題。代数、幾何、数論、場合の数と確率、微積分の準備(precalculus)など7分野にわたる。 |
| MMMU | 多くの学問分野にまたがる大学レベルのマルチモーダルな問題。テキストと画像を合わせて理解する必要がある。 |
| LiveBench | 最近の情報源から問題を作り直すことで汚染に強くしたベンチマーク。静的なベンチマークの信頼性を損なう学習データへの漏洩を避けることをねらっている。 |
| ARC-AGI | 人間には簡単で、パターンの暗記に頼るシステムには難しくなるよう設計された抽象的な視覚推論パズル。版を重ねるごとに難度が上がっている。2026年に公開された第3版では、静的なパズルに代えてゲームのような対話型の環境を採用し、ルールを示さない状況での探索と学習を試す。 |
| BFCL | 関数呼び出しのリーダーボード。現実的なAPIスキーマのもとでのツール呼び出しの正しさと頑健さを測る。後の版では、複数ターンのシナリオや、ウェブ検索・メモリ管理といったエージェント型のシナリオが加わっている。 |
| IFEval | 指示追従の評価。長さ、形式、内容のルールなど、検証可能な制約を使う。 |
静的なベンチマークには共通する二つの限界がある。一つは飽和である。最先端のモデルが上限に近づくと、残るスコアの差は能力ではなくノイズやラベルの誤りを反映するようになる。専門家が問題を書き下ろしたHumanity’s Last Examのように、意図的に難しくしたセットが次々と登場するのはこのためである。もう一つは汚染である。テスト問題が学習データに漏れ込むと、根底にある能力は向上しないままスコアだけが水増しされる。また、特定のアプリケーションにとって重要な能力を、単一のベンチマークでとらえることはできない。多段階の推論で首位のモデルが、構造化された抽出やツール利用の信頼性では劣ることもあるし、その逆もある。モデルを選ぶとき、公開ベンチマークは大まかなふるいとしては役に立つ。しかし、展開に適しているかどうかを決めるのは、代表的な入力を使ったアプリケーション固有の評価である。
8.7 エージェント型・ツール利用のパターン
ここまで見てきたアプリケーションは、大規模言語モデルをより大きなシステムの中の構成要素として扱っていた。システムがプロンプトを与え、モデルがテキストを返し、周囲のソフトウェアが検索、検証、配信を担う。これに対して、現在のLLMの展開で中心的な位置を占めるようになった別のアーキテクチャのパターンは、この関係を逆転させる。エージェント型のシステムでは、言語モデルが制御役になる。次に何をするか、どのツールを呼び出すか、タスクがいつ終わったかをモデルが決める。周囲のソフトウェアはツールを提供し、モデルが選んだ行動を実行する。
かみくだいて言うと
エージェント型のシステムでは、モデルが運転席に座る。テキストを出力するだけでなく、計算機、データベース、検索ツールなどのソフトウェアをいつ呼び出すかを決め、結果を読み、次に何をするかを判断する。これにより、モデルはテキストの生成器から、ツールを使う計画者へと変わる。同時に、エンジニアリングと安全性の面で新たな懸念も生まれる。
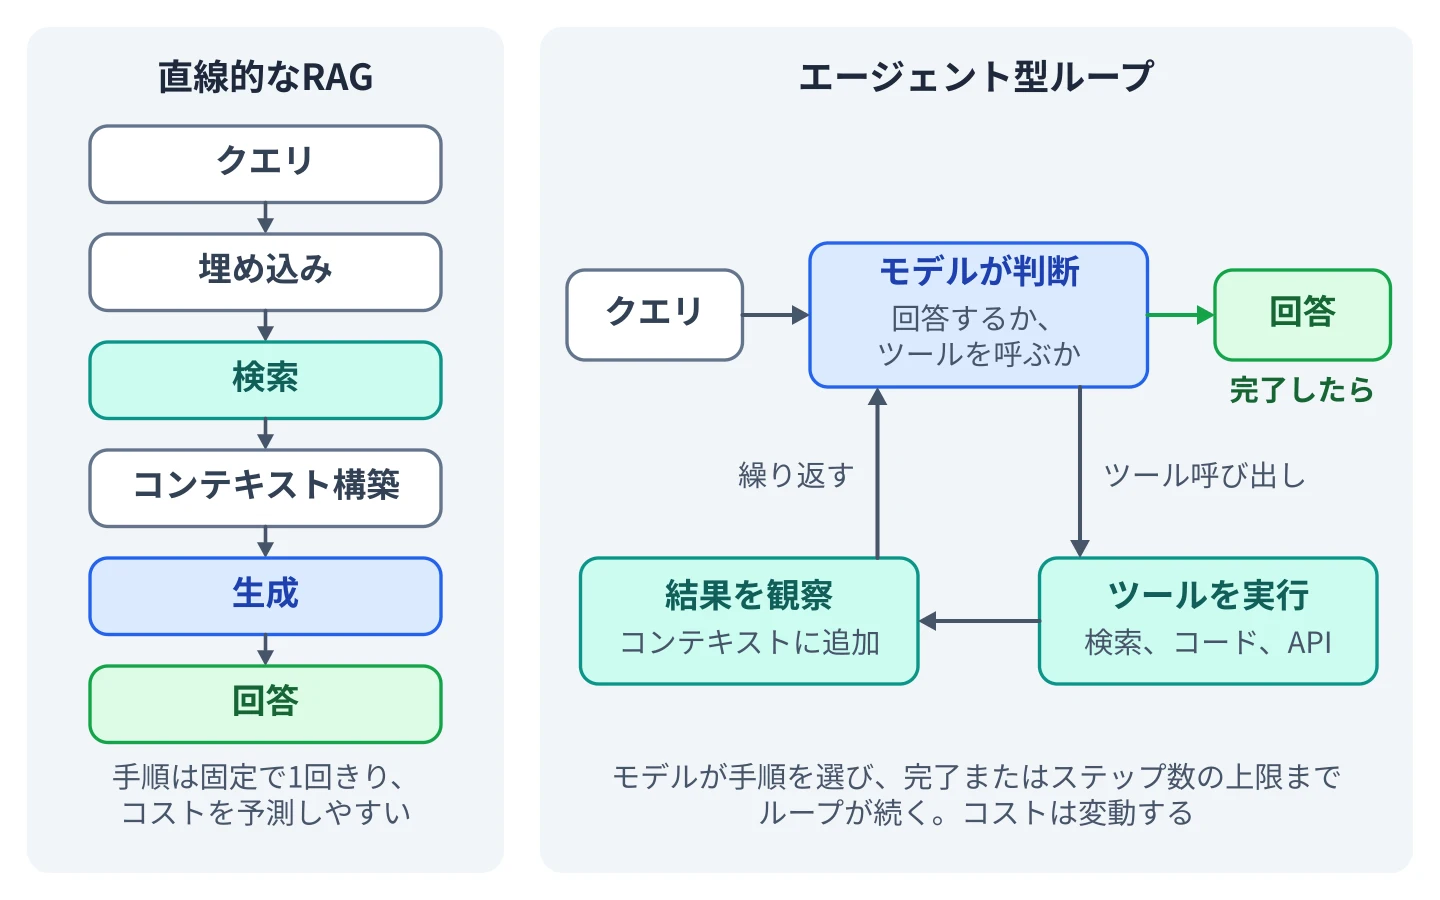
このパターンを成り立たせている仕組みが、構造化されたツール呼び出しである。ツールは関数のシグネチャとしてモデルに説明される。名前、いつ使うべきかを自然言語で書いた説明、引数のスキーマの三つである。生成の途中で、モデルは普通の文章の代わりに構造化された呼び出しを出力することがある。周囲のシステムはその呼び出しをパースし、対応する関数を実行し、結果をモデルのコンテキストに戻して次のステップに進む。モデルの側から見れば、ツール利用とは、一部のトークンが外部環境への呼び出しを表すような生成のパターンである。
これによって、1回の推論処理のリクエストがループに変わる。モデルは現在の会話を読み、応答かツール呼び出しのどちらかを出力する。ツールを呼び出した場合はその結果を受け取り、先へ進む。このループは、モデルが完了を知らせるか、周囲のシステムがステップ数の上限を強制するまで続く。
このパターンは、1回のフォワードパスでは達成できないタスクに使われる。複数の情報源から情報を集める、任意の精度が必要な計算を行う、結果がその後の判断に影響する行動をとる、いくつかの専門的なサブシステムを組み合わせて筋の通った応答にまとめる、といったタスクである。
エージェント型のシステムには、1回きりの生成では生じないエンジニアリング上の懸念がある。外部ツールを呼び出せるループは、予測できない形で資源を消費しうる。また、その振る舞いは呼び出しうるすべてのツールの信頼性に左右される。誤りは伝播する。形式の崩れた出力を返すツールがあると、モデルは失敗を報告する代わりに、もっともらしい続きを作り上げてしまうことがある。
安全面の懸念も大きくなる。モデルが世界を記述するだけでなく、世界に働きかけるようになるからだ。ツールの結果はすべて信頼できない入力として扱う必要がある。エージェントが読むウェブページやメールには、ユーザーが一度も求めていない行動へとエージェントを誘導する指示が仕込まれているかもしれない。そのため、副作用を持つツールの権限は狭く絞り、影響の大きい行動には明示的な確認を求めるべきである。したがって、体系的な評価では、最終的な出力の質だけでなく、各ステップの正しさ、失敗したツール呼び出しからの回復、利用できるツールの範囲が示す境界の遵守も測る。
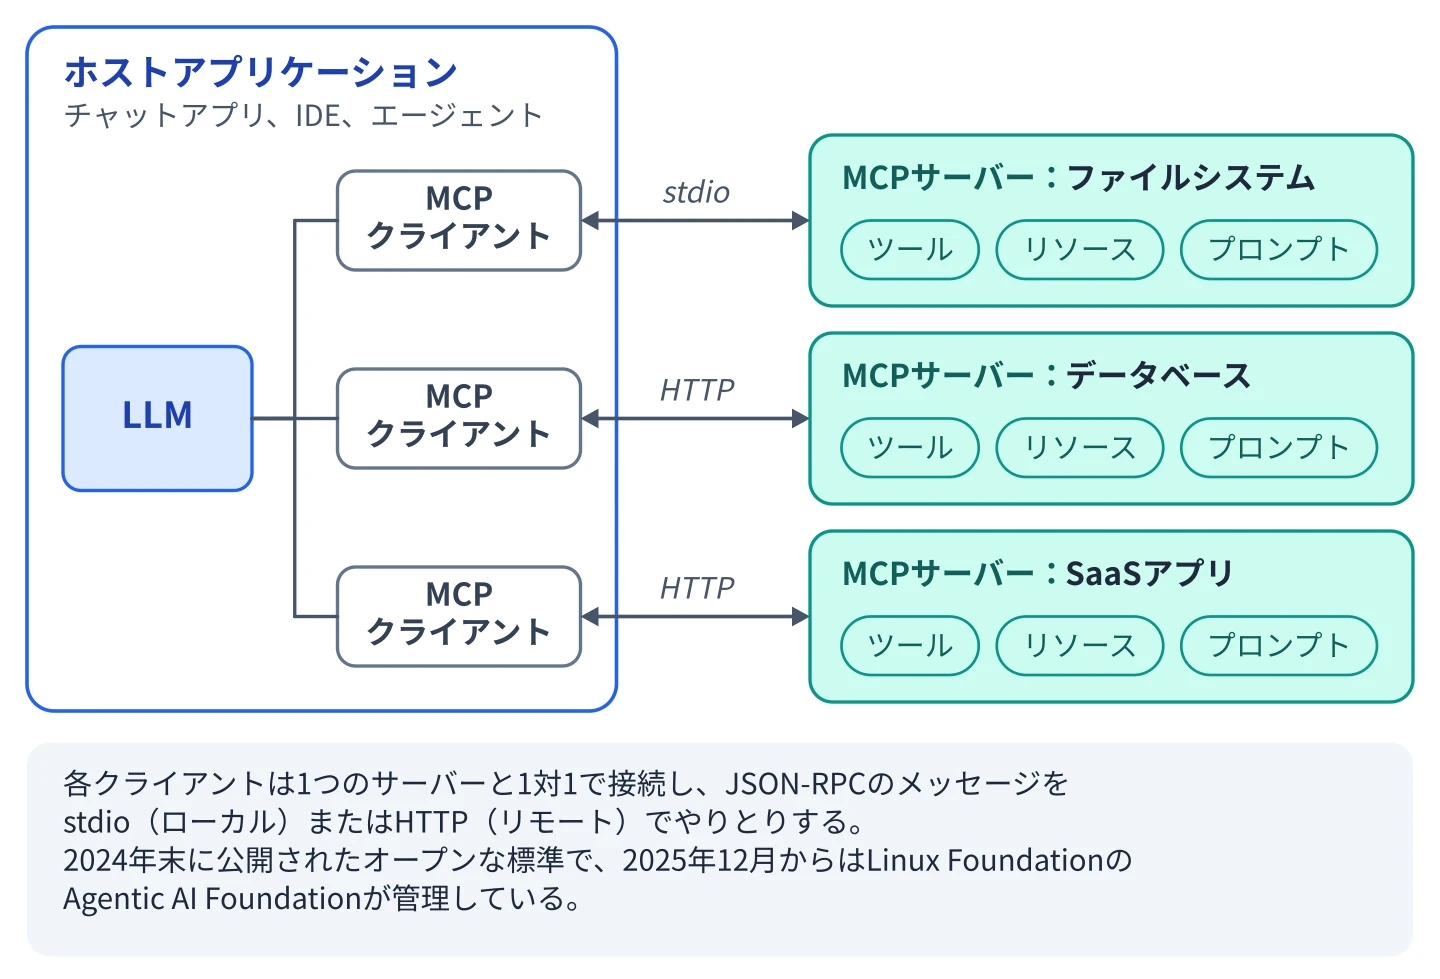
エージェント型の展開が広がるにつれて、相互運用性が実務上の関心事になってきた。ツールをどう記述し、どう認証し、どう呼び出すかをプロトコルのレベルで仕様化すれば、同じツール群を複数のモデル提供元やアプリケーションフレームワークで使える。もっとも広く採用されている例がModel Context Protocol(MCP)である。MCPは2024年末に公開されたオープンな仕様で、2025年12月にLinux FoundationのAgentic AI Foundationの傘下に移された。ツールの定義をモデルの選択から切り離すこの考え方は、それ自体が一つのエンジニアリングの専門分野になっている。
本章の範囲で言えば、実務上の教訓は次のとおりである。エージェント型のシステムは、個別に検証した絞り込まれたツール群として設計するのがもっともよい。言語モデルが担うのは分野の知識ではなく、全体をまとめるオーケストレーションのロジックである。
さらに深く:Model Context Protocol、マルチエージェントのオーケストレーション、エージェントのためのコンテキストとメモリの設計は、LLM Primer IV — Designing AI Cognition with MCP(英語版)のテーマである。API設計や構造化出力を含め、完成したアプリケーションの中でのツール呼び出しについては、LLM Primer V — Building Real-World LLM Applications(英語版)の第4章と付録Cを参照してほしい。
実践的な応用パターンと評価の戦略を見てきたところで、話題は運用の基礎へと移る。次章では、性能、スケーラビリティ、コストが現実の展開をどう形づくるかを検討する。
ポチっとでの実践
依頼を読み取ってから実行するまで
「明日10時に会議を入れて」と「明日10時に知らせて」では使う機能が変わります。依頼の分類、足りない項目の確認、実行、結果の表示を分けると、どこで利用者を待たせたり読み違えたりしたかを調べられます。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る