 Pocchito
第11章 最先端の研究
研究を読むときは、手法の名前とベンチマークの順位に加え、どの条件で何が改善したかを確かめます。
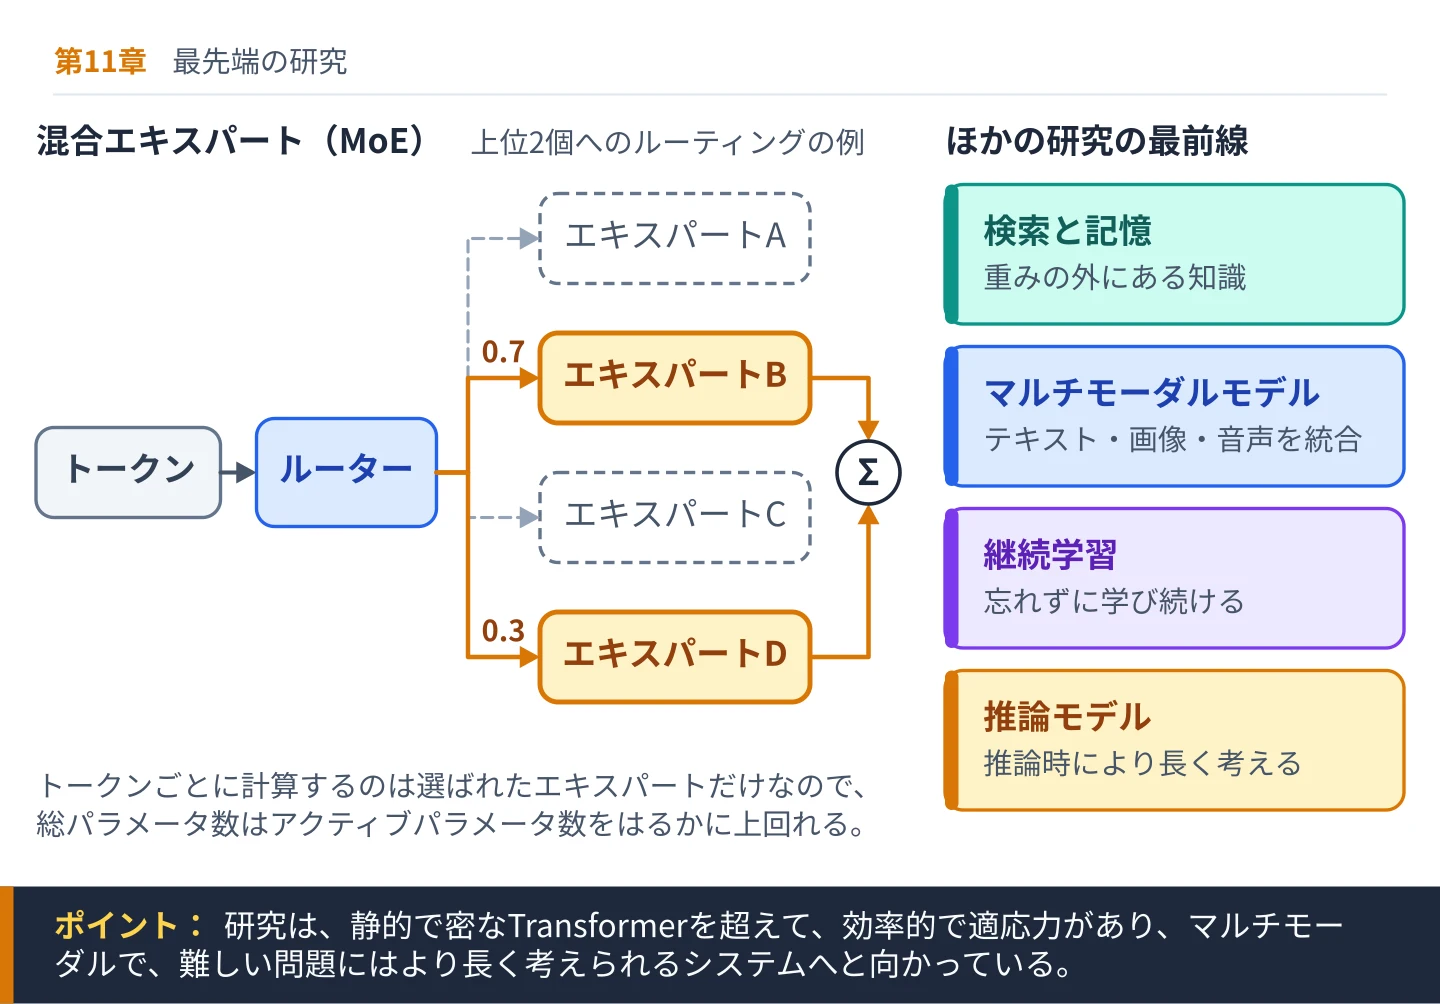
Transformerアーキテクチャと大規模な事前学習は、言語モデルの現代を形づくってきた。しかし、この分野の研究は減速するどころか、むしろ加速している。本章では、モデル設計の最前線を取り上げる。研究者たちが、現在の前提を揺さぶる新しいアーキテクチャのパターン、学習のパラダイム、スケーリングの戦略を探っている領域だ。
本章は、思弁的なアイデアを並べたカタログではない。計算の非効率、知識の境界が固定されていること、モダリティの制約、破滅的忘却といった具体的な限界に取り組む研究の方向性を分析する。こうした方向性を理解すれば、次世代のモデルが今日使われているモデルとどう違ってくるのかが見えてくる。
11.1節「疎モデルと混合エキスパート」では、入力ごとにパラメータの一部だけを活性化させて効率を高めるアーキテクチャを検討する。混合エキスパートは、すべてのトークンに全重みを使う代わりに、入力を専門化したサブネットワークへ動的に振り分ける。これにより、推論1ステップあたりの計算量を比例して増やさずに、パラメータ数を拡大できる。
11.2節「検索と記憶の仕組み」では、ハイブリッドアーキテクチャを研究の視点からあらためて取り上げる。外部記憶の統合、微分可能な検索モジュール、知識の動的な更新を分析する。これらの仕組みは、モデルの重みに埋め込まれた静的なパラメトリック記憶の限界を乗り越えることを狙っている。
11.3節「マルチモーダルモデル」では、テキスト、画像、音声などのモダリティを共有の埋め込み空間で処理する統合アーキテクチャを探る。モダリティ間の注意機構(クロスアテンション)やアラインメントの戦略によって、生成システムの守備範囲が言語の外へどう広がるのかを考える。
11.4節「継続学習と自己教師あり学習」では、破滅的忘却を起こさずに、時間とともにモデルを適応させるアプローチを検討する。1回の事前学習のあと静的に運用するのではなく、段階的な更新と自己教師ありの目的関数によって、継続的な適応を目指す手法だ。
11.5節「推論時スケーリングと推論モデル」では、2つ目のスケーリング軸を取り上げる。学習中にモデルが学ぶ量を増やすだけでなく、回答する時点でモデルが行う計算量を増やすシステムだ。こうしたモデルがどう学習されるのか、そしてレイテンシやコストが一定でなくなることでアプリケーション設計がどう変わるのかを論じる。
11.6節「今後の方向性」では、ここまでの動向と未解決の問いを整理する。スケーリングの限界、アラインメント研究、効率面の制約、そしてこの分野を塗り替えうるアーキテクチャの代替案を論じる。
まずは、スケールと効率を両立させるために考案された、アーキテクチャの中核的なイノベーションから始めよう。
11.1 疎モデルと混合エキスパート
混合エキスパート(Mixture of Experts、MoE)アーキテクチャは、この数年で研究上の目新しい存在から本番のインフラへと移った。主要なフロンティアモデルのファミリーのいくつかは、推論処理でMoEのルーティングを使っている。そのため、このアーキテクチャの仕組みを理解することは、もはや先を見越した学習ではない。大規模モデルについて考えるための基本語彙の一部になっている。
かみくだいて言うと
混合エキスパート(MoE)モデルは、専門化したサブネットワークを数多く持つが、個々の入力に対してはそのうちの少数しか使わない。現代のモデルが、リクエストのたびに全体のコストを払うことなく、とてつもなく大きな総容量を持てるのはこのためだ。多くの専門医がいる病院で、患者に必要な専門医だけを呼ぶのに少し似ている。
言語モデルが大きくなるにつれて、根本的な緊張関係が生じる。パラメータ数を増やせば能力は上がるが、すべての入力に全パラメータを使うと計算コストが膨らむ。密な(dense)Transformerアーキテクチャはトークンごとにネットワーク全体を活性化させるため、推論処理のコストはモデルサイズにそのまま比例する。疎モデルと混合エキスパートアーキテクチャは、総パラメータ数とトークンあたりの計算量を切り離すことで、この緊張関係を解消する。
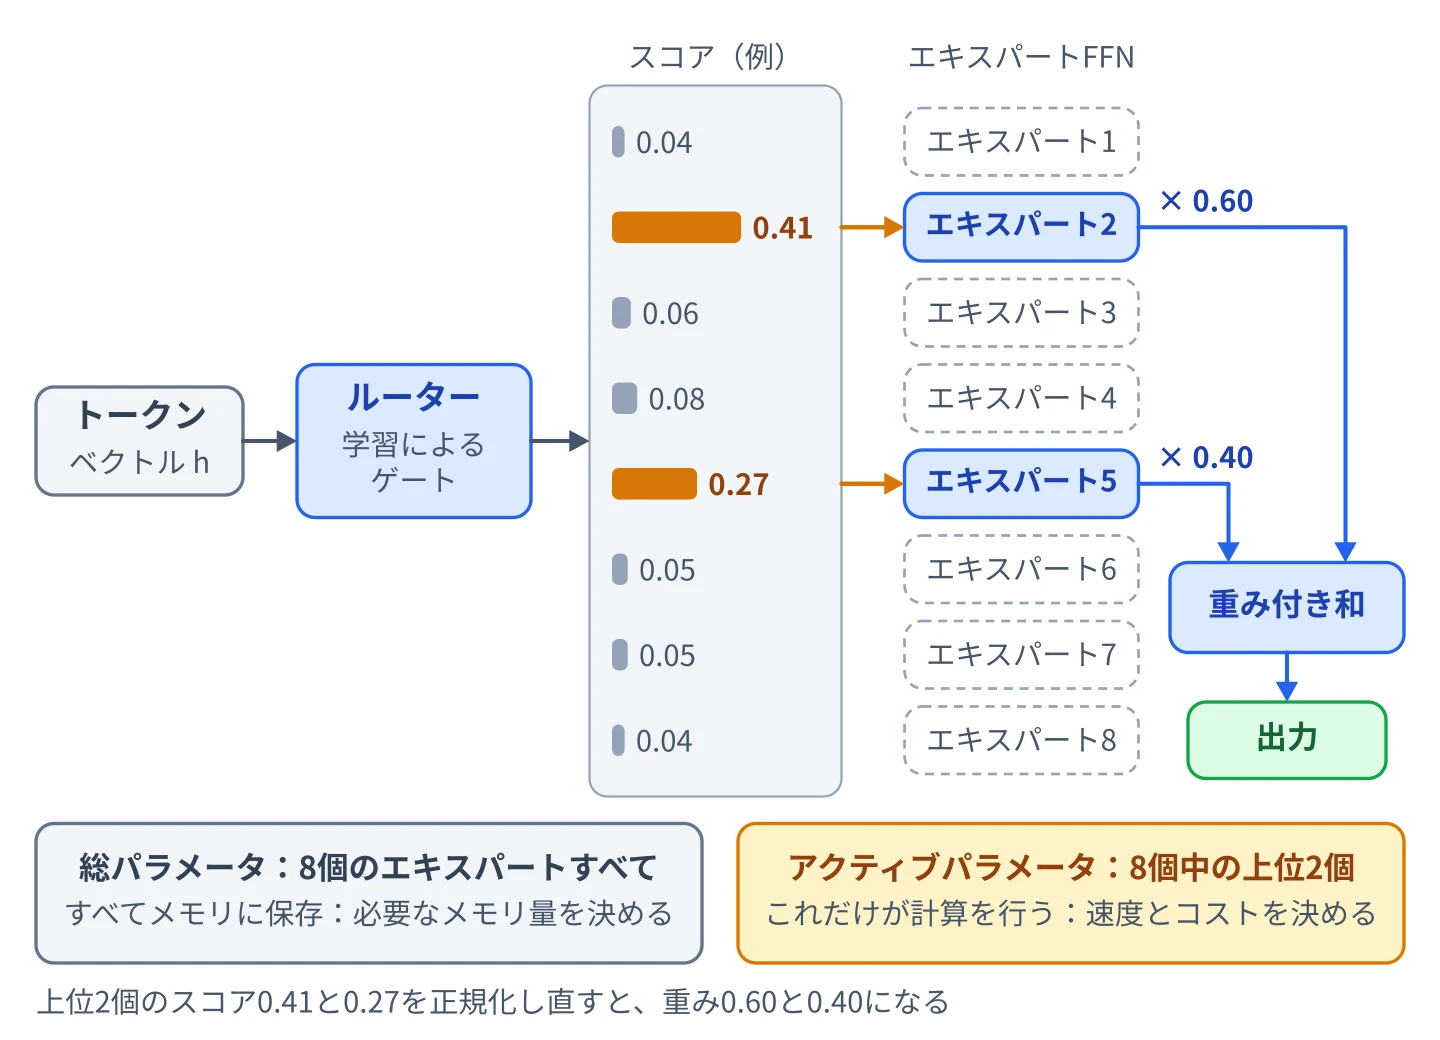
疎性(スパース性)の核心にあるのは、選択的な活性化という考え方だ。疎なアーキテクチャでは、各入力を層内のすべてのニューロンに通すのではなく、入力そのものに応じてパラメータの一部だけを活性化させる。混合エキスパートモデルでは、この考え方が「エキスパート」と呼ばれる専門化したサブネットワークとして形式化されている。各エキスパートは通常、独自のパラメータを持つフィードフォワードネットワークだ。どのエキスパートがあるトークンや系列を処理するかは、ゲーティング機構が決める。
ゲーティングネットワークは、学習によって得られるルーターとして働く。入力トークンの表現ごとに、利用可能なエキスパートに対するスコアを計算し、そのうち1つか少数を選ぶ。多くの場合、スコアの高い上位k個(top-k)のエキスパートを選ぶ。そのトークンの計算を行うのは、選ばれたエキスパートだけだ。その結果、モデル全体のパラメータ数を極めて大きくしながら、トークンあたりの実際の計算量は一定の範囲に抑えられる。
このアーキテクチャにより、トークンあたりの計算量を比例して増やすことなく、パラメータ数を兆単位まで拡大できる。ただし、メモリは話が別だ。すべてのエキスパートを保存し、いつでも使える状態にしておかなければならない。そのため、疎モデルのサービングに必要なメモリ量は総パラメータ数で決まり、速度と計算コストはそれよりはるかに少ないアクティブパラメータの数で決まる。概念的には、エキスパートごとに異なる言語パターン、ドメイン、タスクに専門化しうる。あるエキスパートは科学的な文章に関わる知識を、別のエキスパートは会話的な言葉を、また別のエキスパートはコードのような構文を、暗黙のうちに符号化しているかもしれない。この専門化は人手で割り当てるものではなく、学習の過程で自然に生じる。
一方で、混合エキスパートモデルは新たなエンジニアリング上の課題をもたらす。とくに重要なのが負荷分散だ。ゲーティング機構が大半のトークンを一部のエキスパートばかりに振り分け続けると、それらのエキスパートは過負荷になり、ほかのエキスパートは十分に使われない。エキスパートの利用を均等にするために補助的な学習目的を導入することが多いが、こうした追加の損失項は本来の目的関数と干渉することがある。そこで最近の設計の中には、学習中にルーティングスコアに対するエキスパートごとのバイアスを調整し、追加の損失を使わずに過負荷のエキスパートからトラフィックをそらすものもある。また最近のアーキテクチャは、小さく細分化されたエキスパートを多数使う傾向があり、共通の知識をとらえるために、すべてのトークンが通過する共有エキスパートを1つ以上併用することも多い。
分散学習も複雑になる。トークンごとに活性化するエキスパートが異なるため、ハードウェア間で効率よく並列化するには、綿密な調整が必要になる。デバイス間の通信オーバーヘッドをうまく管理しなければ、計算量の削減分が相殺されてしまう。
理論的な観点から見ると、疎モデルは容量と計算を切り離せることを示唆している。推論の各ステップで比例した実行コストを払わなくても、モデルは膨大な表現容量を持てる。これはスケーリングのとらえ方を変える。密なモデルをどこまで大きくできるかを問うのではなく、大規模なパラメータ空間をいかに効率よく活用できるかを問うようになるのだ。
疎なアーキテクチャは、解釈可能性についての問いも投げかける。エキスパートが専門化するのなら、その内部表現を分析することで、ネットワーク内部にドメインごとの構造的な区分けが見つかるかもしれない。そうした専門化が人間に解釈できるカテゴリーと一致するかどうかは、まだ研究途上の問題だ。
疎モデルが内部の計算を最適化する一方で、別の研究の流れは、静的なパラメータを超えて記憶を拡張することに焦点を当てている。
11.2 検索と記憶の仕組み
標準的な大規模言語モデルは、知識をパラメータの中に暗黙的に蓄えている。学習の過程で、データ中のパターンが分散した重みの配置へと圧縮される。このパラメトリック記憶は強力だが、静的だ。学習が終わったあとに知識を更新するには、再学習かファインチューニングが必要になる。検索と記憶の仕組みは、この静的な記憶を、外部からアクセスできる動的な構造によって補う、あるいは部分的に置き換えることを目指している。
かみくだいて言うと
通常、モデルが「知っている」ことはすべて固定された重みの中にあり、その知識を更新するには再学習が必要になる。検索ベースの記憶は、知識を重みから切り離す。研究者が何もかも暗記するのではなく参考文献を調べるように、モデルは実行時に情報を調べられるようになる。
検索ベースのアーキテクチャは、Transformerに検索可能な文書ストアへのアクセスを加える。モデルは内部の重みだけに頼るのではなく、推論処理の時点で関連するテキスト断片を検索する。取り出した断片はコンテキストウィンドウに組み込まれ、モデルは最新の情報やドメイン固有の情報を条件として予測を行えるようになる。この設計では、記憶はもはや学習時点で固定されたものではない。クエリに応じて変わり、外部で維持管理されるものになる。
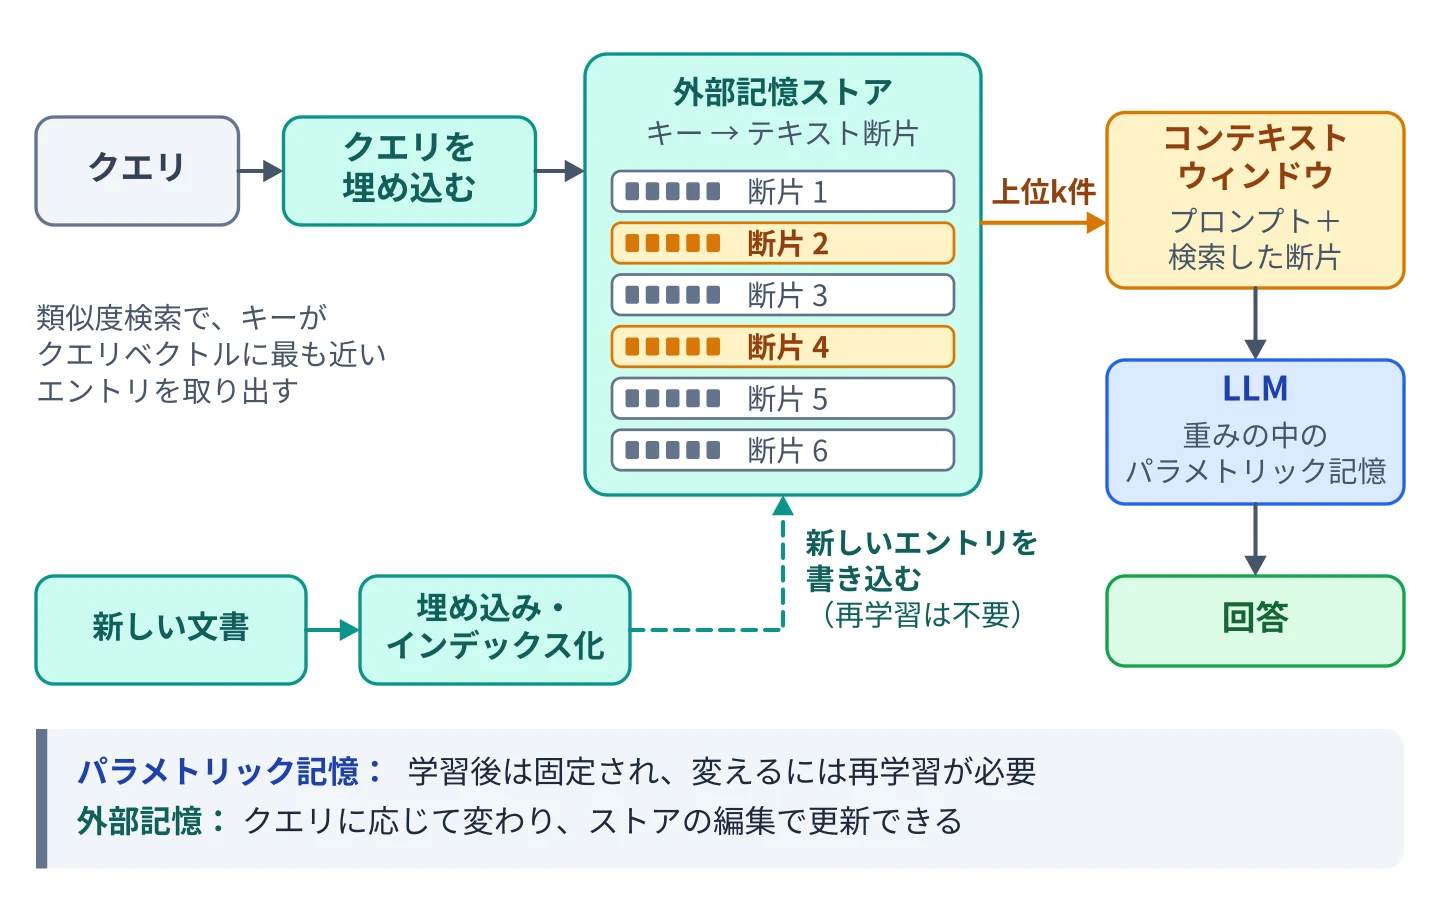
単純な検索拡張生成(RAG)のパイプラインにとどまらず、研究では記憶とモデルアーキテクチャをより密に統合する方法が探られている。微分可能な記憶モジュールでは、学習中に検索処理を通して勾配を流せる。こうしたシステムでは、モデルは応答の生成方法だけでなく、効果的な検索の方法も学習する。記憶のエントリはキーとバリューの組で構成されることがあり、キーは埋め込みベクトルを、バリューはそれに対応する情報を保持する。推論処理の際には、注意機構がトークン系列に対して働くのと同じように、この記憶空間に対して働く。
もう1つの研究の方向性は、長いコンテキストの記憶だ。従来のTransformerは、注意の計算量が系列長の2乗で増えるため、極めて長い系列を苦手としてきた。記憶拡張モデルは、セグメントをまたいで保持される再帰的な記憶トークンや圧縮表現を導入する。こうした研究は、より効率的な注意機構の実装や位置エンコーディングの技術と相まって、本番環境のコンテキストウィンドウを数十万トークン、一部のシステムでは100万トークン前後にまで押し広げた。ただし、ウィンドウが大きいことと、それを確実に使いこなせることは別の話だ。入力が長くなるほど、また関連する内容が無関係な情報の中に埋もれるほど、検索や推論のタスクでの精度は下がる傾向がある。そのため、技術的にはすべてが収まる場合でも、何をどの順番でコンテキストに入れるかを選ぶことは依然として重要だ。
動的な記憶の仕組みは、知識を継続的に更新するという課題にも応える。新しい事実を取り込むためにモデル全体を再学習する代わりに、外部の記憶ストアを更新すればよい。パラメトリックな知識と外部記憶をこのように分けることで、コストのかかる再学習サイクルの必要性が減る。
とはいえ、検索と記憶を統合すると新たな課題も生じる。記憶の選択は正確でなければならず、無関係なものを検索すれば性能が落ちる。推論処理のパイプラインに検索処理が加わるため、レイテンシも増える。外部記憶に信頼できない内容や敵対的な内容が含まれる場合には、セキュリティ上の考慮も必要になる。
概念的には、検索と記憶の仕組みは、言語モデルを静的な予測器からハイブリッドな推論システムへと変える。モデルは、知識を一枚岩のように抱え込む入れ物ではなく、構造化された記憶から情報にアクセスして統合する制御装置(コントローラー)になる。
検索がテキストの知識を動的に拡張する一方で、別の研究の最前線は、テキストの枠そのものを越えようとしている。
11.3 マルチモーダルモデル
言語は、情報を表現する経路の1つにすぎない。画像は空間的な構造を伝え、音声は時間的なパターンをとらえ、動画は動きと文脈を時間の流れの中で統合する。マルチモーダルモデルは、こうした信号を共有の表現の枠組みの中で統一的に扱い、大規模言語モデルの原理をテキストの外へと広げることを目指している。
かみくだいて言うと
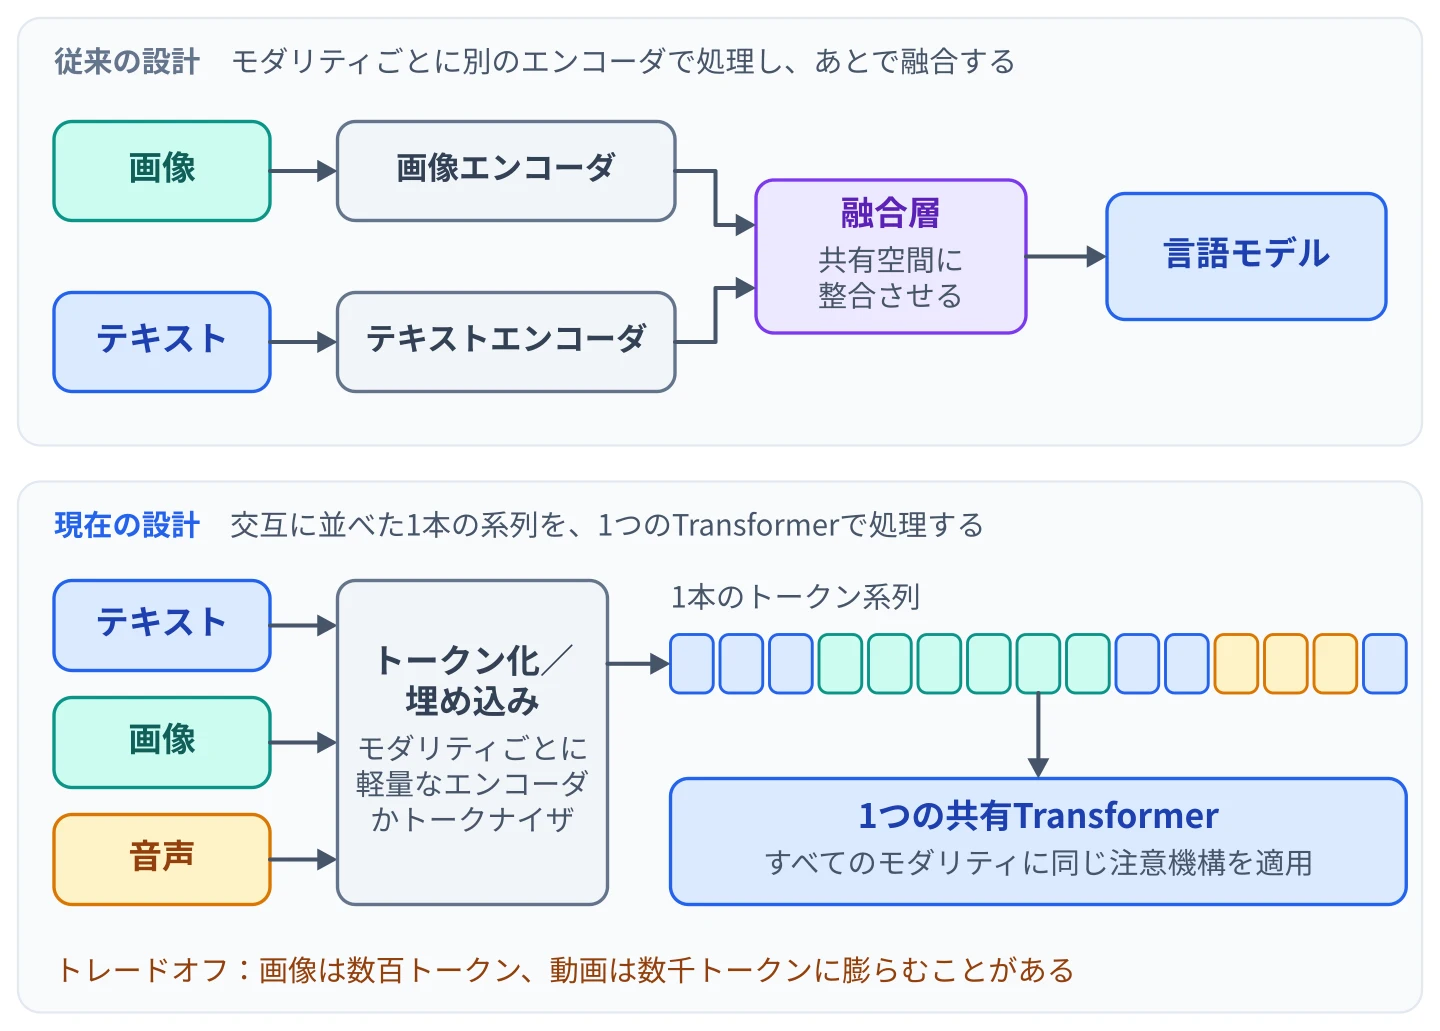
初期のマルチモーダルシステムは、言語、画像、音声をそれぞれ別の仕組みで処理し、その出力をつなぎ合わせていた。新しいシステムは、画像や音をトークンや埋め込みの系列に変換し、テキストと交互に並べて、1つの共有Transformerに通す。このアーキテクチャの変化は、現代のAIが1つの会話の中で音声、画像、テキストを滑らかに組み合わせられる理由の1つだ。
構造のレベルで見ると、マルチモーダルシステムにはモダリティごとのエンコーダが必要になる。画像エンコーダは画像のピクセルを埋め込みに変換する。多くの場合、画像をパッチに分割し、それらのパッチにTransformerを適用する。音声エンコーダは、波形やスペクトログラムを時間軸にそろった特徴ベクトルに変換する。こうして得た埋め込みは、共有のベクトル空間の中でテキストの表現と整合(アラインメント)させる必要がある。
中心となる課題は、このアラインメントだ。学習中は、画像とキャプションの組や音声と書き起こしの組といったペアのデータセットを使って、モデルがモダリティ間の対応関係を学ぶ。対照学習の目的関数は、関連する項目どうし(たとえば画像とそのキャプション)の埋め込みをベクトル空間内で近づけ、無関係な組は遠ざける。このアラインメントによって、画像からのテキスト生成、テキストによる画像検索、画像についての質問応答(VQA)、マルチモーダルな対話といった、モダリティをまたぐタスクが可能になる。
クロスアテンションの仕組みは、モダリティの統合をさらに進める。各モダリティを独立に処理してから出力を組み合わせるのではなく、クロスアテンションでは、あるモダリティのトークンが別のモダリティのトークンに直接注意を向けられる。たとえば画像について質問に答えるとき、テキストのクエリトークンが画像パッチの埋め込みに注意を向け、言語を知覚情報に結びつける(グラウンディングする)。
マルチモーダルなスケーリングには、新たな難しさが伴う。まず、データ不足が制約になる。テキストのデータは豊富にあるが、質の高いマルチモーダルのペアデータは収集コストが高い。また、学習がテキスト中心の目的に偏らないよう、モダリティ間のバランスを取るための慎重なサンプリングが必要になる。
推論処理の効率面でも要求は厳しくなる。エンコーダが複数あれば、メモリと計算の要件が増える。効率的な圧縮や、モダリティ間でのパラメータ共有は、活発な研究分野になっている。
概念的には、マルチモーダルモデルは、汎用的な知能には言語だけで十分だという前提に疑問を投げかける。知覚の信号を統合することで、モデルは物理世界に根ざしたコンテンツを解釈し生成するシステムへと近づいていく。
モデルが時間とともにどう適応するかに話を移す前に、マルチモーダル設計におけるもう1つの展開を見ておきたい。
さらに、アーキテクチャ上の変化にも触れておく価値がある。ここまで説明した方式、つまりモダリティごとに別々のエンコーダを用意し、その出力を共有空間で整合させる方式は、マルチモーダルシステムの初期の世代で主流だったパターンだ。より新しいシステムでは、画像、音声、動画を系列に変換する。この系列は、離散的なトークンの場合もあれば、軽量なエンコーダが生成する連続的な埋め込みの場合もある。そして、それをテキストトークンと交互に並べた1本の系列として、1つの共有Transformerで処理する。
この設計では、マルチモーダル性は融合層の性質ではなく、入力ストリームの性質になる。言語を扱うのと同じアーキテクチャの仕組みが、ほかのモダリティも扱う。その代わり、知覚信号のトークン化はコストが高い。画像は数百トークン、動画は数千トークンに膨らむことがある。そのため、コンテキストの予算管理、キャッシュ、ストリーミングが、テキストだけのシステムでは求められなかったほど重要なエンジニアリング上の検討事項になる。モデルが知覚できる範囲をどう広げているかを見たところで、次はモデルが時間とともにどう適応しうるかに目を向けよう。
11.4 継続学習と自己教師あり学習
ほとんどの大規模言語モデルは、2段階のライフサイクルをたどる。静的なデータセットでの大規模な事前学習と、それに続くファインチューニングおよびデプロイだ。いったんデプロイされると、モデルの中核的なパラメータはほぼ固定されたままになる。継続学習は、このパラダイムに異を唱える。ゼロから再学習したり以前の知識を忘れたりすることなく、モデルを時間とともに少しずつ更新できないか、という問いだ。
かみくだいて言うと
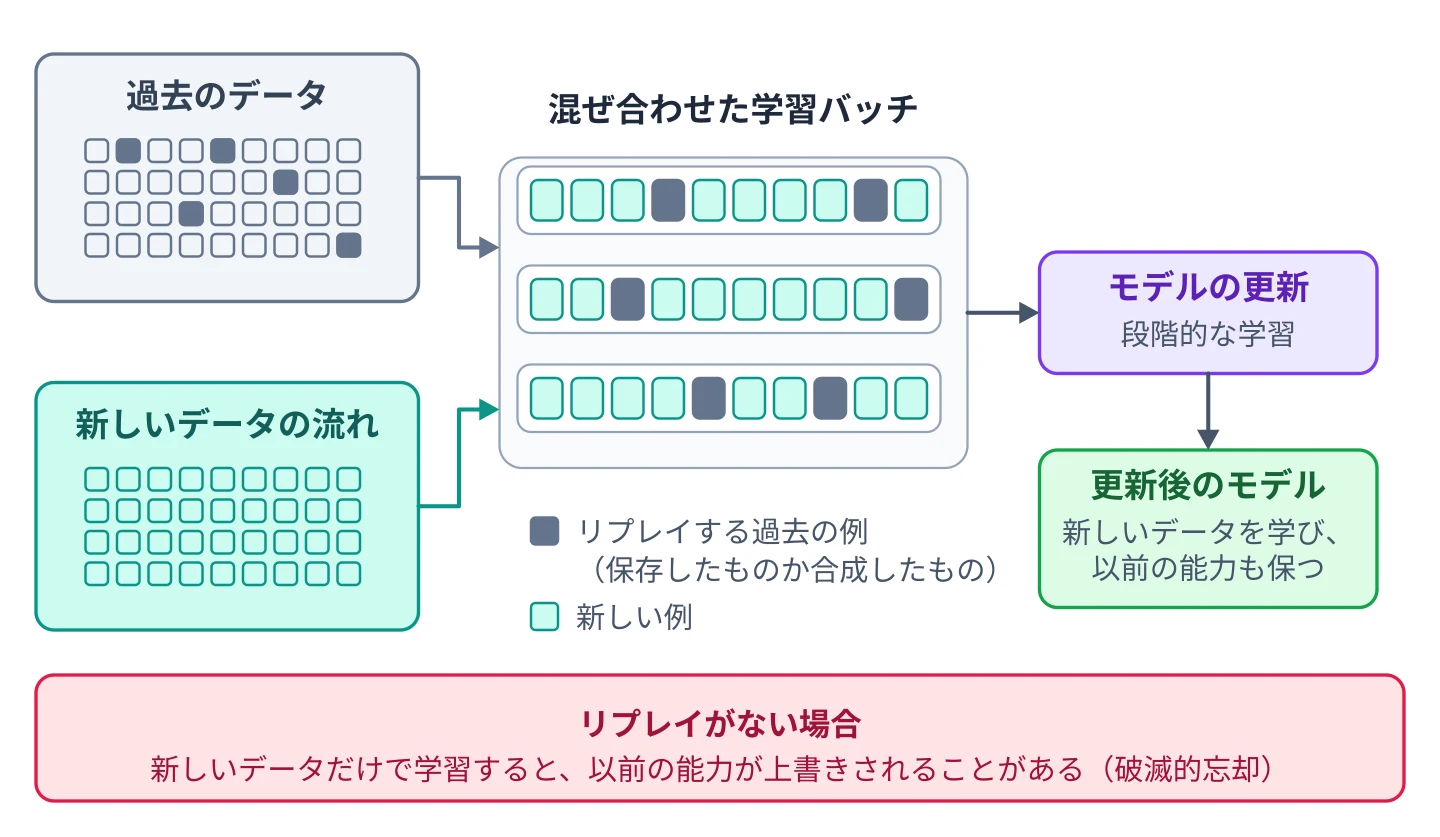
ほとんどのモデルは一度学習されたら凍結され、新しい知識を加えるには再学習のサイクルを丸ごと回す必要がある。継続学習は、デプロイ後もモデルが学び続け、しかもすでに知っていたことを忘れないようにしようとする試みだ。これを確実に行うのは意外なほど難しい。素朴なやり方では、新しいスキルが古いスキルを上書きしてしまいがちだ。
中心的な障害は、破滅的忘却(catastrophic forgetting)だ。ニューラルネットワークを新しいデータで順番に学習させていくと、以前に学んだ表現が上書きされることがある。パラメータは分散しており、タスク間で共有されているため、新しい情報を取り込もうと重みを更新すると、以前に学習したパターンでの性能が落ちうる。継続学習の研究は、この不安定さを抑える仕組みを開発している。
1つの戦略は、正則化に基づく手法だ。段階的な学習の際に、以前のタスクにとって重要なパラメータの配置から大きく外れると、モデルにペナルティが課される。どの重みが以前の性能にとって重要かを重要度の指標で推定し、更新を全体に一律ではなく選択的に制約する。
別のアプローチは、メモリリプレイだ。以前のデータのごく一部を保持しておき、学習中に新しいデータと交互に混ぜる。過去の例を繰り返し見直すことで、モデルは新しい情報を取り込みながら以前の能力を保てる。大規模なシステムでは、モデル自身に代表的なサンプルを生成させる合成リプレイによって、コーパス全体を保存しなくても過去のデータを近似できる場合がある。
モジュール型のアーキテクチャも、継続的な適応を後押しする。新しいエキスパートモジュールやアダプタ層を追加すれば、ベースモデル全体を変更せずにドメイン固有の知識を取り込める。更新が局所化されるので、既存の表現への干渉も減る。
自己教師あり学習は、ラベルのないデータから学べるようにすることで、継続学習を補完する。元の事前学習の目的、つまりマスクされたトークンや次のトークンを予測することは、今も強力な自己教師信号だ。最近の文書やユーザーとのやり取り(プライバシー上の制約の範囲内で)といった新しいデータの流れに継続的に触れることで、モデルは人手によるアノテーションなしに適応できる。
ただし、継続学習はガバナンスと安全性の懸念も生む。段階的な更新が、意図しない振る舞いやバイアスを持ち込むことがある。モデルが動的に変化するときは、常に厳密な評価と監視が欠かせない。バージョン管理とロールバックの仕組みも、責任あるデプロイの一部になる。
概念的には、継続学習は言語モデルを静的な成果物ではなく、進化していくシステムとしてとらえ直す。1回の事前学習で能力が恒久的に決まるのではなく、環境の変化に合わせてモデルが徐々に適応していく可能性がある。
継続学習は、モデルが知っていることを時間とともに変える。これとは別の研究の流れは、個々の質問にモデルがどれだけの労力をかけるかを変える。
11.5 推論時スケーリングと推論モデル
この10年、スケーリングをめぐる議論の中心は学習だった。パラメータ数、データセットの規模、学習の計算量をそろって増やすことでモデルの性能は向上し、研究はその学習予算を最も効果的に配分する方法を探ることに注力してきた。その後、これとは異なる種類のスケーリングが登場し、今ではそれを補完している。
かみくだいて言うと
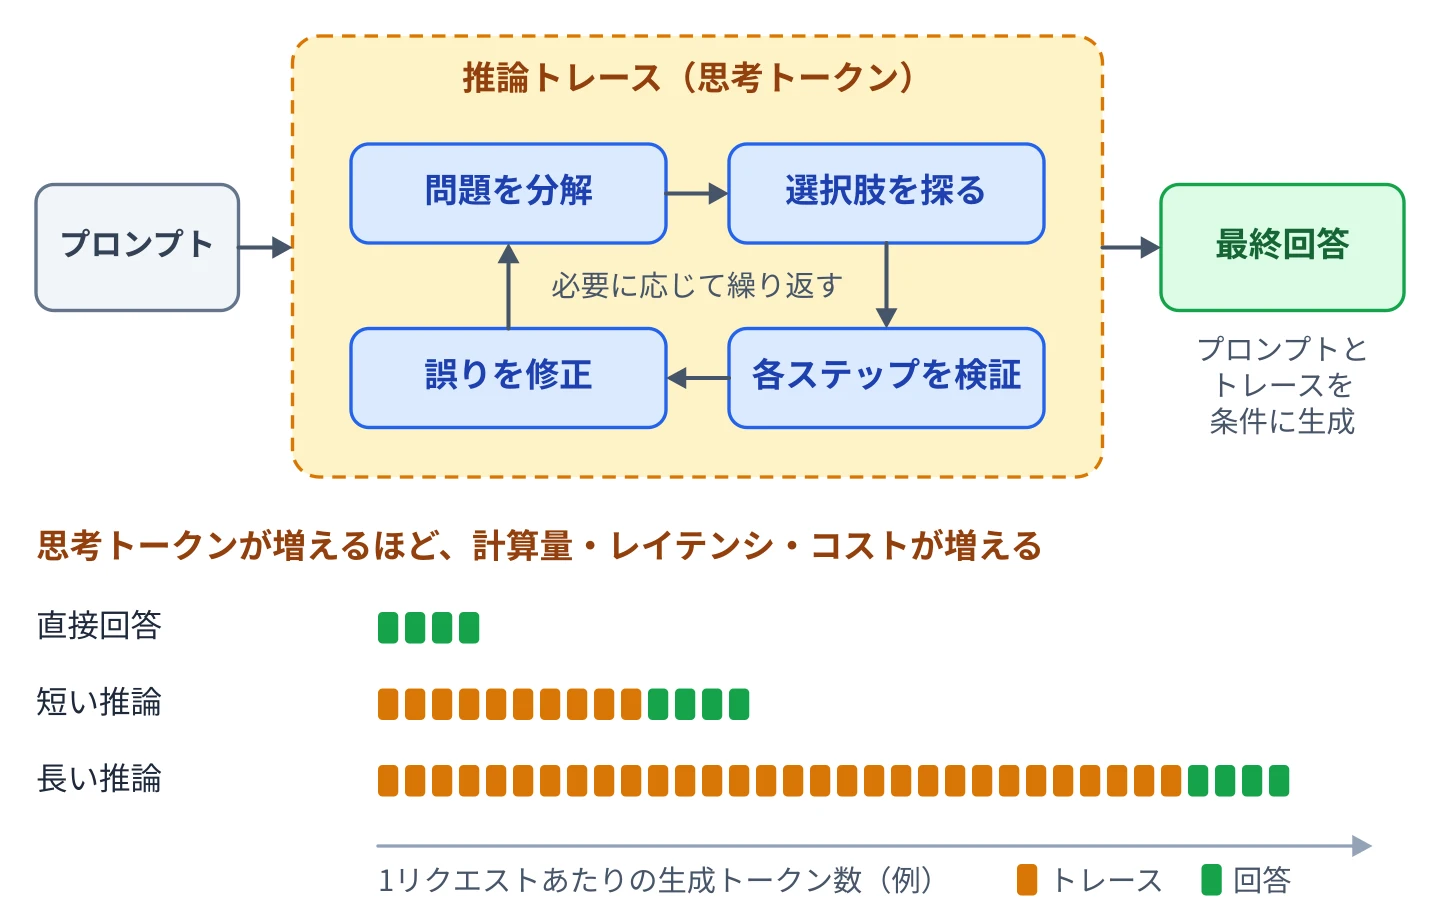
以前のモデルは、質問の難しさにかかわらず、1つの回答にほぼ同じくらいの時間をかけていた。推論モデルはこれを変える。難しい問題では立ち止まって長めに「考え」、ユーザーには見えない途中のステップを生成できる。この余分な思考時間にはコストがかかるが、数学やコードのように丁寧に筋道を立てる必要がある問題では、はるかに良い答えが得られる。
学習の終わりにモデルが知っている量をスケールさせるだけでなく、質問に答える時点でモデルに許す計算量をスケールさせる。これが推論時スケーリング(test-time compute のスケーリング)であり、それを最も徹底して取り入れたモデルは推論モデル(reasoning model)と呼ばれることがある。
仕組みの大筋は単純だ。推論モデルは、最終的な答えを出す前に、長い内部的な中間トークンの連鎖を生成するように学習される。学習には通常、解き方を示した例による教師あり学習、選好最適化、そして結果を検証できるタスクでの大規模な強化学習(検証可能な報酬による強化学習、RLVR と呼ばれることが多い)を組み合わせる。これらの中間トークンは、作業用の記憶(ワーキングメモリ)として働く。モデルはそれを使って問題を分解し、候補となるアプローチを探り、自分の計算や論理を確かめ、誤りに気づいたところを修正する。最終的な答えは、元のプロンプトだけでなく、この思考過程(推論トレース)全体を条件として生成される。
このパラダイムが通常の思考の連鎖(chain-of-thought)プロンプティングと違うのは、その能力がどこに宿っているかだ。思考の連鎖プロンプティングは、プロンプトを工夫することで、汎用モデルに推論を外に書き出させる。これに対して推論モデルは、推論するように学習されている。その振る舞いは方策(ポリシー)そのものに組み込まれており、適切な入力に対して自動的に現れる。
強化学習の訓練信号は、通常、正しさを機械的に確かめられる領域から得られる。数学、プログラミング、論理パズル、形式的に検証可能なタスクなどだ。その結果、多段階の推論問題でベースモデルよりも安定して高い正答率を示すモデルが生まれる。この段階で広く使われているアルゴリズムであるGRPO(group relative policy optimization)は、同じ問題に対して複数の答えをサンプリングし、それぞれを自動チェッカーで採点し、グループの平均を上回った答えを強化する。これにより、別途学習させる価値モデルが不要になる。公開されている研究結果では、推論のやり方を人間が書いた手本がなくても、この種の報酬だけで、長く自己修正を含む推論トレースが生じうることが示されている。
こうしたモデルをデプロイするエンジニアの立場から見ると、推論時スケーリングはシステムの運用上の性質を変える。レイテンシは、もはや固定的なフォワードパスのコストで決まるのではない。モデルがどれだけ推論するかによって決まり、その量は入力によって1桁も変わりうる。
リクエストあたりのコストも同様に変動する。多くのプロバイダはこれを明示的に扱い、1回のリクエストで生成される推論の量に上限を設ける設定や、推論の深さを段階別に選べる設定を提供している。1つのモデルが両方のモードで動作し、単純なリクエストにはそのまま答え、リクエストの内容や呼び出し側の指定に応じて長い推論に切り替えるケースも増えている。アプリケーション設計は、この変動に対応しなければならない。エージェントのループ、バッチパイプライン、ユーザー向けのやり取りのいずれにも、ストリーミング、キャンセル、タイムアウトの方針が必要になる。これらは、前の世代のモデルではほとんど求められなかったものだ。
トレードオフは運用面だけではない。推論モデルは、検証可能な部分ステップに分解できる問題では性能が上がりやすいが、流暢なパターン補完が重要なタスクでは同程度か、ときには劣ることもある。また、失敗の一部が、最終回答に紛れ込む気づきにくい誤りから、途中のトレースに現れる検出可能な誤りへと移る。これは評価とデバッグに影響する。ただし、この可視性には限界がある。トレースの要約しか見せない、あるいはまったく見せないサービスもある。さらに研究では、トレースが答えを実際に左右した要因を必ずしも忠実に報告しないことがわかっている。そのため、トレースは完全な説明ではなく、有用な手がかりとして扱うべきだ。
そこで、推論モデルを扱うエンジニアリングチームは、これまでとは違う習慣を身につける。一発の流暢さではなく多段階の正しさを確かめる評価セットを用意し、推論が異常に長いリクエストを検知する監視を行い、物語的な説明ではなく検証可能な中間成果物をモデルに出させるようなプロンプトの書き方を採る。
概念的には、推論時スケーリングは、能力をほぼ独立した2つの軸に沿って高められることを示唆している。学習の軸は、モデルがデータから何を学んだかを決める。推論の軸は、個々の入力に対してモデルがどれだけ熟考するかを決める。どちらの軸も他方を不要にはしない。両者は組み合わさる。
十分に推論することを許された小さなモデルが、問題の種類によっては、1回のパスで答える大きなモデルを上回ることがある。これは、モデル選択を左右してきたスケールとコストのトレードオフをとらえ直すものだ。推論に対応したバリアントが主要なモデルファミリーの標準的な選択肢になった今も、この見方はシステム設計に影響を与え続けている。
11.6 今後の方向性
この10年の大規模言語モデルの急速な進歩は、楽観と警戒の両方を呼び起こす。スケーリング則は、モデルの規模、データ、計算量を増やせば予測可能な性能向上が得られることを示している。疎なアーキテクチャは効率を高める。検索の仕組みは記憶を拡張する。マルチモーダルモデルは知覚の幅を広げる。継続学習は適応性をもたらす。それでも、根本的な問いはまだ解決されていない。
かみくだいて言うと
現在この分野で主に問われているのは、効率(より少ない計算でより多くをこなすこと)、推論(多段階の思考でモデルをより信頼できるものにすること)、アラインメント(能力が上がってもモデルが適切に振る舞い続けるようにすること)、そして全体のアーキテクチャ(Transformerが主流であり続けるのか、置き換えられるのか)だ。1つのブレイクスルーが全体を決めるとは考えにくく、進歩は多くの小さな統合の積み重ねから生まれる可能性が高い。
未解決の問いの1つは、スケーリングの限界だ。経験的な曲線はモデルの大型化に伴う着実な改善を示しているが、エネルギー消費、ハードウェアの入手性、学習コストといった物理的な制約が、実際上の上限を課している。モデルが極端なパラメータ数に近づくにつれて、収穫逓減がよりはっきり現れるかもしれない。研究の焦点は、単に規模を拡大することから、賢くスケールさせることへと移りつつある。つまり、ただサイズを大きくするのではなく、データの質、アーキテクチャの効率、アラインメントの手法を改善することだ。
もう1つの最前線は、推論と計画だ。11.5節で取り上げた推論向けに学習されたモデルは、数学やプログラミングでの多段階の性能を大きく向上させた。それでも、多くのステップにわたって計画を持続させる必要がある長期的なタスクや、正しさを自動的に確かめられない問題では、信頼性がまだ落ちる。ツールの統合、学習された検証器、記号処理とニューラルネットを組み合わせたハイブリッドシステムといったアプローチは、生成の柔軟性を損なわずに、熟考的な推論を強化することを狙っている。
アラインメント研究は、引き続き中心的な位置を占める。能力が高まるほど、システムを安全に、かつ人間の価値観と一貫した形で振る舞わせることは複雑になる。人間のフィードバックによる強化学習(RLHF)、直接選好最適化(DPO)、憲法に基づく学習(constitutional training)、自動化された監督といった手法は進化を続けている。また、モデルの内部特徴を調べる解釈可能性のツールは、アラインメントを研究するためだけでなく、監査するためにも使われ始めている。課題は、能力と制御可能性のバランスを取ることだ。
アーキテクチャの代替案が、この分野を塗り替える可能性もある。今日はTransformerが主流だが、研究者たちは、注意の2乗コストに対処するモデル、構造化された世界モデルを統合するモデル、記憶をより明示的な形で組み込むモデルを探っている。こうした研究の一部は、すでに公開モデルに届いている。ハイブリッドな設計では、注意層の大半を、系列長に対してコストが線形に増える状態空間モデルの層や線形注意の層に置き換え、正確な想起のために少数の完全な注意層を残す。これに混合エキスパートのルーティングを組み合わせたものもある。特定の領域では、ニューラルネットワークと記号推論や確率的グラフィカルモデルを組み合わせたハイブリッドアーキテクチャが登場するかもしれない。
システムのレベルでも、より大きな進化が起きている。LLMはますます大きなエコシステムの構成要素として動くようになっている。ツールを編成し、データベースにアクセスし、ユーザーとやり取りし、動的に適応する。この役割を中心に、標準的なインターフェースも形になり始めた。Model Context Protocol(MCP)のようなオープンなプロトコルを使えば、モデルは共通のインターフェースを通じて外部のツールやデータソースを見つけて呼び出せる。このプロトコルは2025年末に、Linux Foundationが運営するベンダー中立の財団の傘下に移された。「モデル」と「システム」の境界は、ますます曖昧になっている。
今後の進歩は、単発のブレイクスルーよりも、複数の技術を規律ある形で統合できるかどうかに左右されるだろう。効率、信頼性、解釈可能性、ガバナンスが、実社会での採用においてどのモデルが成功するかを決めていく。
ポイント:LLMの未来を決めるのはスケールだけではない。知的なアーキテクチャ設計、推論のより強固な統合、資源の効率的な利用、そして堅牢なアラインメントの仕組みが、その未来を形づくる。
研究の最前線を見てきたところで、ここからは理論と展望から実践へと移る。次章では、LLMベースのシステムを一から完全に構築する方法に焦点を当てる。
ポチっとでの実践
端末で動かすために何を測るか
車載端末やロボットで会話の続きを引き継ぐことを、将来の目標にしています。研究候補を選ぶ際は、オフラインで処理できる範囲、端末の資源、利用者が記憶を管理できることを、それぞれ確認できる問いに分けます。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る