 Pocchito
第12章 自分のLLMシステムを構築する
最後は、モデル選定からアプリに組み込むまでの手順です。最初に一つの役割を選ぶと、何を作り、何を測るかを具体化できます。
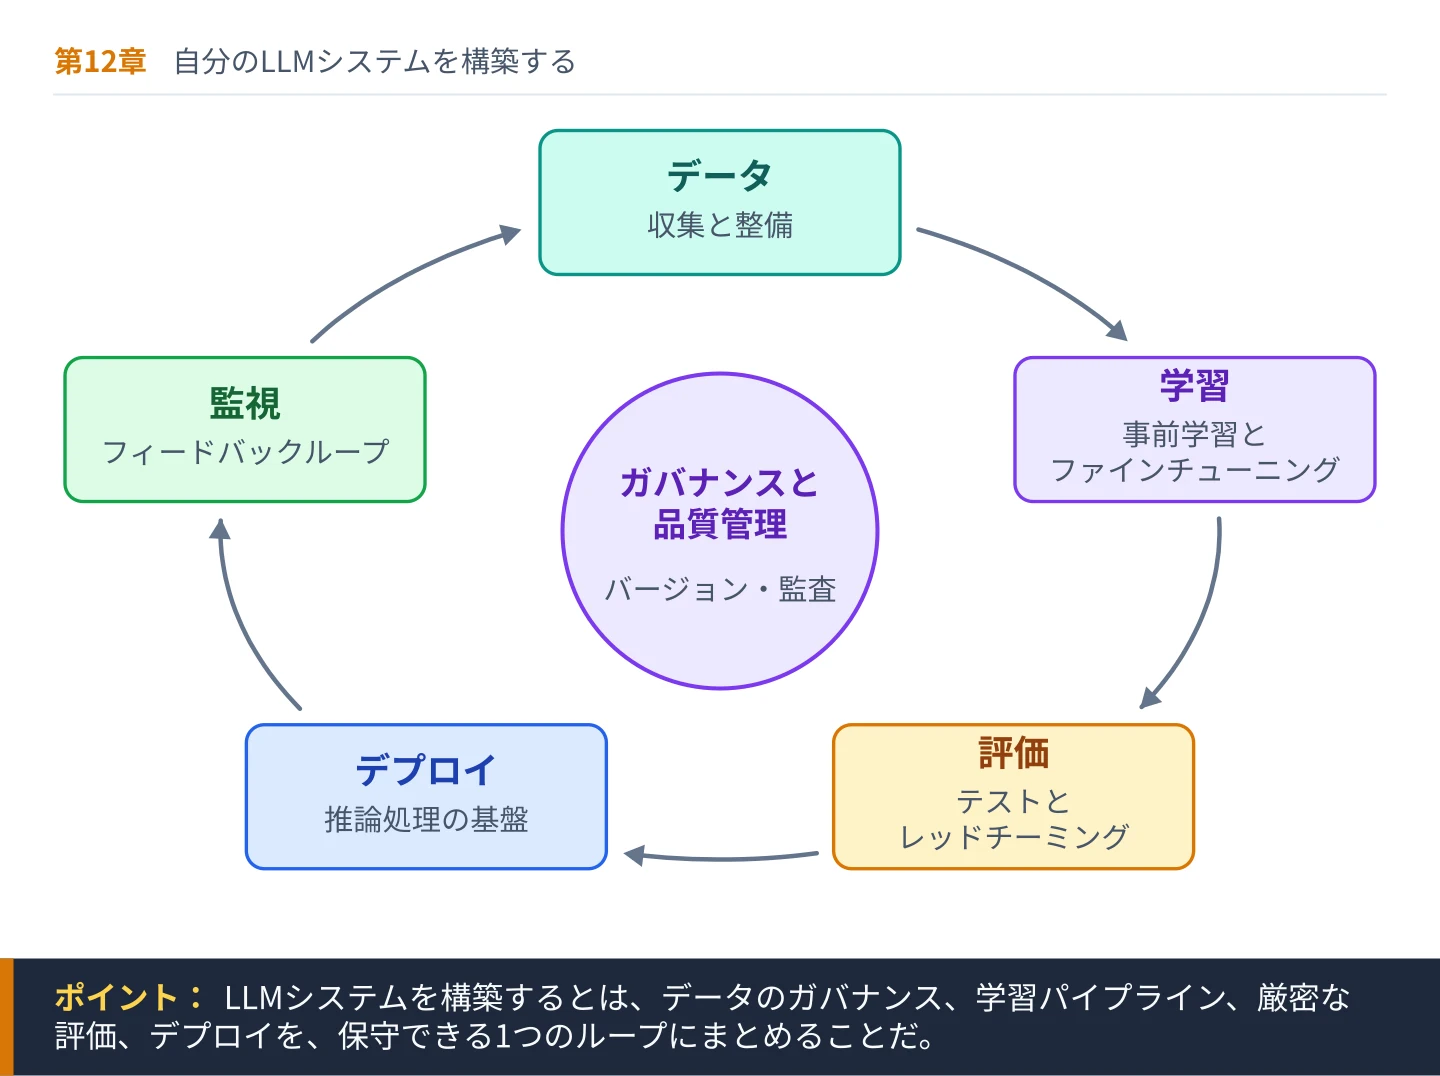
本書ではここまで、大規模言語モデルをさまざまな角度から見てきた。確率論的な基礎、ニューラルネットワークのアーキテクチャ、スケーリングの振る舞い、安全性への配慮、そして研究の最前線である。第12章では、これらの糸を「LLMを使った完全なシステムをどう構築するか」という実践的な目標へと束ねる。すべての読者が1兆パラメータ級のモデルをゼロから学習させることは想定していない。焦点はシステムレベルの構築、つまりデータセット、パイプライン、評価、アプリケーション基盤がどう組み合わさって、実際に動くプロダクトになるかにある。
LLMシステムの構築では、複数の層で判断が求められる。データは責任ある方法で収集し、整備しなければならない。学習パイプラインは再現性と規模を前提に設計する必要がある。評価の枠組みは、品質・安全性・信頼性を測れるものでなければならない。アプリケーションスタックでは、モデルをAPI、ストレージ、監視ツール、ユーザーインターフェースと統合する。目的は部品を寄せ集めることではなく、それらを一貫したアーキテクチャとしてかみ合わせることだ。
12.1節「データセットとライセンス」では、土台となるデータを扱う。データセットの調達方法、法令順守の確保、ライセンス上の制約の管理、高品質なコーパスの整備を検討する。モデルの振る舞いを最も大きく左右するのは、ほかのどの要因よりもデータ戦略である。
12.2節「学習パイプライン」では、データがどのようにモデルへ流れ込むかを見ていく。前処理、分散学習の基盤、チェックポイント、実験管理、再現性を取り上げる。パイプラインの構築には、アルゴリズムの理解と運用上の規律の両方が欠かせない。
12.3節「評価フレームワーク」では、体系的な測定を重視する。評価は単純な正解率にとどまらず、頑健性テスト、バイアスの検証、安全性の確認、性能ベンチマークまで含む必要がある。信頼できるシステムは、構造化された評価サイクルを重ねることで生まれる。
12.4節「統合アプリケーションスタック」では、モデルがソフトウェアシステムのほかの部分とどう連携するかを検討する。API、検索層、キャッシュ機構、ログ基盤、ユーザーインターフェースのいずれもが、システム全体の振る舞いに影響する。スケーラビリティと保守性を決めるのはデプロイのアーキテクチャである。
12.5節「ケーススタディとベストプラクティス」では、それまでの教訓を実践的な指針にまとめる。具体的な場面を分析し、分野を問わず通用する設計原則を引き出す。
まずは、あらゆるモデルの土台から始めよう。モデルが学ぶデータと、その利用を律する法的な枠組みである。
12.1 データセットとライセンス
どの大規模言語モデルも、データによって形づくられる。情報をどう処理するかはアーキテクチャが決めるが、何を学ぶかはデータが決める。自分のLLMシステムを構築するとき、データセットの設計とライセンス戦略は、モデルの能力、抱えるリスク、長期的な保守性を左右する根本的な判断になる。
かみくだいて言うと
学習データは、ただダウンロードすれば済むものではない。法的・倫理的な条件がついて回る。誰が権利を持っているのか、何に使ってよいのか、機微な情報が含まれていないか。どれも重要だ。データセットを正しく扱うことは、今や技術の問題であると同時に法務の問題でもある。
データセットづくりは調達から始まる。公開ウェブのコーパス、分野ごとに厳選した文書、ライセンス契約を結んだデータベース、社内で生成されたテキスト、そして近年増えている、他のモデルが生成した合成データなどが一般的な供給源だ。それぞれに利点と弱点がある。公開ウェブのデータは量が得られる反面、ノイズやバイアスが混じる。厳選したデータセットは品質を高めるが、多様性が失われることがある。分野特化のコーパスは専門用途での的確さを高めるが、汎化性能は下がる。合成データは不足を安く補えるものの、生成元モデルの誤りや盲点を受け継ぐため、人間が書いたテキストと同じくらい慎重にフィルタリングしなければならない。
品質管理は欠かせない。生のデータには重複、低品質な文章、書式の残骸、有害なコンテンツが含まれていることが多い。重複除去、言語フィルタリング、正規化、コンテンツモデレーションといった前処理によってノイズを減らす。データの分布も重要である。特定の分野が過剰に含まれていると、モデルの振る舞いが偏る。バランスを考えたサンプリング戦略が、こうした影響を和らげる。
ライセンスは、さらに別の複雑さを持ち込む。公開されているテキストだからといって、学習に再利用してよいとは限らない。ライセンスの条件はさまざまで、制限なく使えるもの、商用展開を制限するもの、クレジット表記を求めるものがある。独自のデータセットには明示的な契約が必要な場合もある。組織はデータの来歴を追跡し、適用される知的財産法を順守しなければならない。法的な状況は2025年以降、はっきりしてきた。米国では初期の判決が、適法に入手したテキストでの学習はフェアユースに当たり得るとする一方、海賊版のコピーからコーパスを作ることとは明確に区別した。そうした訴訟の一つは約15億ドルの和解で決着している。EUでは2025年8月2日以降、汎用モデルの提供者に著作権ポリシーの整備と、欧州委員会が示すテンプレートに沿った学習データの概要の公表が義務づけられた。いまや、データをどう入手したかは、データに何が含まれているかと同じくらい重要である。日本では、著作権法第30条の4により、情報解析のような著作物の表現を享受しない目的の利用は原則として権利者の許諾なく行えるが、享受目的が併存する場合や権利者の利益を不当に害する場合は対象外となる(文化庁「AIと著作権に関する考え方について」、2024年)。
こうした作業を支えるのがデータガバナンスの枠組みだ。データセットの出所、ライセンス条件、前処理の手順を記録しておけば、透明性が生まれ、法的リスクも下がる。明確な記録は再現性の確保や監査にも役立つ。規制上・法律上の問題が起きたとき、追跡可能性はなくてはならないものになる。
プライバシーへの配慮も、データセットの設計を制約する。大規模なコーパスには個人データが含まれていることがある。法域によっては、データ保護法などの規制が、同意、匿名化、削除権への対応を求める。責任あるシステム構築者は、自らのデータ収集・保存の方法がこれらの基準に適合しているかを評価しなければならない。日本では個人情報保護法がこの役割を担う。
ドメイン適応の戦略も、データセットの選び方に影響する。対象とする用途が法律文書の分析、医療文書の要約、財務報告であれば、専門分野のコーパスが決定的に重要になる。ただし、機微な分野のデータを取り込むには、アクセス制御や暗号化といった追加の安全策が必要になることがある。
結局のところ、データセット戦略とは、規模、品質、適法性、分野との関連性のバランスを取ることだ。データパイプラインは後回しにせず、第一級のエンジニアリング要素として扱うべきである。
データの供給源を確保し整備したら、次はそのデータをどう学習済みモデルに変えるかに目を向ける。
12.2 学習パイプライン
データセットを整備し、法的な確認も済んだら、次の課題は、構造化された学習パイプラインを通じて生のテキストを学習済みモデルに変えることだ。学習パイプラインは一本のスクリプトではない。前処理、トークン化、バッチ化、分散最適化、チェックポイント、実験管理を扱う、連携したシステムである。その設計が再現性、スケーラビリティ、信頼性を決める。
かみくだいて言うと
学習パイプラインとは、生のテキストを使えるモデルに変えるベルトコンベア全体のことだ。収集、クリーニング、トークン化、学習の実行そのもの、評価、デプロイと続く。各段階にはそれぞれのツールと、それぞれの失敗のしかたがある。実際のところ、多くのチームはモデル設計よりもはるかに多くの時間をパイプラインに費やしている。
パイプラインは前処理から始まる。生のテキストはクリーニング、正規化、分割が必要だ。トークン化では、テキストをモデルの語彙に対応する離散的な単位に変換する。学習時と推論時のトークン化を一致させることは不可欠で、ずれがあると気づきにくい形で性能が落ちる。大規模になると、データ変換を再現できるよう、前処理を並列化し、バージョン管理しなければならない。
次はバッチ化とデータ読み込みである。効率的なパイプラインは、ボトルネックを生まずにストレージから計算ノードへデータを流し込む。大規模なコーパスでは、シャーディングと分散データローダーによって、特定のノードが制約になるのを防ぐ。メモリ使用量とハードウェアの稼働率を両立させるには、バッチ化の戦略を慎重に考える必要がある。
学習そのものには分散最適化が必要だ。大規模なモデルが1台のデバイスに収まることはまずない。データ並列、モデル並列、パイプライン並列といった手法で、計算を複数のアクセラレータに分割する。データ並列では、モデルの重みを各デバイスに複製し、入力バッチを振り分ける。数値精度も重要な調整手段である。BF16のような低精度形式で学習し、さらに計算の多くの部分でFP8を使うことが増えている。これによりメモリと通信のコストが下がるが、数値的に敏感な演算は高い精度で行う必要がある。モデル並列では、層やパラメータのテンソルをデバイス間で分割する。パイプライン並列では、計算を段階に分けてハードウェアに順に割り当てる。実際の大規模な学習では、これらをシャーディングデータ並列(ZeROやPyTorchのFully Sharded Data Parallelなど)と組み合わせる。シャーディングデータ並列は、重み、勾配、オプティマイザの状態をデータ並列のワーカー間で分割し、どのデバイスも完全なコピーを持たないようにする方式だ。混合エキスパート(MoE)モデルでは、さらにエキスパート並列を組み合わせ、エキスパートごとに異なるデバイスに配置する。どの手法にも、通信のオーバーヘッドや同期の複雑さというトレードオフがある。
チェックポイントは障害への耐性を確保する。モデルの状態を定期的に保存しておけば、ハードウェア障害から復旧でき、ファインチューニングやハイパーパラメータ調整の実験もしやすくなる。大規模なモデルではチェックポイントのファイルがテラバイト級に達するため、ストレージ管理は決して軽くないエンジニアリング課題になる。
実験管理も同じくらい重要だ。学習率のスケジュール、バッチサイズ、重み減衰、オプティマイザの設定といったハイパーパラメータは、体系的に記録しなければならない。構造化された記録がなければ、結果の再現は難しくなり、反復的な改善も遅くなる。
学習中の監視は、不安定化を早期に発見する手段になる。損失曲線、勾配ノルム、検証用の指標を追跡すれば、発散や過学習に気づける。学習が想定から外れたときに自動でアラートを出す仕組みも有効だ。
再現性は中心的な目標である。乱数シードの固定、バージョン管理されたコード、文書化されたデータパイプラインによって、実験を再現・監査できるようになる。複数人で開発する環境では、パイプラインが明快であるほど曖昧さが減り、改善のサイクルも速くなる。
事前学習は、現代のパイプラインの最初の段階にすぎない。通常はその後に事後学習が続く。まず厳選した指示と応答のペアで教師ありファインチューニングを行い、次に選好最適化を行う。選好最適化には、学習した報酬モデルと強化学習を使う方法(RLHF)と、別途の報酬モデルを使わずに選好ペアで直接最適化するDirect Preference Optimization(DPO)のような直接的な手法がある。2024年以降は、検証可能な報酬による強化学習(RLVR)が、特に推論モデルにとって重要な追加段階になった。数学の答えやテストを通過するコードのように、答えを自動で確かめられる場合にモデルに報酬を与える。その際、同じプロンプトに対する複数のサンプル回答を比較することで、価値モデルを別に学習させずに済むGroup Relative Policy Optimization(GRPO)のようなグループベースのアルゴリズムがよく使われる。各段階にはそれぞれ専用のデータ、チェックポイント、評価が必要になる。したがって、ここまで述べたパイプラインの規律は、事前学習と同じく事後学習にも当てはまる。
学習によってモデルはできあがるが、学習だけで品質や信頼性が保証されるわけではない。さまざまなタスクや分野で性能を確かめるには、体系的な測定が必要になる。
12.3 評価フレームワーク
モデルを学習させると、損失関数に対して最適化されたパラメータが得られる。しかし損失だけでは、現実の場面での性能はとらえきれない。評価フレームワークは、抽象的な最適化の目標を、能力、頑健性、安全性の実践的な尺度へと置き換えるものだ。体系的な評価がなければ、デプロイは当て推量になってしまう。
かみくだいて言うと
評価フレームワークとは、モデルの出来ばえを、多くのタスクと多くの観点(正確さ、安全性、バイアス、コストなど)から体系的に測る方法である。「うまく動いているように見える」と「うまく動いている証拠がある」の違いを生むのがこれだ。本番環境では、評価が本当の意味で終わることはない。
評価は、タスクごとのベンチマークを定めることから始まる。言語モデリングでは、パープレキシティが、学習に使っていないテキストに対する予測の効率を測る。分類や情報抽出のタスクでは、適合率、再現率、F1スコアが定量的な手がかりになる。要約や翻訳では、参照訳に基づく指標がある程度の目安になる。ただし生成系のシステムでは、単一の指標を超えた多面的な評価が必要になることが多い。
頑健性テストでは、分布の変化や敵対的なプロンプトのもとでの振る舞いを調べる。境界的なケース、曖昧な入力、分野特有のストレステストによって、集計された指標では見えない弱点が明らかになる。構造化されたテストスイートがあれば、モデルやパイプラインを変更するたびに回帰テストを体系的に実行できる。
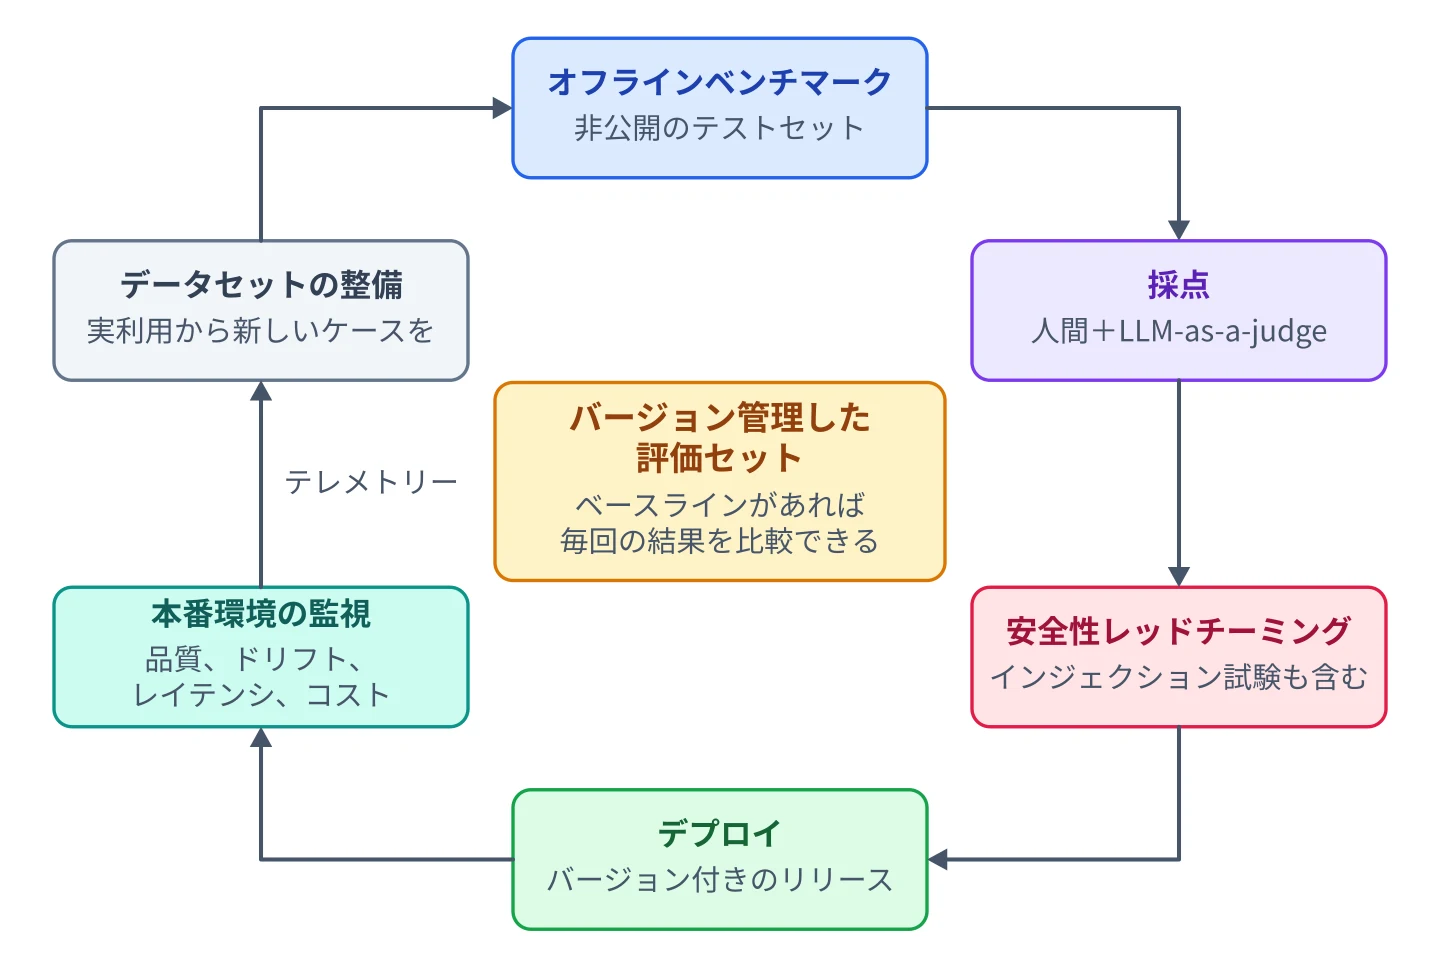
微妙な判断を要するタスクでは、人間による評価が今も欠かせない。評価者は一貫性、有用性、バイアス、語調、事実の裏づけを確認する。構造化された評価基準(ルーブリック)を使えば、主観が減り、評価のばらつきも抑えられる。人間によるレビューは時間もコストもかかるため、多くのチームでは強力なモデルを自動採点者として使うことも増えている。LLM-as-a-judgeと呼ばれる手法だ。規模を広げやすい反面、採点するモデルには、先に提示された回答を好む、長い回答を好む、自分と同じ系統のモデルの出力を好むといった既知の偏りがある。そのため、スコアは人間の判断のサンプルと照らし合わせて較正すべきである。医療や法律のように影響の大きい分野では、デプロイ前に専門家による評価が求められることもある。
安全性の評価は、独立した一つの層をなす。拒否ポリシー、バイアスへの敏感さ、誤情報への耐性を試すように設計したプロンプト集で、ガードレールが機能しているかを確かめる。レッドチーミングでは、敵対的な振る舞いを模擬して脆弱性を洗い出す。文書を検索したりツールを呼び出したりするシステムでは、プロンプトインジェクションのテストも安全性評価に含めなければならない。悪意ある指示がユーザーによって入力されるのではなく、ウェブページ、ファイル、ツールの出力に隠されているケースである。
評価フレームワークには、性能監視の指標も組み込まれる。レイテンシ、トークン使用量、リクエストあたりのコストは運用上のシグナルになる。品質と効率はあわせて評価しなければならない。性能が高くてもコストの制約を超えるモデルは、実用に耐えないことがある。
本番環境での継続的な評価が、このループを閉じる。実際の利用パターンを記録し、ユーザーのフィードバックを集めることで、静的なベンチマークでは予測できない振る舞いが見えてくる。評価は、デプロイ前のチェックリストではなく、継続的なプロセスになる。
再現性とバージョン管理は極めて重要だ。モデルの世代間で結果を比較できるよう、評価用のデータセットとスクリプトはバージョン管理しなければならない。公開ベンチマークには特に注意が要る。問題がウェブ規模の学習データに漏れ込み、汚染(contamination)によってスコアが水増しされている可能性がある。また人気のあるベンチマークの多くは飽和しており、上位のモデルは満点近くを出している。したがって、実際のアプリケーションから作った非公開のテストセットが、最も信頼できるシグナルになる。明確なベースラインがあれば、新しいアーキテクチャや学習戦略を試したときに意味のある比較ができる。
評価に合格したモデルは、次に、データの流れ、ユーザーとのやり取り、運用監視を担うより大きなシステムに組み込まなければならない。
12.4 統合アプリケーションスタック
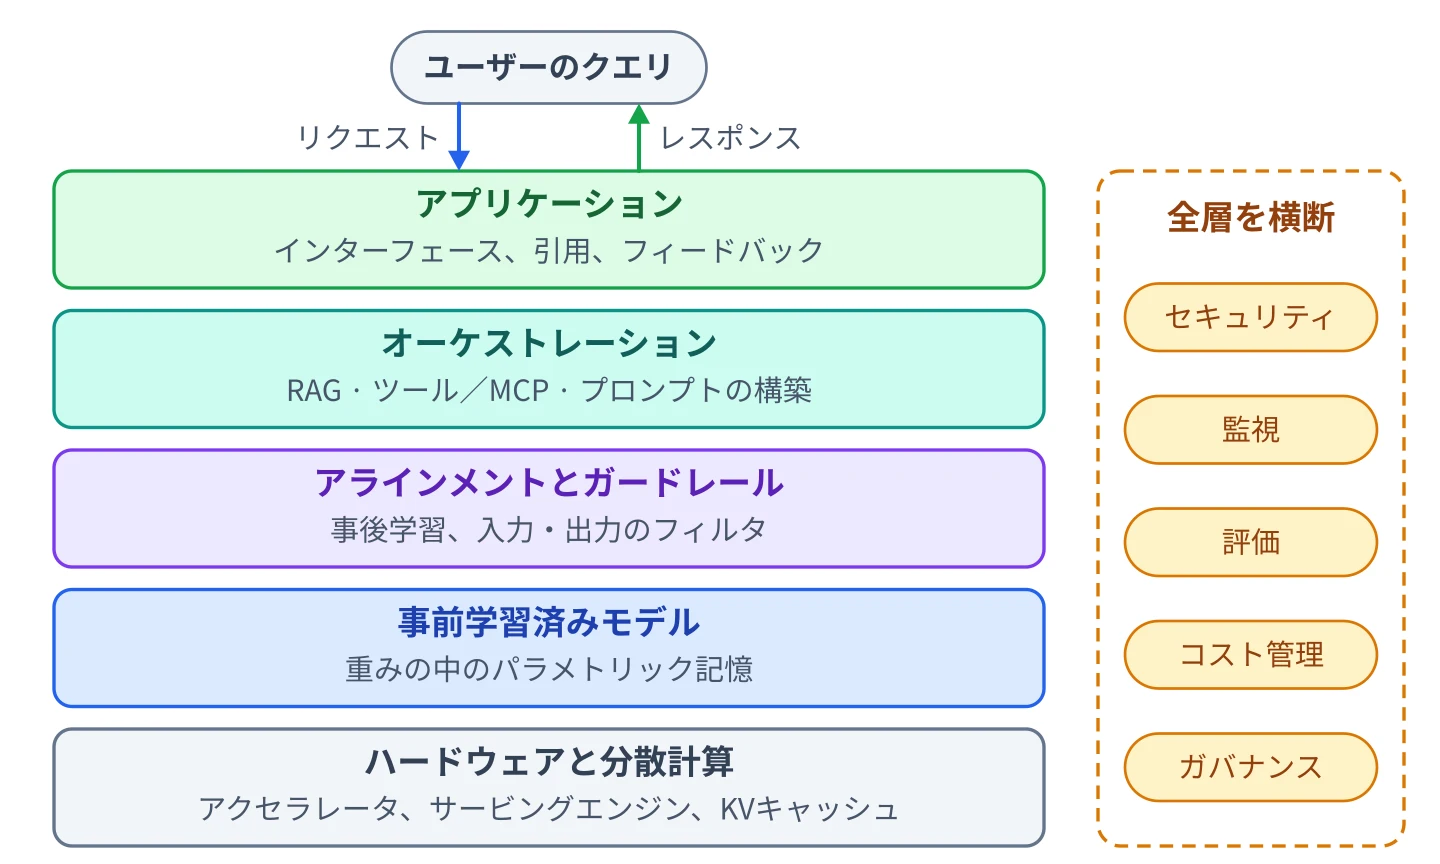
学習と評価を終えたモデルだけでは、完全なシステムにはならない。現実のアプリケーションには、モデルによる推論処理、検索、ストレージ、セキュリティ、監視、ユーザーとのやり取りを統合的に調整するスタックが必要だ。LLMを使ったプロダクトの出来は、モデルそのものよりも、それを取り巻くアーキテクチャに左右されることが多い。
かみくだいて言うと
LLMアプリケーションは、たいてい部品を積み重ねたスタックになっている。モデル本体、検索システム、過去のやり取りを保存するデータベース、モデルが呼び出せるツール、安全性の層、そしてユーザーインターフェースである。スタックという単位で考えることで、気の利いたモデルのデモが、実際のユーザーが信頼できるプロダクトに変わる。
スタックの中心には推論処理の層がある。この層はAPIを通じてモデルを公開し、リクエストの振り分け、バッチ処理、レート制限を担う。対話的なアプリケーション向けに、応答のストリーミングに対応することもある。現代のサービングエンジンは、コストとレイテンシをほぼ決定づける少数の技術に支えられている。処理済みのトークンの注意機構の状態を保存するKVキャッシュ、生成の各ステップで実行中のバッチにリクエストを出し入れする連続バッチ処理、KVキャッシュをページ単位でメモリ管理するPagedAttention、長いシステムプロンプトのような共通のプロンプト接頭部の計算を再利用するプレフィックスキャッシュ、そして安価な下書き役が複数のトークンを提案し、本体のモデルが1回のパスで検証する投機的デコーディングである。推論サービスはスケーラブルで、障害に強く、観測可能でなければならない。リクエストのメタデータ、レイテンシ、トークン使用量を記録することで、システムの健全性が見えるようになる。
推論処理の層の上には、多くの場合オーケストレーション層が置かれる。この層は、プロンプトの組み立て、検索処理、ツールの呼び出し、応答の検証を管理する。検索拡張生成(RAG)のシステムでは、オーケストレーション層がベクトルデータベースに問い合わせ、結果を順位づけし、文脈を含むプロンプトを整形する。ツールを使えるシステムでは、モデルの出力を構造化された関数呼び出しとして解釈し、安全に実行する。ツールとの接続は、Model Context Protocol(MCP)のようなオープンなプロトコルによって標準化が進んでいる。MCPは現在Linux Foundationのもとで管理されており、準拠したアプリケーションであれば、別のサーバーが公開するツールやデータソースを発見して呼び出せる。エージェント型のシステムでは、オーケストレーション層がこのサイクルを繰り返し実行し、モデルが計画を立て、ツールを呼び、結果を観察し、タスクが完了するまで続ける。そのため、ステップ数の上限、権限のチェック、影響の大きい操作に対する人間の承認が、アーキテクチャの一部になる。
データストレージの部品は、検索と監視の両方を支える。ベクトルデータベースは、意味検索のために埋め込みをインデックス化する。従来型のデータベースは、構造化された出力、ユーザーのセッション、設定のメタデータを保存する。キャッシュ層は、頻出するクエリの結果や埋め込みを保存して、重複する計算を減らす。
セキュリティとアクセス制御の仕組みは、機微な機能に許可されたユーザーだけがアクセスできるようにする。認証、認可、暗号化、監査ログは、スタックに欠かせない要素である。LLMシステムには特有の脅威もある。プロンプトインジェクションだ。OWASP Top 10 for LLM Applicationsで最大のリスクに位置づけられており、ユーザーの入力や検索で取得したコンテンツに埋め込まれた指示がモデルの挙動を乗っ取る。これを確実に取り除けるフィルターは存在しないため、堅牢な設計では被害を限定する方向をとる。タスクに必要な権限だけをモデルに与え、モデルの出力を後段のシステムにとって信頼できない入力として扱い、機微な操作の前には確認を求める。規制の厳しい環境では、コンプライアンス要件がアーキテクチャの判断に影響する。たとえばEU AI Actでは、汎用モデルに対する義務が2025年8月から適用されている。一方、採用や信用スコアリングのような高リスク用途に対する要件は2026年に延期が決まり、2027年12月から適用される。それまでの間は、NIST AI Risk Management FrameworkやマネジメントシステムのISO/IEC 42001規格といった枠組みが、ガバナンスの構造を与えてくれる。日本では、2025年に成立し同年9月に全面施行されたAI推進法(人工知能関連技術の研究開発及び活用の推進に関する法律)が、罰則を伴う規制ではなく推進と基本計画の策定を軸とし、実務上の指針としては総務省・経済産業省の「AI事業者ガイドライン」が開発者・提供者・利用者それぞれの取り組みを示している。
監視と可観測性がループを閉じる。メトリクスのダッシュボードで、レイテンシ、スループット、コスト、エラー率を追跡する。品質監視のパイプラインは、出力をサンプリングして人間のレビューに回す。レイテンシの急増や予期しない出力パターンといった異常があれば、アラートでチームに知らせる。継続的なフィードバックが反復的な改善を可能にする。
ユーザーインターフェースの設計は、システムとエンドユーザーをつなぐ。わかりやすい操作パターン、フィードバックの仕組み、透明性を示す表示が、使いやすさと信頼を高める。インターフェースには、モデルが生成した引用元、確信度、構造化された要約を表示することもある。
統合スタックは、モデルをサービスに変える。部品同士を連携させ、生成が根拠に基づき、検証され、安全で、スケーラブルであるようにする。アーキテクチャの規律があれば、一つの部品を改良しても、システム全体が不安定になることはない。
さらに深く:このスタックを信頼できるサービスに仕立てること、すなわちAPI設計、評価、可観測性、ガードレール、サービング、コスト管理は、LLM Primer V — Building Real-World LLM Applications(英語版)のテーマである。その付録には、本番運用への準備チェックリストや、レート制限とコスト管理のアーキテクチャが収録されている。
抽象的な原則は、実践的な場面に当てはめるとよりはっきりする。
12.5 ケーススタディとベストプラクティス
原則は、具体的な場面で試されてはじめて揺るぎないものになる。ケーススタディからは、アーキテクチャの判断、評価の戦略、ガバナンスの枠組みが、現実の制約のもとでどう影響し合うかが見えてくる。本節では個別の成功談を並べるのではなく、分野を超えて繰り返し現れるパターンを抽出する。
かみくだいて言うと
現実の導入事例は、規模も狙いも大きく異なる。それでも共通するパターンがある。小さく始める、注意深く測る、モデルを大きくする前に検索を加える、ユーザーが実際に何をしているかを監視する、規模を広げる前に評価に投資する。残りは分野ごとのエンジニアリングである。
企業向けの、特定分野に特化したナレッジアシスタントを考えてみよう。その組織には、規程、マニュアル、報告書、サポートチケットなど、何千もの社内文書がある。素朴な導入では、汎用のLLMに対話型のインターフェースをつけて公開するだけかもしれない。しかし実際には、そうしたシステムはハルシネーションを起こし、社内固有の用語を誤解し、答えも一貫しないだろう。
堅牢な設計では、検索拡張生成に、厳格なアクセス制御、文書のチャンク分割戦略、引用の強制、監視ダッシュボードを組み合わせる。評価には、分野に特化したベンチマークと人間によるレビューのサイクルを含める。教訓は明らかだ。根拠づけとガバナンスは、信頼の前提条件である。
別の例として、開発ワークフローに組み込まれたコード生成アシスタントを考える。このアシスタントは、有用性と正確さのバランスを取らなければならない。開発者はすばやい提案を期待するが、構文上・論理上の誤りが大量に出るのは許容できない。効果的なシステムは、プロジェクトの内容を踏まえた検索、静的解析によるチェック、反復的な改善ループを取り入れている。こうしたアシスタントは、複数のファイルを編集し、プロジェクトのテストスイートを実行し、テストが失敗すれば変更を修正するエージェントとして動くことが増えている。そのため、サンドボックス内での実行と、最終的な変更に対する人間のレビューが不可欠になる。テレメトリーからよくある失敗のパターンがわかり、それがプロンプトの調整やモデルの更新の指針になる。鍵となる原則はフィードバックの統合だ。開発者とのやり取りを構造化して記録するシステムでこそ、モデルは改善していく。
三つ目の例は、コンプライアンス報告のための大規模な文書処理である。ここでは知識抽出のパイプラインが非構造化テキストを構造化データに変換し、後段の分析に供給する。決定的なプロンプト、スキーマによる検証、低い温度でのデコーディングによって、出力のばらつきを減らす。構造化出力モードは、与えられたJSONスキーマに合致するテキストしか出力できないようデコーディングを制約するもので、不正な形式のレコードを大幅に減らせる。ただし保証されるのは形式であって、内容の正しさではない。適合率と再現率は継続的に追跡する。誤り率が上がれば、再学習やプロンプトの見直しを行う。この例は、決定的な設定と測定可能な目標の重要性を示している。
これらの例から、いくつかのベストプラクティスが浮かび上がる。第一に、モデルの選択をタスクの複雑さに合わせること。大きなモデルが常に必要なわけではない。第二に、最初から可観測性を考えて設計すること。監視の仕組みを後から組み込むのは難しい。第三に、関心を分離すること。推論処理、オーケストレーション、検証の各層はモジュールとして独立させておく。第四に、データガバナンスとライセンスを第一級の責任として扱うこと。第五に、反復を組織の仕組みとして根づかせること。成功する導入は、一度きりの設定ではなく、構造化されたフィードバックを通じて進化していく。
おそらく最も重要な教訓は、システムとして考えることだ。LLMは、技術と社会が絡み合うシステムの一部品である。能力、コスト、安全性、ユーザー体験、ガバナンスは、絶えず影響し合っている。持続可能なシステムは、技術的な卓越性と組織としての規律が互いを支え合うときに生まれる。
ポイント:現実の場でLLMを成功させる鍵は、技術と組織の両方の層にわたる、モジュール化されたアーキテクチャ、根拠に基づく検索、厳密な評価、可観測性、そして規律ある反復にある。
本章をもって、自分のLLMシステムを構築するという観点からの考察を締めくくる。今後の学習と参照に役立つよう、付録Aでは本書で使った主要な用語を簡潔に定義する。
ポチっとでの実践
小型モデルの開発をどこから始めるか
最初の候補は「何を頼まれたか」を判断する小型モデルです。基準測定、例示や文脈の比較、追加学習、アプリ全体の検証を段階に分けます。その積み重ねが、日常の頼みごとを安心して任せられる体験につながります。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る