 Pocchito
第3章 言語のためのニューラルネットワーク
モデルは文字の列を、計算できる数値の列として扱います。ここからは、入力をどう変換し、予測に使える表現を作るかを考えます。
第2章では、言語モデリングをトークン列に対する確率的な予測タスクとして定式化し、エントロピー、パープレキシティ、評価指標を導入した。しかし、確率の枠組みだけでモデルができるわけではない。膨大なデータセットから複雑なパターンを学び、高次元の条件付き分布を近似できる仕組みがまだ必要だ。第3章では、その仕組みであるニューラルネットワークを取り上げる。
本章では、ニューラルネットワークが言語をどう表現し、系列をどう処理するのか、そしてアーキテクチャの設計が単純なフィードフォワード型のモデルからTransformerへとどう進化してきたのかを説明する。第2章が「次のトークンを予測する」という目的を定めたとすれば、第3章は、その目的を大規模に達成可能にする計算のエンジンを説明する章だ。
3.1「ニューラルネットワークの基本概念」では、構成要素を紹介する。埋め込み、線形変換、非線形の活性化関数、隠れ層、損失関数、勾配降下法である。パラメータが誤差逆伝播法によってどう更新されるのか、そして言語のモデル化になぜ非線形性が欠かせないのかを確認する。
3.2「フィードフォワード、再帰、自己注意」では、系列をモデル化するためのアーキテクチャ上のアプローチを比較する。フィードフォワードネットワークは固定長の文脈を処理する。再帰型ニューラルネットワークは系列に沿った記憶を導入する。自己注意は、トークン間の動的で大域的な相互作用を可能にする。それぞれのアーキテクチャが文脈と計算効率をどう扱うかを分析する。
3.3「RNNからTransformerへ」では、再帰型モデルから注意機構に基づくアーキテクチャへの歴史的な移行をたどる。再帰がなぜスケールの制約になったのか、Transformerがそのボトルネックをどう取り除いたのかを見る。
3.4「なぜ注意機構がすべてを変えたのか」では、自己注意の仕組みをさらに掘り下げ、その設計がなぜ長距離の依存関係のモデル化と並列学習を可能にしたのかを説明する。
3.5「活性化関数と最適化」では、深いネットワークが大規模でも安定して収束するための非線形の構成要素と学習のダイナミクスを取り上げる。
まずは、後に登場するすべてのアーキテクチャが依拠する基礎的な構成要素を確認しよう。
3.1 ニューラルネットワークの基本概念
大規模言語モデルがどう学習するのかを理解するには、まずニューラルネットワークが機能の面から見て何なのかを理解する必要がある。核心だけを言えば、ニューラルネットワークはパラメータを持つ関数である。入力ベクトルを受け取り、一連の数学的な変換を適用して、出力ベクトルを生成する。変換のふるまいはパラメータ、つまり数値の重みによって決まり、学習中は損失関数が最小になるようにこの重みが調整される。
かみくだいて言うと
ニューラルネットワークとは、数百万から数十億個のつまみがついた長い計算のレシピのようなものだ。つまみの1つひとつはパラメータと呼ばれる数値である。ネットワークを学習させるとは、レシピの出力がそれまでに見た例と一致するようになるまで、すべてのつまみを少しずつ回していくことだ。学習済みのネットワークとは、そうしたつまみすべての最終的な設定値にほかならない。
もっとも単純な構成要素である線形層から始めよう。入力を数値のベクトルとして表すとする。言語モデルでは、このベクトルは多くの場合、埋め込みから得られる。埋め込みは、トークンの整数IDを連続的な高次元空間に写像するものだ。線形層は、この入力ベクトルに重み行列を掛け、バイアスベクトルを足す。
直感的に言えば、線形層は入力の各次元を混ぜ合わせ、重みをつけ直して新しい表現を作る。ただし、線形変換だけでは表現力に限界がある。線形層を何も手を加えずに積み重ねても、結果はやはり1つの線形関数にすぎない。複雑なパターンをモデル化するには、非線形性が必要になる。
ここで活性化関数が登場する。各線形変換のあとで、ベクトルの各要素に非線形の関数を適用するのだ。よく使われる活性化関数には、ReLU(Rectified Linear Unit)やGELU(Gaussian Error Linear Unit)などがある。こうした関数のおかげで、ネットワークは入力と出力のあいだのきわめて複雑な対応関係を近似できるようになる。非線形性がなければ、言語の階層的な構造や、部分を組み合わせて意味を作る構成的な構造をとらえることはできない。
ニューラルネットワークは、線形変換、活性化、また線形変換、また活性化、というように層を積み重ねて作られる。各層は中間的な表現を出力し、これは隠れ状態と呼ばれることが多い。言語モデルでは、層を重ねるごとに、隠れ状態がより豊かな文脈情報をとらえるようになる。浅い層は局所的な構文の関係を、深い層は抽象的な意味のパターンを符号化する傾向がある。
ネットワークを学習させるには、モデルの予測が正しい目標からどれだけずれているかを測る損失関数を定義する。言語モデリングでは、通常、トークン上の予測確率分布と実際の次トークンとのあいだの交差エントロピー損失を使う。そこで鍵となる問いは、この損失を減らすにはパラメータをどう調整すればよいか、である。
その答えが勾配降下法だ。勾配とは、各パラメータに対して損失がどう変化するかを表す偏微分を並べたベクトルである。層を重ねたネットワークで勾配を効率よく計算するアルゴリズムが誤差逆伝播法で、これを使って誤差の信号を出力層からネットワークを逆向きにたどって伝えていく。各パラメータは、損失が減る方向にわずかずつ更新される。この処理を数百万から数十億の学習例にわたって繰り返すことで、ネットワークは次第に、観測されたトークン列に高い確率を割り当てる関数へと形づくられていく。
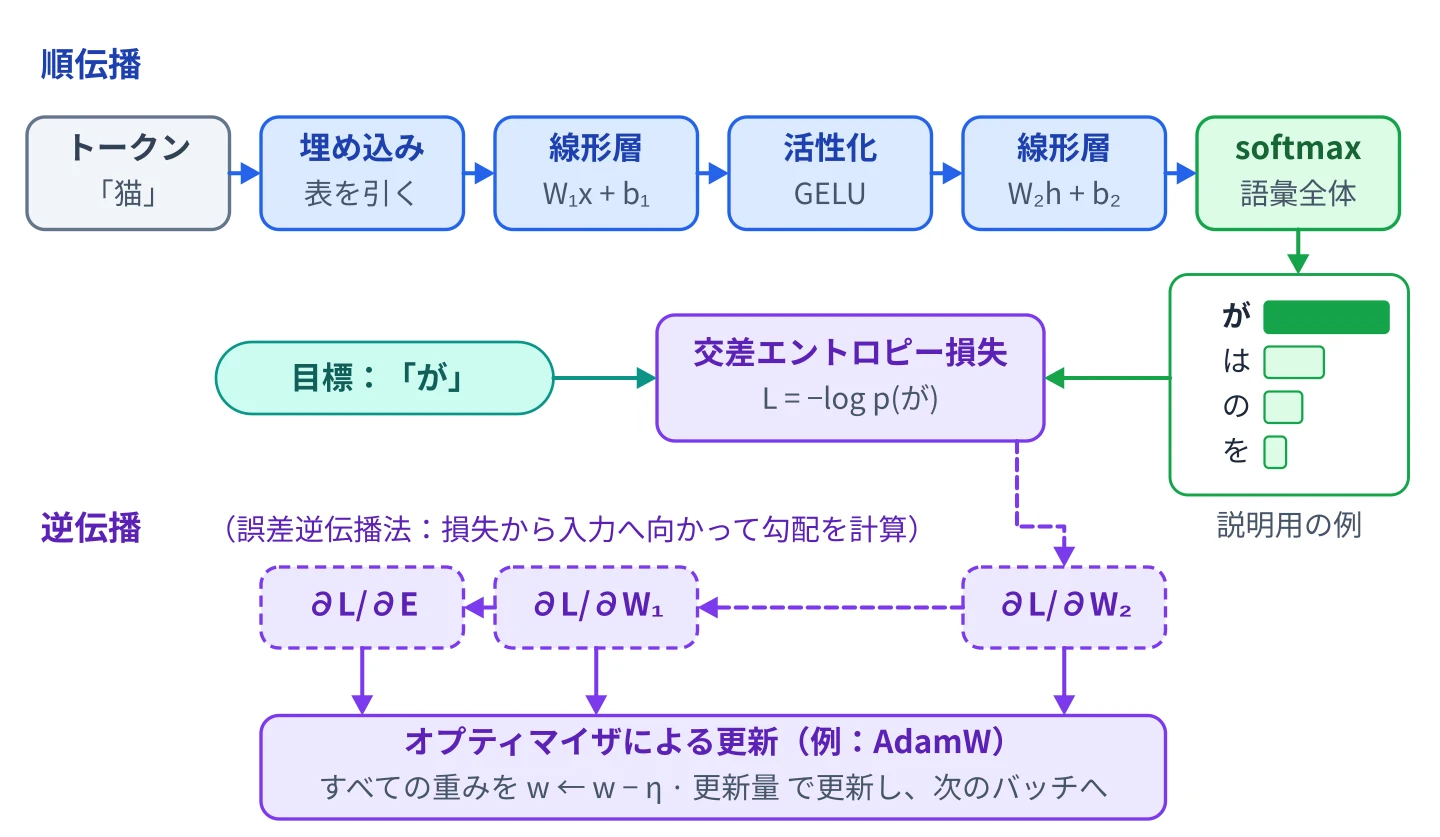
ニューラルネットワークの重要な性質の1つが、パラメータの共有である。同じ重みが多くの例と位置にわたって適用される。これが汎化を可能にする。ありうるトークン列をすべて記憶する代わりに、ネットワークはパラメータの中に再利用可能なパターンを蓄える。モデルのサイズを大きくするとパラメータ数が増え、表現できる容量が大きくなる。ただし、大きなモデルを効果的に学習させるには、より多くのデータと計算資源が必要になる。
最後に、埋め込みをもう少し詳しく見ておこう。埋め込み層は、離散的なトークンIDを連続的なベクトルに写像する。このベクトルは学習の中で獲得される。似た文脈に現れるトークンは似た埋め込みを獲得する傾向があり、そのベクトルは空間の中で近い領域に位置する。この幾何学的な構造のおかげで、モデルは完全に一致するものを超えて汎化できる。出現回数だけに基づくシステムでは不可能な能力だ。
線形変換、活性化、埋め込み、最適化という基礎的な概念がそろったので、系列をモデル化するためのアーキテクチャ上の戦略を比べられるようになった。次節では、フィードフォワードネットワーク、再帰型ネットワーク、自己注意機構が文脈をどう扱うかの違いを、3.2節「フィードフォワード、再帰、自己注意」で見ていく。
3.2 フィードフォワード、再帰、自己注意
層、活性化、埋め込み、勾配に基づく最適化という、ニューラルネットワークの基本的な構成要素がわかったので、アーキテクチャごとに系列の扱い方がどう違うかを調べられる。言語は本質的に系列である。あるトークンの意味は、その前に来るトークンに左右される。したがって、アーキテクチャ上の中心的な課題は、文脈をどう取り込むかということになる。
かみくだいて言うと
この節では、言語のために試されてきた3種類のニューラルネットワークの「形」を比べる。大事なのは、どの形にも特有の弱点があり、中でも自己注意という形が大規模でうまく機能するものとして残ったという点だ。残りの2つは、主に自己注意がなぜ重要なのかを理解するための歴史的な背景と考えてよい。
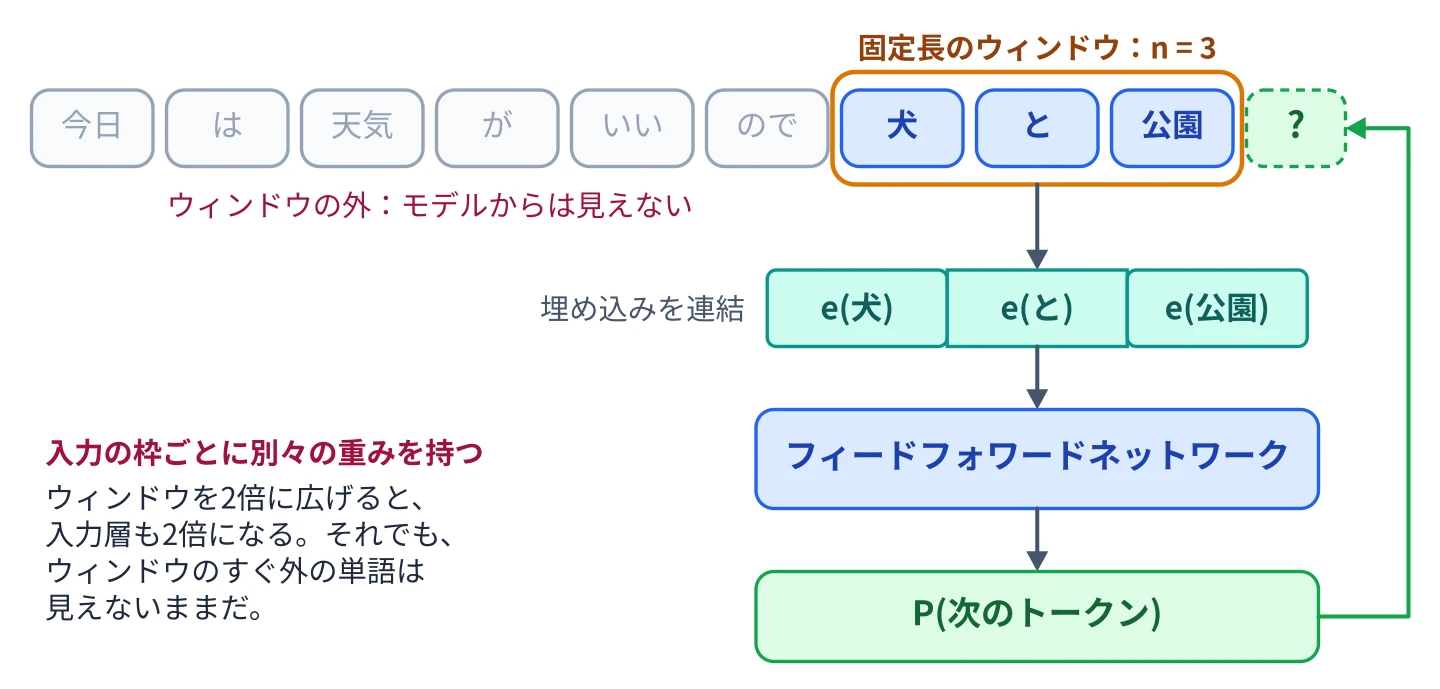
まずはフィードフォワードネットワークから見ていこう。フィードフォワードネットワークは、入力ベクトルを処理して出力ベクトルを生成するが、順序や時間的な依存関係という概念を組み込んでいない。各入力は独立に扱われる。初期のニューラル言語モデルでは、固定長のコンテキストウィンドウが使われた。直前の少数のトークンを連結して1本のベクトルにし、それをフィードフォワードネットワークに通して次のトークンを予測していたのだ。
この方法は短い文脈ではうまくいったが、長い系列には拡張できなかった。ウィンドウを広げるとパラメータ数が急激に増え、しかも長さの異なる依存関係をうまく扱う仕組みはやはり欠けていた。
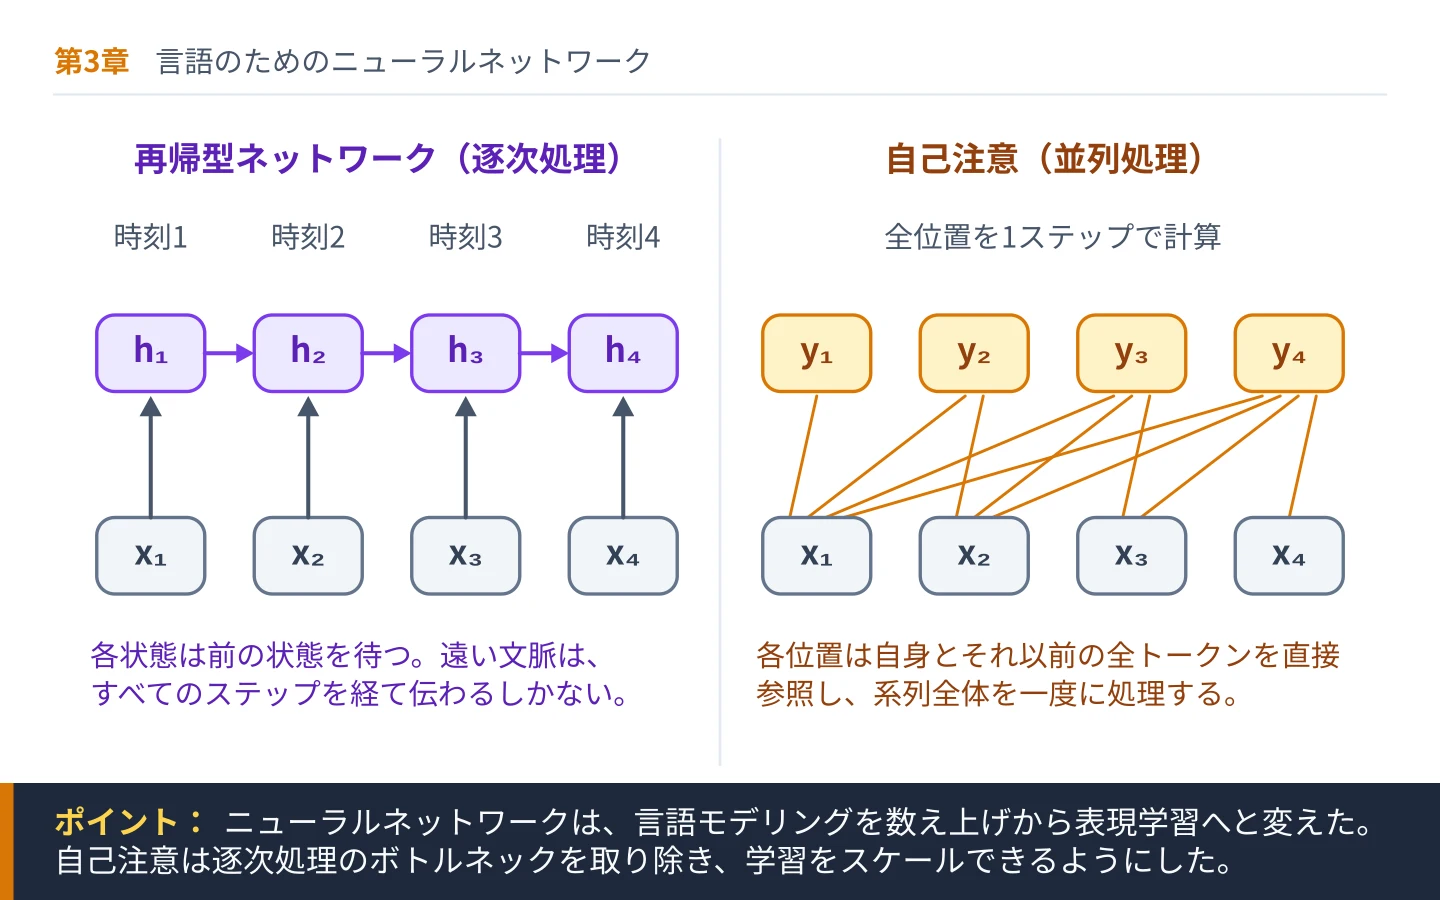
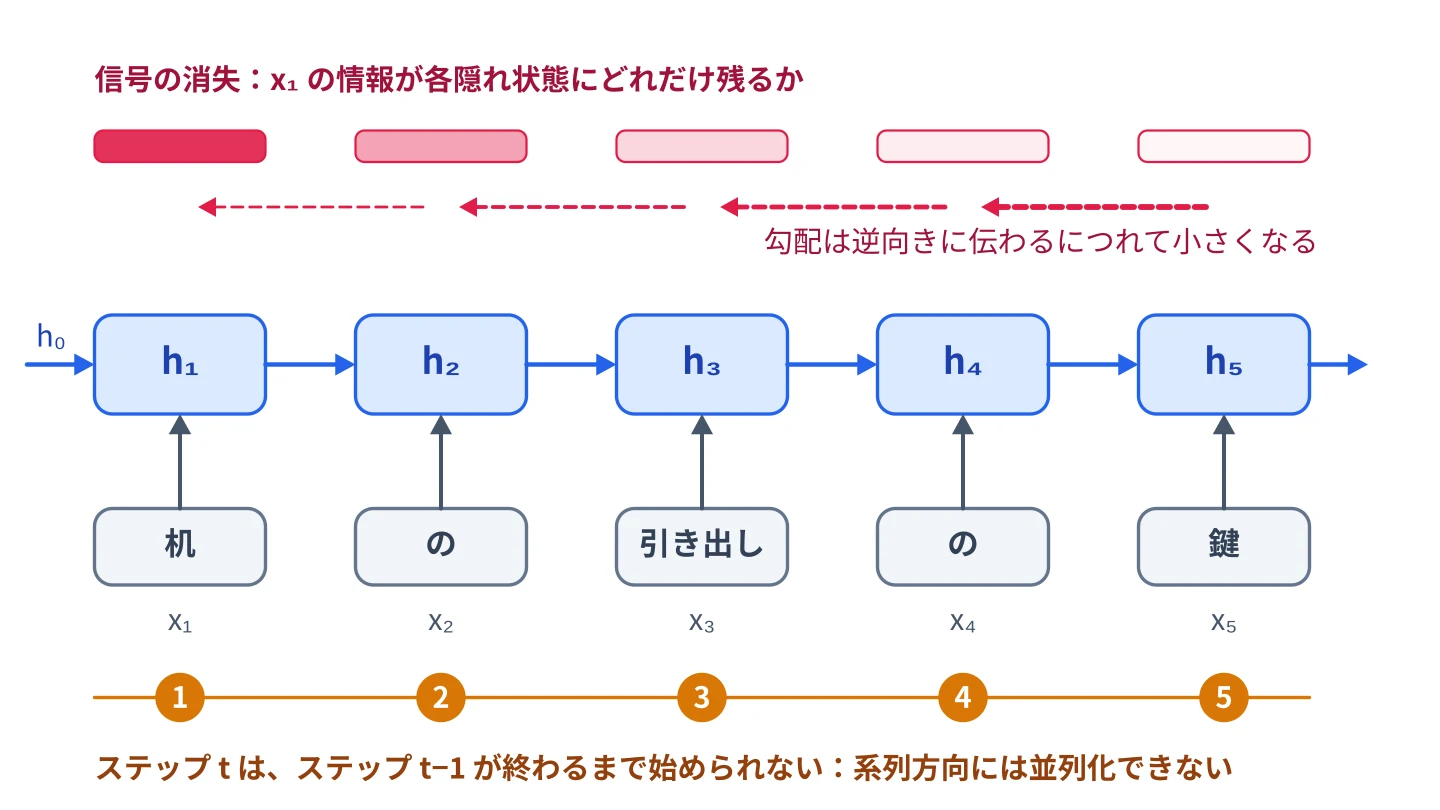
この制約に対処するために導入されたのが、再帰型ニューラルネットワーク(RNN)である。RNNは固定長のウィンドウを処理するのではなく、隠れ状態のベクトルを保持しながらトークンを1つずつ処理する。各ステップで、現在の入力トークンと直前の隠れ状態をもとに隠れ状態を更新する。これが一種の記憶になる。原理的には、隠れ状態は系列内のそれまでのすべてのトークンについての情報を符号化できる。同じパラメータを各時間ステップで使い回すので、パラメータ数を増やさずに任意の長さの系列を扱える。
しかし、標準的なRNNは勾配消失問題と呼ばれる現象に悩まされる。学習中、多くの時間ステップをさかのぼって伝えられる勾配は指数的に小さくなることがあり、ネットワークが長距離の依存関係を学びにくくなる。長短期記憶(LSTM)やゲート付き回帰ユニット(GRU)といった変種は、情報の流れを調整するゲート機構を導入して、この問題を緩和した。これらのアーキテクチャは多くのタスクで性能を高め、数年にわたって系列モデリングの主流となった。
こうした改良があっても、再帰型モデルには構造的な限界が残る。トークンを順番に処理するので、時間ステップをまたいで計算を完全に並列化することができない。これが、特に大規模な学習の効率を制限する。さらに、LSTMは単純なRNNより長い依存関係をとらえられるとはいえ、各ステップでそれまでの文脈すべてを1本の隠れ状態ベクトルに圧縮していることに変わりはない。非常に長い系列では、この圧縮がボトルネックになりうる。
自己注意機構は、根本的に異なるアプローチをとる。それまでのトークンを、少しずつ変化していく1つの状態に押し込めるのではなく、各トークンが系列内の他のすべてのトークンと直接やりとりできるようにするのだ。モデルは各トークンについて、他のトークンにどれだけ注目するかを決める注意の重みを計算する。この重みは、入力ベクトルに学習済みの射影を施した結果から動的に計算される。その結果として得られるのは文脈ベクトルの重みつきの和で、各トークンが現在の位置にとってどれだけ関連しているかを反映している。
この設計にはいくつかの利点がある。第一に、1本のベクトルへの圧縮を繰り返さずに、長距離の依存関係をとらえられる。長い文書の末尾にあるトークンが、冒頭のトークンに直接注意を向けられるのだ。第二に、注意機構に基づくアーキテクチャは並列化しやすい。学習中は系列内のすべてのトークンを同時に処理できるので、現代のハードウェアでの計算効率が大きく向上する。第三に、自己注意は、変化する文脈上の関係に自然に適応する。各予測にとってどのトークンがもっとも重要かを、モデル自身が学ぶのだ。
もちろん、注意機構にもトレードオフがある。トークン間のペアごとの相互作用の計算量は系列長の2乗で増えるため、非常に長い文脈ではメモリと処理の負担が大きくなる。それでも、自己注意の表現の柔軟さとスケーラビリティが決め手になった。
再帰型のアーキテクチャから注意機構に基づくモデルへの移行は、言語モデリングの転換点となった。次節では、この移行がどのように起こり、なぜ大規模な能力の扉を開いたのかを見ていく。
3.3 RNNからTransformerへ
長年にわたり、再帰型ニューラルネットワークと、LSTMのようなゲート付きの変種が、系列モデリングの最先端を担ってきた。初期のニューラル機械翻訳システムや音声認識のパイプライン、言語モデルを支えていたのはこれらのモデルである。しかし、データセットが大きくなり計算資源が拡大するにつれて、その構造的な限界がますますはっきりしてきた。
かみくだいて言うと
再帰型ネットワークは、テキストを1語ずつ読み、読みながら小さな要約を次へ受け渡していく。人間の読み方に似ているが、問題が2つある。長い文章では要約から細部が失われていくこと、そして各語が前の語の処理を待たなければならず遅いことだ。Transformerは、すべての語が他のすべての語を一度に見られるようにすることで、この両方の問題を解決した。
中心的な問題は、計算が逐次的に依存していることにあった。RNNはトークン t_{k} を、t_{k-1} を処理し終えてからでないと処理できない。この厳密な順序のせいで、学習で並列ハードウェアを十分に活用できない。バッチ処理をしても、各系列は時間に沿って1ステップずつ進むしかない。系列が長くなり、モデルが深くなると、この制約が学習を大きく遅らせる。
もう1つの限界は、情報の表し方にあった。各時間ステップで、それまでの文脈全体が1本の隠れ状態ベクトルに圧縮される。LSTMはゲート機構によって長期的な情報の保持を改善したが、1つの共有された状態を繰り返し更新する方式であることに変わりはなかった。長距離の依存関係をとらえるには、関連する情報が多数の変換を経ても劣化せずに生き残る必要がある。実際には、コンテキストが長くなるほど性能は低下した。
研究者たちは、こうした問題を和らげるため、再帰型モデルの内部に注意機構を組み込むことを試み始めた。たとえばニューラル機械翻訳では、注意機構によって、デコーダはエンコードされた最終状態だけに頼るのではなく、入力系列の関連する部分に選択的に焦点を当てられるようになった。この考え方は、より一般的なアーキテクチャの転換を示唆していた。そもそも再帰は必要なのだろうか、という問いである。
Transformerアーキテクチャは、この問いから生まれた。Transformerは再帰によってトークンを順番に処理するのではなく、自己注意とフィードフォワード層だけで構成される。系列内のすべてのトークンが同時に処理される。各層がすべてのトークンのペアについて注意スコアを計算するので、系列内の距離にかかわらずトークン同士が直接相互作用できる。
ここで決定的に重要なのが、位置の情報だ。再帰型モデルでは位置の情報が暗黙のうちに符号化されていたが、Transformerではそれを明示的に与えなければならない。そのための仕組みが位置エンコーディングである。元のTransformerは、固定の正弦波による位置信号をトークンの埋め込みに加えていた。現在の大規模言語モデルの多くは、代わりにRoPE(回転位置埋め込み)を使う。RoPEは各注意層の中でクエリとキーのベクトルを回転させ、注意スコアがトークン間の相対的な距離に依存するようにする。位置が符号化され、注意機構が大域的な相互作用を担うようになると、再帰はもはや必要なくなる。
この設計は、決定的な利点を2つもたらした。第一に、大規模な並列化が可能になった。学習を、再帰型モデルよりもはるかに効率よく、多数のGPUや専用ハードウェアに分散できるようになった。第二に、勾配の流れが改善された。情報が通過する逐次的なステップが少ないので、長距離の依存関係を学びやすい。注意機構が離れたトークンのあいだに直接の経路を作るので、中間の表現にかかる負担が減る。
モデルのパラメータ数と学習データの量が増えるにつれて、こうしたアーキテクチャ上の利点は相乗的に効いてきた。Transformerは数億、数十億、そしてついには数千億のパラメータへと滑らかにスケールした。その後、トークンごとに重みのごく一部だけを使う疎な混合エキスパート(MoE)型の変種では、総パラメータ数が1兆を超えている。複雑な言語構造をモデル化する能力もスケールとともに向上し、言語の理解と生成は劇的な進歩を遂げた。
RNNからTransformerへの移行は、単なる段階的な最適化ではなかった。アーキテクチャの原理を、現代のハードウェアや大規模学習のダイナミクスと整合させる構造的な再設計だった。再帰という計算上のボトルネックが取り除かれると、スケールが進歩の主軸になった。
この転換がなぜこれほど大きな変革をもたらしたのかを理解するため、次は中心となる仕組みを詳しく調べる。次節では、3.4節「なぜ注意機構がすべてを変えたのか」を見ていこう。
3.4 なぜ注意機構がすべてを変えたのか
Transformerアーキテクチャの中心には、一見拍子抜けするほど単純なアイデアがある。文脈を1ステップずつ圧縮していく代わりに、各トークンが他のすべてのトークンを直接見て、何が重要かを判断できるようにする、というものだ。この仕組み、すなわち自己注意が系列モデリングを作り変えたのは、再帰より複雑だったからではない。表現、計算、スケーリングを、根本的に柔軟な形でかみ合わせたからだ。
かみくだいて言うと
注意機構(アテンション)とは、文中のすべての語が他のすべての語を直接見て、どれが重要かを判断できるようにする工夫だ。情報を1ステップずつ先へ運ぶのではなく、モデルは文章全体に一度に情報を行き渡らせる。このほうが正確で、しかも現代のハードウェアでははるかに速い。今日の大規模なモデルを可能にしたのは、この仕組みである。
注意機構を直感的に理解するために、長い段落を読む場面を想像してみよう。「それ」のような指示語に出会ったとき、私たちは直前の語だけを頼りにするわけではない。文章の前のほうを頭の中で見返して、何を指しているのかを突き止める。注意機構は、このふるまいを形式化したものだ。モデルは系列内の各トークンについて、他のすべてのトークンをどれだけ強く考慮すべきかを決める注意の重みを計算する。この重みは固定されておらず、トークンの表現に学習済みの射影を施した結果から動的に計算される。
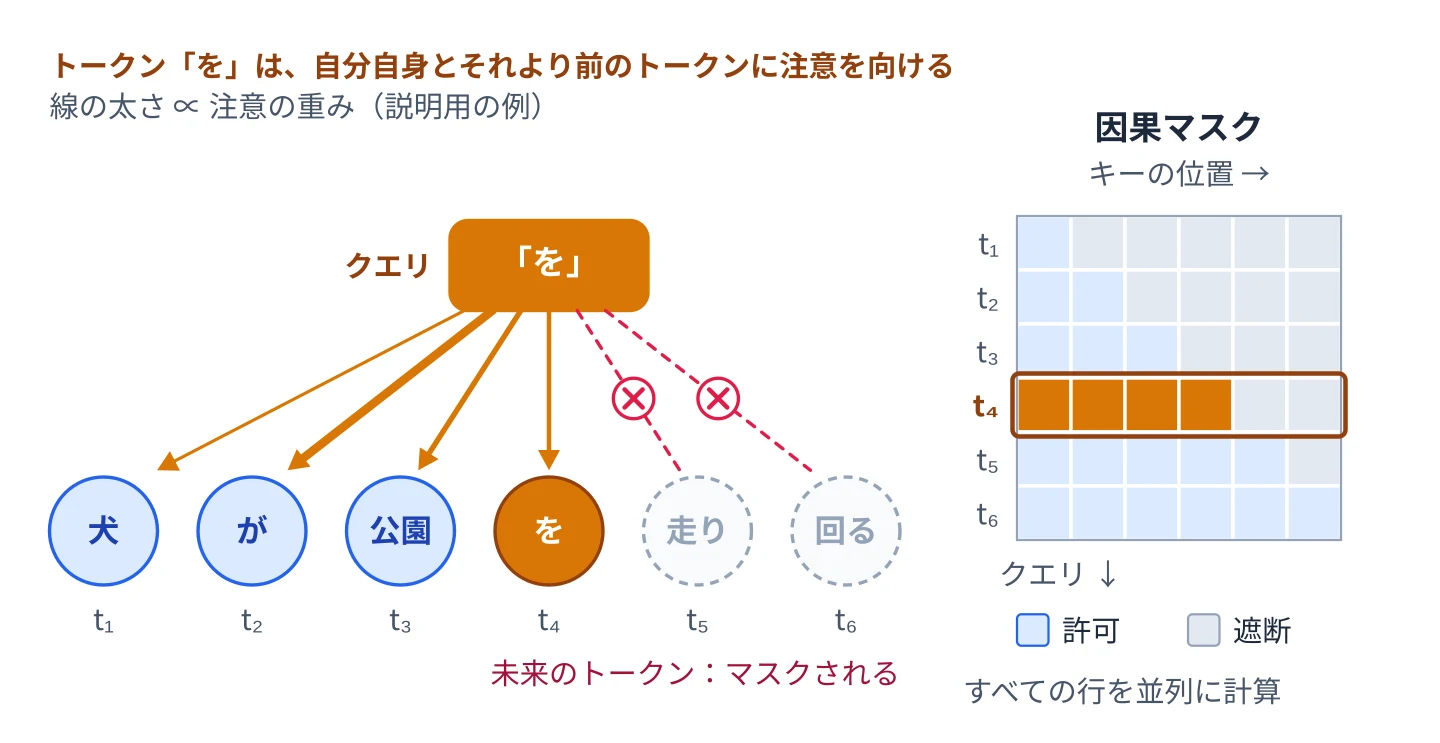
技術的には、各トークンの埋め込みは、クエリ、キー、バリューという3つのベクトルに変換される。あるトークンのクエリを、すべてのトークンのキーと類似度で比べる。類似度には、通常、スケーリングした内積を使う。得られたスコアをsoftmax関数で正規化して、注意の重みにする。この重みをバリューのベクトルに適用して重みつきの和をとると、それがそのトークンの更新後の表現になる。つまり各トークンは、学習した関連度で重みづけしながら、系列全体から情報を集めるのだ。テキスト生成に使われるデコーダ専用モデルでは、この注意は因果的である。因果マスクによって各トークンが自分より後の位置に注意を向けられないようにし、次のトークンの予測にそのトークン自体の情報が使われないようにしている。
この構造は大きな意味を持つ。第一に、少しずつ変化していく1本の隠れ状態というボトルネックがなくなる。再帰型ネットワークでは、それまでの情報をすべて、各時間ステップで1本のベクトルに符号化しなければならない。注意機構に基づくモデルでは、情報は多数の直接の経路を同時に流れることができる。位置1のトークンは、途中の98個の状態を経由せずに位置100に影響を与えられる。
第二に、注意機構は並列処理を可能にする。すべてのトークンのペアについての注意の重みは行列演算で計算されるので、現代のハードウェアは系列全体を一度に処理できる。これによって学習が劇的に速くなり、モデルを巨大なサイズまでスケールできるようになる。数十億のパラメータを持つモデルを膨大なコーパスで学習させられるのは、注意機構がもたらすアーキテクチャ上の並列性と切り離せない。
第三に、注意機構は構造のレベルで解釈の手がかりを与える。ニューラルネットワークが複雑であることに変わりはないが、注意の重みを見れば、ある予測にどのトークンが影響しているかについての手がかりが得られる。こうしたパターンは文脈上の関係をのぞく窓になるが、読み方には注意が要る。注意の重みは、モデルがなぜその出力を生成したのかを忠実に説明していないことが多いと研究で示されており、現在の解釈可能性の研究は、注意層とフィードフォワード層が協調して計算する内部表現や回路の分析に、より多くを頼っている。
マルチヘッド注意は、この仕組みをさらに拡張する。モデルは注意の分布を1つだけ計算するのではなく、それぞれ固有の学習済み射影を持つ複数の注意を並列に計算する。ヘッドごとに役割が分かれることがある。あるヘッドは構文の関係に、別のヘッドは同じものを指す表現どうしの対応(共参照)に、また別のヘッドは位置のパターンに注目する、といった具合だ。各ヘッドの出力は連結され、変換されて、表現の多様性を豊かにする。
とはいえ、注意機構はタダではない。すべてのトークンが他のすべてのトークンに注意を向けるので、計算コストは系列長の2乗で増える。これが、疎な注意機構や線形化した注意機構の研究を促してきた。実際には、大規模なモデルの多くは今でも厳密な注意を計算しているが、それを安くする工夫を施している。FlashAttentionのようにメモリの読み書きを意識したカーネルはメモリの転送量を減らし、グループ化クエリ注意(grouped-query attention)は複数のヘッドでキーとバリューの射影を共有して、推論処理に必要なメモリを小さくする。2025年以降は、全体を見渡す注意層を少数だけ残し、計算コストが系列長に比例してしか増えない線形注意の層と交互に並べたハイブリッド型の設計を採用する実用モデルも現れている。こうしたコストはあっても、注意機構が主流のパラダイムであり続けているのは、ほとんどの実用的な場面で、その表現力とスケーラビリティが計算の負担を上回るからだ。
注意機構がすべてを変えたのは、文脈のモデル化のしかたを定義し直したからだ。逐次的な記憶を動的で大域的な相互作用に置き換え、大規模な並列学習を実現可能にした。その結果得られたのは、単に速いモデルではなく、質的に強いモデルだった。
中心となる仕組みがわかったところで、理解すべきことがもう1つ残っている。ニューラルネットワークの学習は、アーキテクチャだけでなく、学習を形づくる非線形の変換と最適化の戦略にも支えられている。次節では、3.5節「活性化関数と最適化」を見ていく。
3.5 活性化関数と最適化
情報がモデルの中をどう流れるかはアーキテクチャが決めるが、そのアーキテクチャが実際に学習できるかどうかは、活性化関数と最適化が決める。非線形性と安定したパラメータの更新がなければ、どれほど洗練された設計でも、複雑な言語のパターンを近似することはできない。
かみくだいて言うと
活性化関数とは、ネットワークの層と層のあいだに入れる小さな数学的なひねりのことで、これがあるおかげでシステム全体が直線だけでなく曲線も学べるようになる。最適化とは、つまみを回していく手順のことだ。この2つは学習を成り立たせる配管のようなもので、数式を追わなくても、そこにあると信じておけば十分だ。
まず活性化関数から見ていこう。ニューラルネットワークの各層は、通常、線形変換のあとに非線形の活性化を適用するのだった。線形変換は重み行列によって入力を混ぜ合わせるが、非線形性がなければ、線形層をいくつ重ねても1つの線形関数に帰着してしまう。そのようなシステムでは、階層的な構造や、部分から組み立てられる意味をモデル化できない。そして言語は、本質的に強い非線形性を持つ。文の意味はトークン同士の相互作用に左右され、線形結合だけではとらえられない。
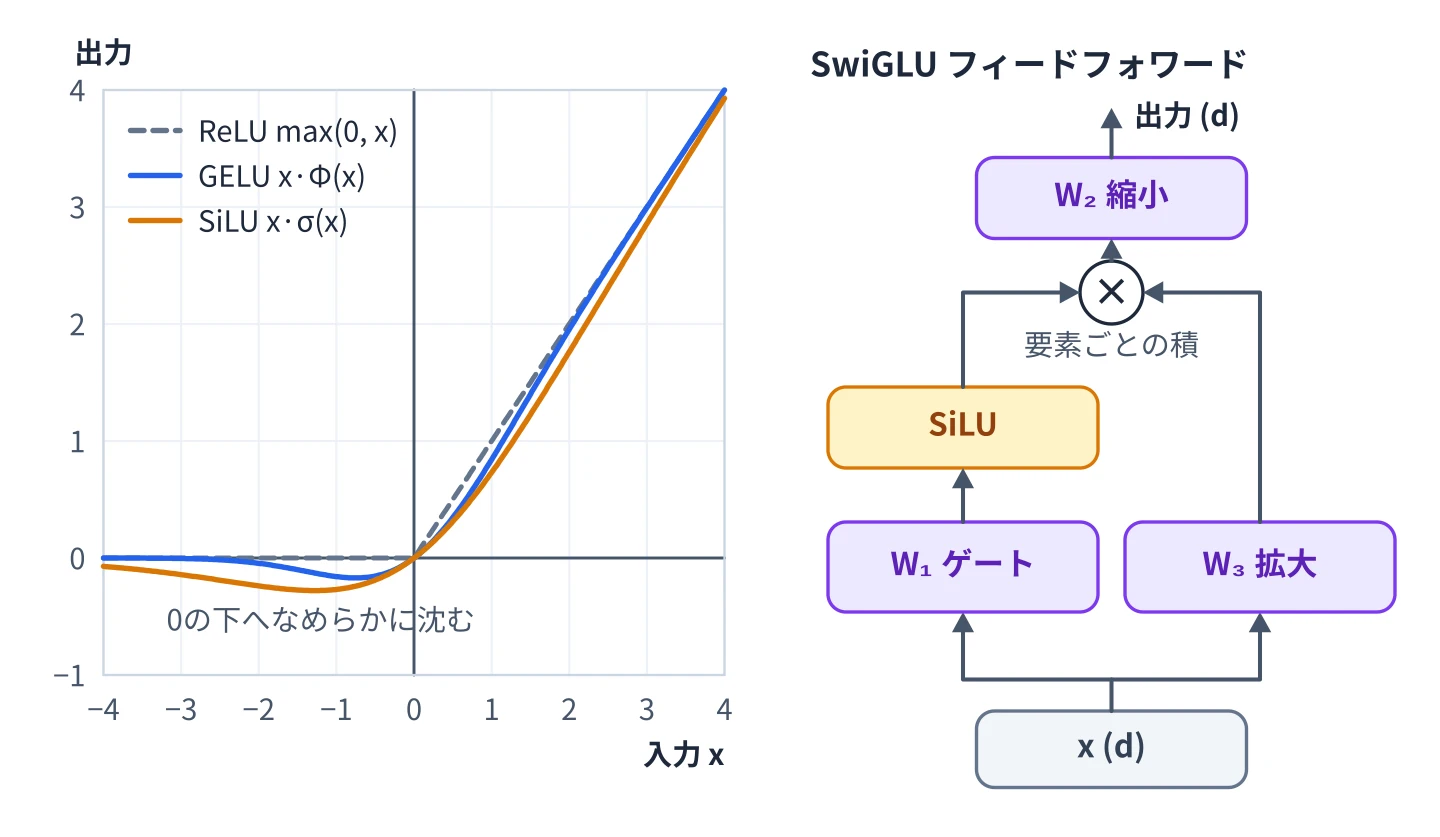
活性化関数は、この必要な非線形性を持ち込む。初期のネットワークでは、値を一定の範囲に押し込めるシグモイド関数やtanh関数がよく使われた。数学的には滑らかな関数だが、飽和することがある。つまり、入力の絶対値が大きいと勾配が非常に小さくなってしまう。勾配降下法はこの勾配を信号としてパラメータを更新するので、勾配が小さいと学習が遅くなる。
ReLU(Rectified Linear Unit)は、負の入力に対しては0を、正の入力に対してはそのままの値を出力することで飽和を減らし、勾配の流れを改善した。BERTやGPT-2といったTransformerモデルは、GELU(Gaussian Error Linear Unit)を採用した。GELUはより滑らかにふるまいながら、勾配についての良い性質も保つ。現在の大規模言語モデルの多くは、SwiGLUのようなゲート付きの変種を使っている。SwiGLUでは、フィードフォワード層が2つの射影を計算し、一方に滑らかな活性化を施したうえでもう一方と掛け合わせる。これによって、どの特徴を通すかをネットワークが学べるようになる。活性化関数の選択は、学習の安定性、収束の速さ、最終的な性能を左右する。
最適化とは、損失関数を最小にするようにパラメータを更新する方法のことだ。言語モデルでは、損失は通常、予測したトークン分布と真のトークン分布のあいだの交差エントロピーである。勾配降下法は、この損失を減らす方向にパラメータを更新する。しかし、モデルには数百万から数十億のパラメータがあるので、素朴な勾配降下法では効率が悪く、不安定になる。
実際のシステムでは、確率的勾配降下法(SGD)のような変種が使われる。SGDでは、データセット全体ではなく、ミニバッチと呼ばれるデータの小さなまとまりごとに更新を計算する。これによって更新にノイズが入るが、このノイズがかえって質の悪い局所解から抜け出す助けになることもある。
Adamのような適応型のオプティマイザは、この過程をさらに改良する。Adamは、勾配の1次および2次のモーメントの推定値に基づいて、パラメータごとに学習率を個別に調整する。これによって、大規模なネットワーク全体で、より速く収束し、より安定した学習が可能になる。大規模言語モデルの多くは、重み減衰を勾配の更新から切り離したAdamの変種、AdamWで学習されてきた。2025年以降は、各重み行列に適用する更新を直交化するMuonのような新しいオプティマイザも、1兆パラメータ規模で成功裏に使われている。大規模言語モデルでは、学習率のスケジュール、ウォームアップの期間、減衰の戦略を注意深く調整することがきわめて重要だ。わずかな設定ミスでも、学習が不安定になったり、最終的な性能が落ちたりする。
もう1つの欠かせない要素が正規化である。層正規化(Layer Normalization)のような手法は、中間表現を特徴の次元にわたって正規化することで、活性化を安定させる。これはもともと、「内部共変量シフト」、つまり学習中に各層への入力の分布が変わってしまう現象を減らすためと説明されていた。しかしその後の研究によれば、正規化の主な効果は、最適化の地形を滑らかで扱いやすいものにし、深いアーキテクチャでの勾配の流れを改善することにあると考えられている。現在の大規模言語モデルの多くは、簡略化した変種であるRMSNormを使い、それを各注意サブ層とフィードフォワードサブ層の後ではなく前に置いている。この配置のほうが、層が深くても安定して学習できるからだ。正規化がなければ、非常に深いネットワークを効果的に学習させるのは難しい。
スケールは最適化と強く相互作用する。モデルが大きくなるにつれて、学習のダイナミクスが変わる。学習率は調整し直す必要があり、バッチサイズは大きくなる。更新が爆発的に大きくなるのを防ぐため、勾配クリッピングが必要になることもある。数値の精度も考慮すべき点の1つだ。大規模なモデルは通常、16ビットのbfloat16形式で学習され、最先端規模の学習の中には、計算の大部分を8ビット浮動小数点(FP8)で行うものも現れている。FP8はメモリと帯域の負担を減らすが、精度を保つには注意深いスケーリングが必要になる。こうした工学上の考慮は周辺的な細部ではない。現代のLLMが発散することなく大規模に学習できる理由の中心にあるものだ。
ポイント:情報がモデルの中をどう流れうるかはアーキテクチャが決め、その流れを実際に学習できるかどうかは活性化関数と最適化が決める。どちらもスケールの前提条件であって、その下に隠れた細部ではない。
ニューラルアーキテクチャ、注意機構、最適化の原理がそろったことで、現代の大規模言語モデルを理解するための概念的な基盤ができあがった。次は、これらの構成要素が本格的なシステムの中でどう組み合わさるのかを調べる番だ。本書の次の部では、基礎的な概念から、統合されたアーキテクチャと学習のダイナミクスへと進む。第II部「LLMはどう動くのか」である。
第I部では土台を築きました。大規模言語モデルとは何かを定義し、言語をトークンの系列としてとらえ直し、次トークン予測を確率的な目的関数として定式化し、大規模な学習を可能にするニューラルネットワークのアーキテクチャを見てきました。ここからは、個々の部品からシステム全体へと視点を移します。
第II部のテーマは「統合」です。トークン化、確率、ニューラルネットワーク、注意機構、最適化といった部品が、どのように組み合わさって今日私たちが使っているモデルになるのか。この実践的な問いに答えていきます。概念的な仕組みからアーキテクチャの構造へ、理論から学習パイプラインへ、そしてベースモデルから実際のアプリケーションに組み込まれた適応済みのシステムへと進みます。
第4章「Transformerアーキテクチャ」では、現代のLLMを支えるアーキテクチャを構造面から掘り下げます。自己注意を数式と直観の両面から検討し、位置エンコーディングの仕組みとその必要性を確認し、エンコーダ、デコーダ、デコーダ専用モデルの違いを整理します。あわせて、Transformerがどのようにスケールするのか、数十億から数兆のパラメータでの学習を可能にしているのはどのような設計上の選択なのかも取り上げます。
第5章「大規模モデルの学習」では、LLMの構築に必要なデータとインフラに焦点を移します。膨大なデータセットをどう収集・選別するのか、前処理の判断がなぜ重要なのか、損失関数と勾配降下法が産業規模でどう機能するのかを分析します。分散学習、ハードウェア上の考慮点、そして過学習・学習不足・正則化という実践上の課題も扱います。アーキテクチャの理論を、大規模エンジニアリングの現実に結びつける章です。
第6章「ファインチューニングと適応」では、ベースモデルがどのようにして役に立つシステムになるのかを探ります。事前学習は汎用的な言語能力をもたらしますが、特定のタスクや領域に向けて振る舞いを磨くのは適応の手法です。ファインチューニング、指示チューニング、プロンプトによる適応、転移学習を実践に即して見ていきます。ゼロから学習し直すことなく、アラインメントと特化がどのように実現されるのかが明らかになるでしょう。
第7章「次トークン予測を超えて」では、視野をさらに広げます。学習の目的は次トークン予測ですが、実用的なシステムは純粋な生成の枠を超えることが少なくありません。意味の表現としての埋め込みを導入し、生成と検索を対比し、検索拡張生成(RAG)のようなハイブリッドなシステムを検討します。テキストが画像などほかのモダリティと関わり合うマルチモーダルな拡張にも触れます。言語モデリングの中核と、より広いAIシステム設計とをつなぐ章です。
これらの章を通して、大規模言語モデルが一つの完結したシステムとしてどう機能しているかが見えてきます。アーキテクチャ、データ、学習、適応が互いに作用し合い、現代の生成AIに見られる振る舞いを生み出しているのです。第I部で語彙を身につけたとすれば、第II部で手にするのは設計図です。
ポイント:LLMの仕組みを理解するには、内部のアーキテクチャだけでなく、実際の振る舞いを形づくる学習プロセスと適応の戦略にも目を向ける必要があります。
この先の探究は、大規模な言語モデリングを可能にした構造を調べるところから始めます。それでは第4章「Transformerアーキテクチャ」に進みましょう。
ポチっとでの実践
会話の続きを扱うには
「来週水曜」という返事を扱うには、どんな質問の後に来たかが大切です。モデルの内部表現と、アプリが管理する入力途中の状態を分けて設計すると、参照すべき質問や対象の予定を明示できます。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る