 Pocchito
第4章 Transformerアーキテクチャ
文の中のどこを参照し、情報をどう組み合わせるのか。自己注意を一文の例でたどります。
自己注意とは、同じ入力の中で参照できる位置から情報を取り込み、今の位置の表現を更新する計算です。
図解 「返す」を処理するときの情報の流れ
1.文を読む
「鍵を受付で借りた。どこに返す?」↓
2.参照先ごとに重みを求める
「返す」のQueryと、参照できる各位置のKeyを照合します。たとえば、説明用の重みを「鍵」0.3、「受付」0.5、「借りた」0.2とします。↓
3.情報を混ぜる
各位置のValueを重みに応じて足し合わせ、「返す」の表現を更新する材料にします。この例では「受付」の情報を多めに取り込みます。
重みは説明用の数値です。実際にはトークン単位で計算し、層や注意ヘッドによって重みも変わります。
ここまで、大規模言語モデルの概念的な土台を築いてきた。次トークン予測を確率的な目的関数として定義し、トークン化を検討し、ニューラルネットワークの基礎を探った。フィードフォワード、再帰、注意機構という三つのアプローチの比較も行った。いよいよ、現代の大規模言語モデリングを実用的なものにしたアーキテクチャ、Transformerにたどり着く。
第4章のテーマは構造である。Transformerがどう組み立てられているのか、情報が層の中をどう流れるのか、そしてこの設計がなぜこれほど効率よくスケールするのかを説明する。これまでの章は確率、最適化、表現といった原理を中心に扱ってきたが、本章の関心は部品の組み合わせ方にある。抽象的な仕組みから、具体的な設計図へと降りていく。
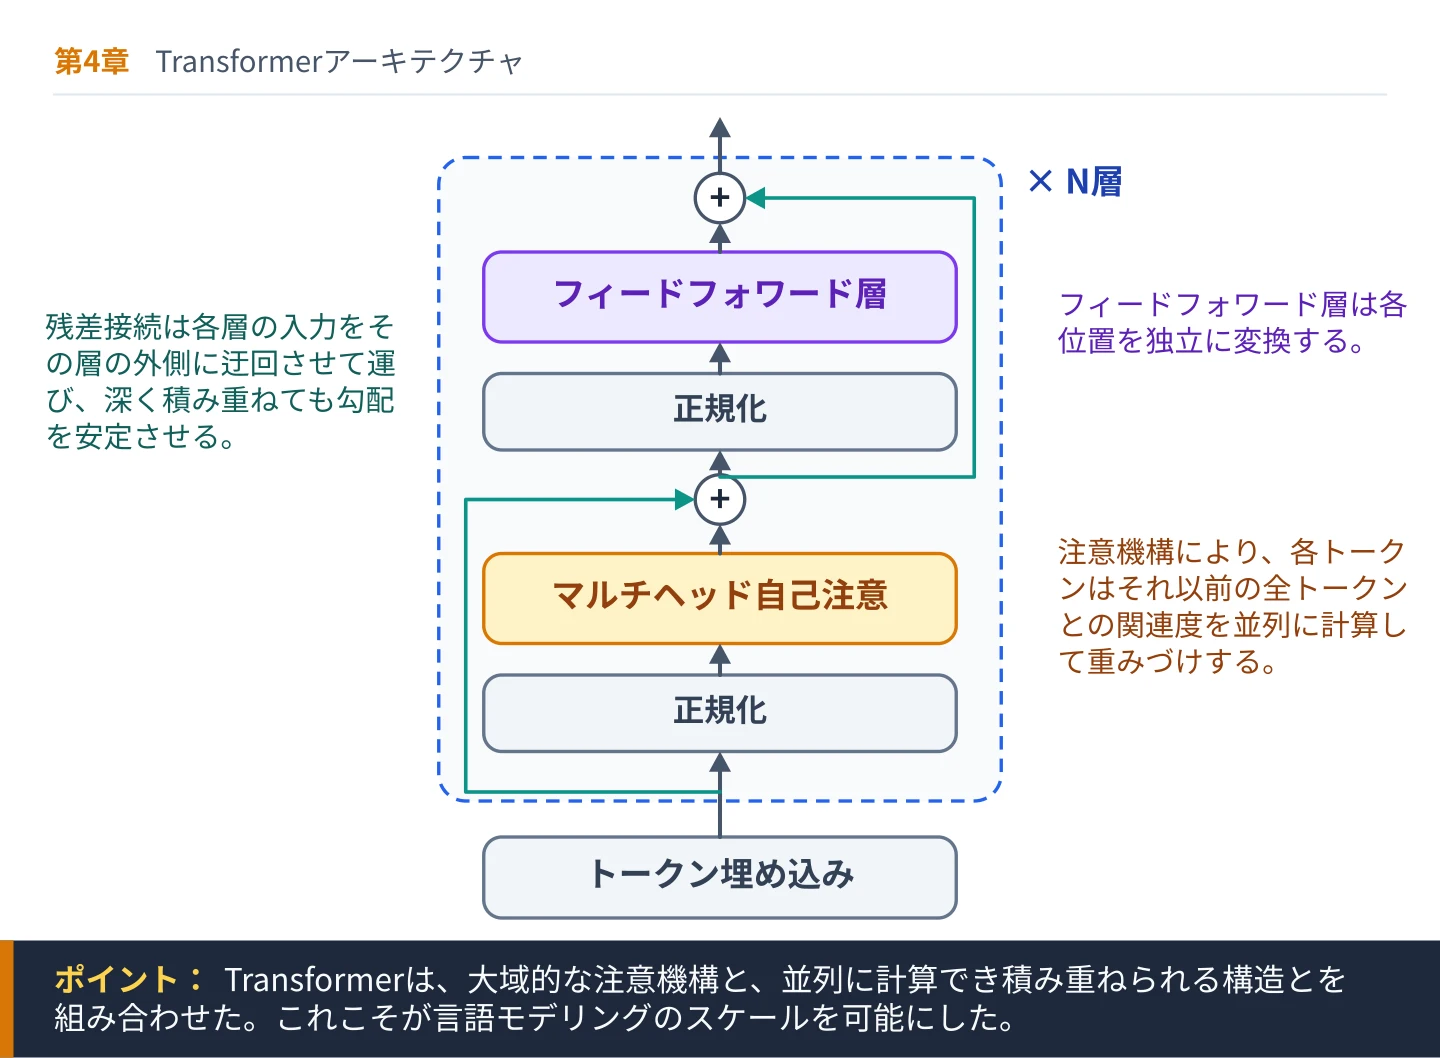
4.1節「アーキテクチャの全体像」では、Transformerブロックを中核の部品に分解する。マルチヘッド自己注意、フィードフォワード層、残差接続、正規化である。これらのブロックが何度も積み重ねられる様子と、深さを経るにつれてトークンの表現がどう変化していくかを見る。数学的な細部に入る前に、システム全体の明確なイメージをつかむことが目的だ。
4.2節「自己注意の仕組み」では、アーキテクチャの心臓部を分析する。スケール化内積注意を導出し、クエリ・キー・バリューを実際の働きに即して説明し、マルチヘッド注意が表現の柔軟性をどう高めるかを明らかにする。自己回帰的な生成に必要なマスクの手法も扱う。
4.3節「位置エンコーディング」では、注意機構だけでは系列の順序を表せないという問題を取り上げる。位置の情報をトークン埋め込みにどう注入するのかを探り、固定の位置表現と学習される位置表現を比較する。相対位置を表す現代的な変種も含めて検討する。
4.4節「エンコーダ、デコーダ、デコーダ専用モデル」では、アーキテクチャの変種を区別する。エンコーダ専用モデルが双方向の表現をどう実現するのか、エンコーダ・デコーダ型が系列の変換をどう扱うのか、そして現代のLLMの多くが次トークン予測に最適化されたデコーダ専用の設計を採用するのはなぜかを説明する。
4.5節「Transformerのスケーリング」では、深さ、幅、パラメータ数、データセットの規模がどう相互に作用するかを調べる。経験的に得られたスケーリング則と、ますます大きくなるモデルの学習・運用にともなう計算上のトレードオフを論じる。
まずは設計図を組み立てるところから始めよう。4.1節「アーキテクチャの全体像」に進む。
4.1 アーキテクチャの全体像
Transformerを理解するには、いったん引いた視点に立ち、数式の寄せ集めではなく構造化されたパイプラインとして眺めるとよい。大まかに言えば、Transformerはトークン埋め込みの系列を入力として受け取り、積み重ねた層を通してその表現を繰り返し磨き上げ、次のトークンの予測に使う文脈化されたベクトルを出力する。どの層も内部のパターンは同じだ。モデルの表現力を生むのは、各段階の目新しい工夫ではなく、深さである。
かみくだいて言うと
Transformerは、同じ形の層を積み重ねて作られている。建物のフロアのようなものだ。各フロアはテキストの表現を受け取り、少しだけ豊かにした表現を次のフロアへ渡す。テキストが数十のフロアを通り抜けるころには、各トークンは文章全体の文脈を取り込んだ表現になっている。
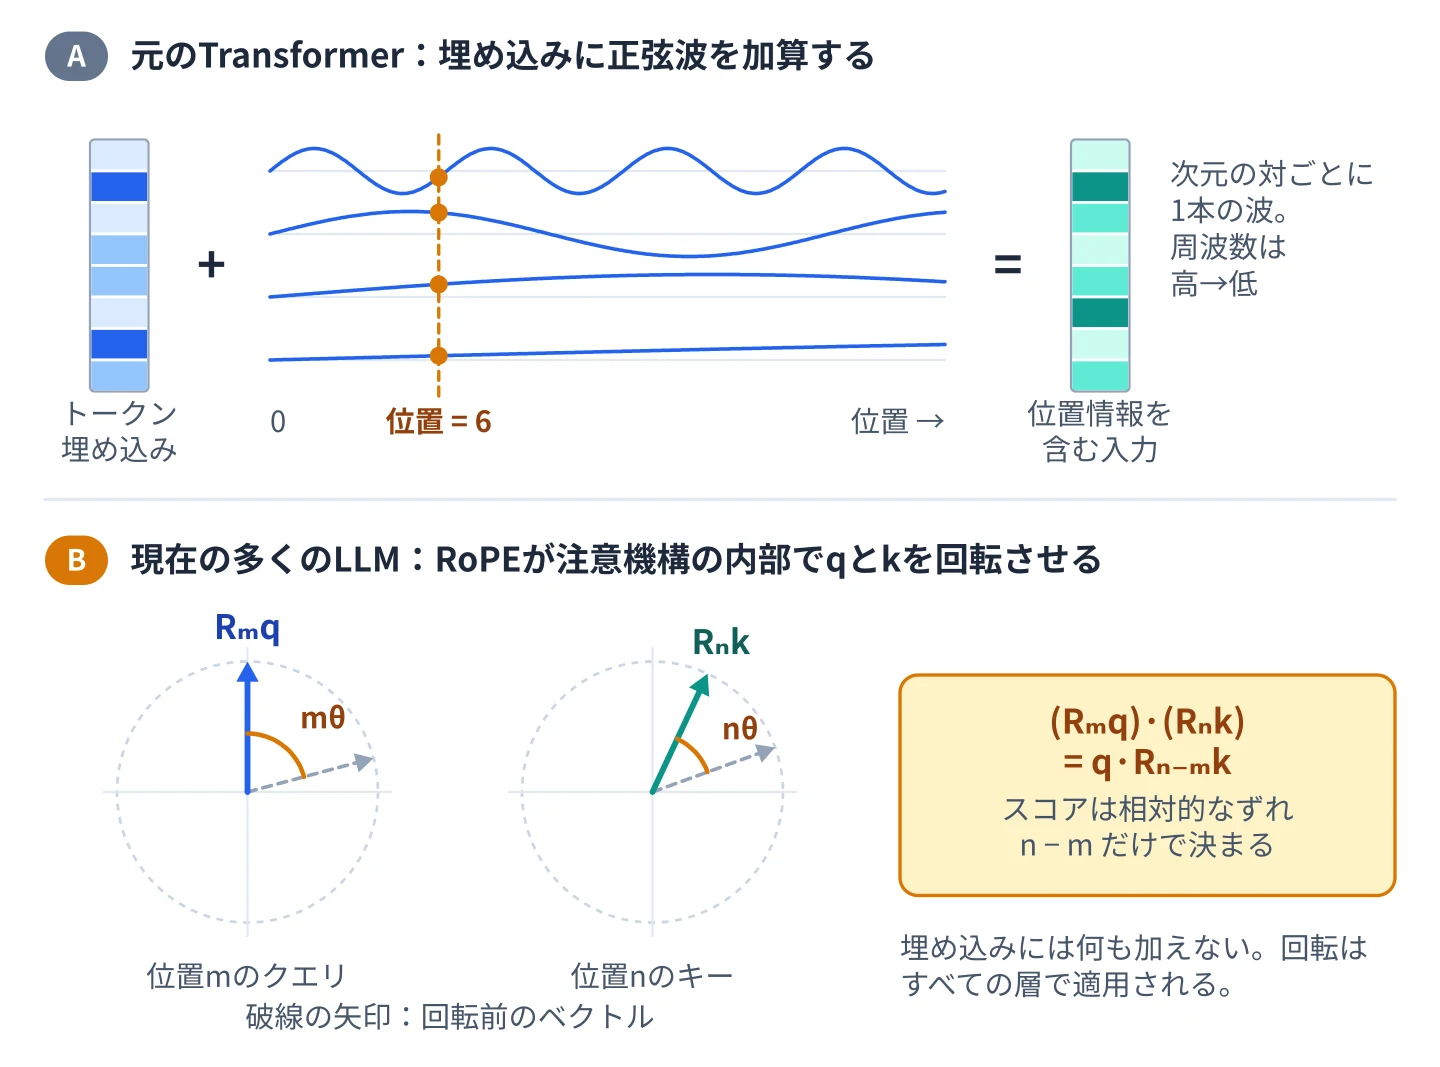
処理は埋め込みから始まる。各トークンIDは、高次元空間の連続的なベクトルに写像される。この埋め込みは、学習によって得られたトークン同士の関係を捉えている。次に、モデルが順序に基づいてトークンを区別できるよう、位置の情報が与えられる。元の設計ではこの情報を埋め込みベクトルに直接加算していたが、現在のモデルの多くは代わりに注意機構の計算の内部で位置情報を注入する(4.3節を参照)。こうして(系列長 × 埋め込み次元)の形をした行列ができ、これが最初のTransformerブロックへの入力になる。
Transformerブロックは主に二つのサブレイヤーからなる。マルチヘッド自己注意と、位置ごとのフィードフォワードネットワークだ。それぞれのサブレイヤーの周囲には、学習を安定させる二つの仕組み、残差接続と層正規化が配置されている。これらは注意機構そのものと同じくらい重要な要素である。
一つめのサブレイヤーでは、マルチヘッド自己注意によって、各トークンが系列内のほかのトークンから情報を取り込む。注意機構は文脈を一つのベクトルに圧縮するのではなく、すべてのトークンの情報に重みを付けて集約し、トークンごとに新しい表現を作る。この処理は系列全体に対して並列に行われるため、行列積を使って効率よく実装できる。
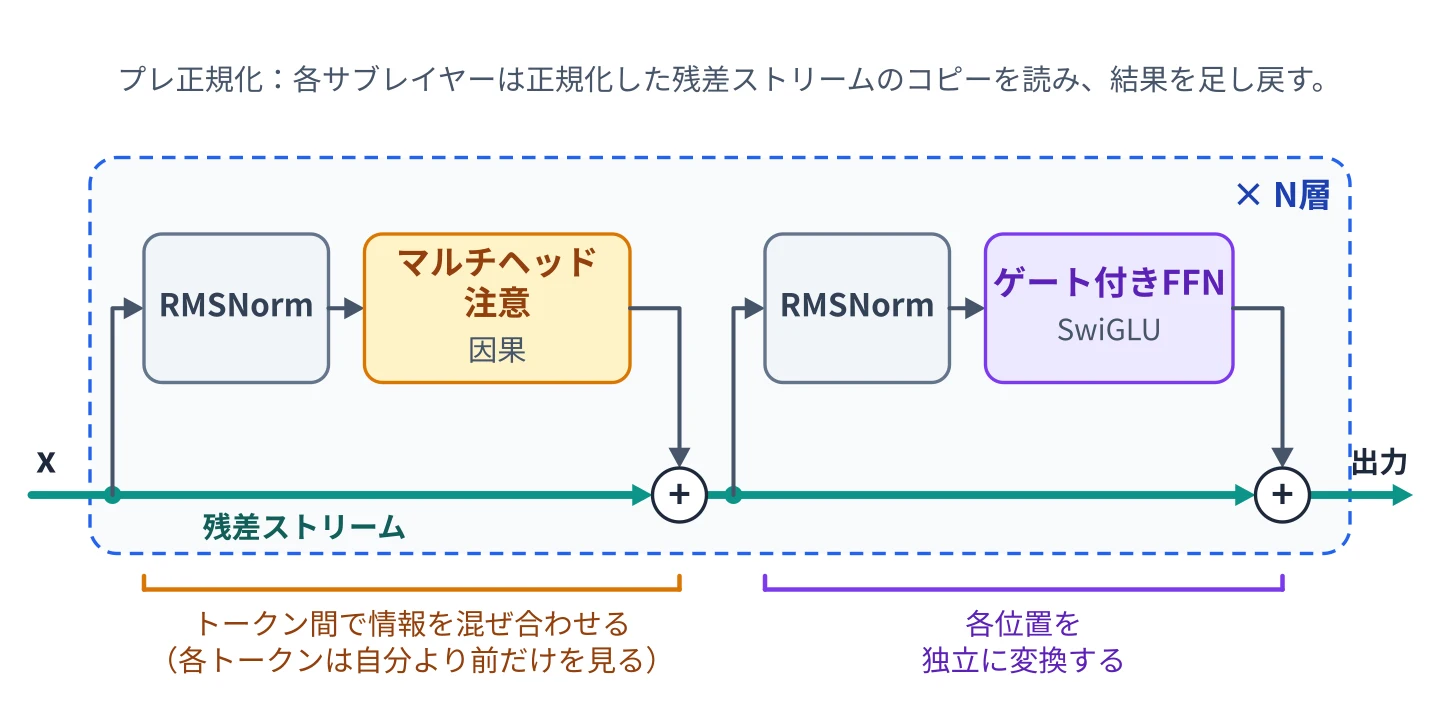
二つめのサブレイヤーは、各トークン位置に独立に適用されるフィードフォワードネットワークである。注意機構がトークン間で情報を混ぜ合わせるのに対し、フィードフォワード層は各トークンの表現を非線形に変換する。元の設計では、このネットワークは二つの線形変換の間に非線形の活性化関数を挟んだ構成で、次元をいったん広げてから再び縮める。現在のLLMの多くはゲート付きの変種(SwiGLUなど)を使う。三つめの射影でゲートを作り、活性化後の値に要素ごとに掛け合わせてから出力側の射影に渡す方式で、広げてから縮めるという構成自体は変わらない。こうしてトークン間の依存関係を新たに持ち込むことなく、表現力を高めている。
残差接続は、両方のサブレイヤーを囲むように配置される。残差接続とは、サブレイヤーへの入力をその出力に足し合わせる仕組みだ。この単純な加算によって勾配が深いネットワークを通りやすくなり、勾配消失や勾配爆発の問題が和らぐ。残差接続がなければ、非常に深いTransformerの学習は不安定になる。層正規化は活性化の値を標準化し、情報が深さ方向に進んでも分布が安定するようにする。元のTransformerは残差の加算のあとで正規化していたが、現在のLLMの多くは各サブレイヤーへの入力を正規化する方式(プレ正規化)をとり、RMSNormと呼ばれる簡略化された変種を使うことが多い。こちらのほうが、非常に深いモデルでも安定して学習できる。
完全なTransformerモデルは、同じ形のブロックを多数、しばしば数十個積み重ねる。層を経るごとにトークンの表現はさらに磨かれていく。浅い層は局所的な構文上の関係に注目し、深い層はより広い意味や談話レベルの構造を捉えることがある。注意機構とフィードフォワード変換を繰り返し合成することで、階層的な表現学習が可能になる。
最終層では、文脈化されたトークン表現を語彙の空間へ射影し直す。線形変換によって、各トークンのベクトルを語彙サイズと同じ長さのベクトルに写す。ソフトマックス関数がこのスコアを確率に変換し、次に来うるトークンについての分布が得られる。
構造の設計図がそろったところで、アーキテクチャの心臓部を数学的に詳しく見ていく準備ができた。次の4.2節「自己注意の仕組み」で、中核となる仕組みを一歩ずつ分解していく。
4.2 自己注意の仕組み
自己注意は、Transformerにおける計算の中核である。系列内の各トークンが、ほかのすべてのトークンから選択的に情報を取り込めるようにする仕組みだ。これを深く理解するには、たとえ話から仕組みそのものへと踏み込む必要がある。
かみくだいて言うと
自己注意とは、Transformerの中で、各単語がほかの単語それぞれを自分の理解にとってどれだけ重要とみなすかを決める部分である。「田中さんは佐藤さんに本を渡した。彼女はとても喜んだ」という文を読んで、「彼女」が誰を指すのかを前にさかのぼって見きわめる場面を想像してほしい。モデルはこれをすべての単語について並列に行い、その関係を使ってよりよい表現を組み立てる。
入力系列を行列 X で表すとしよう。各行は次元 d のトークン埋め込みに対応する。系列の長さを n とすると、X の形は n×d である。自己注意はこの行列を同じ形の新しい行列に変換するが、その各トークンの表現は文脈によって豊かになっている。
最初のステップでは、X から三つの別々の線形射影を計算する。クエリ Q、キー K、バリュー V である。これらは X に三つの学習済み重み行列をそれぞれ掛けて得られる。概念的には、クエリはそのトークンが何を探しているか、キーはそのトークンが何を提供できるか、バリューはそのトークンが持つ情報の中身を表す。
あるトークンがほかのトークンにどれだけ注意を向けるべきかを決めるために、クエリとキーの類似度スコアを計算する。トークン i について、そのクエリベクトル q_{i} と、系列内のすべてのトークンのキーベクトル k_{j} との内積をとる。これにより、各トークン j がトークン i にとってどれだけ関連が深いかを示すスコアのベクトルが得られる。
これらのスコアは、勾配を安定させるためにキーの次元の平方根で割ってスケールを調整し、そのうえでソフトマックス関数に通して正規化された注意の重みにする。ソフトマックスによって重みの合計は1になり、トークン全体にわたる確率分布として解釈できる。
次に、この注意の重みを使ってバリューベクトル v_{j} の加重和を計算する。その結果が、トークン i の新しい表現になる。つまり各トークンは、学習によって得られた文脈上の関連度に応じて重みを付けながら、系列全体から情報を集めるわけだ。この処理はすべてのトークンについて同時に行われ、文脈化された表現からなる新しい行列ができあがる。
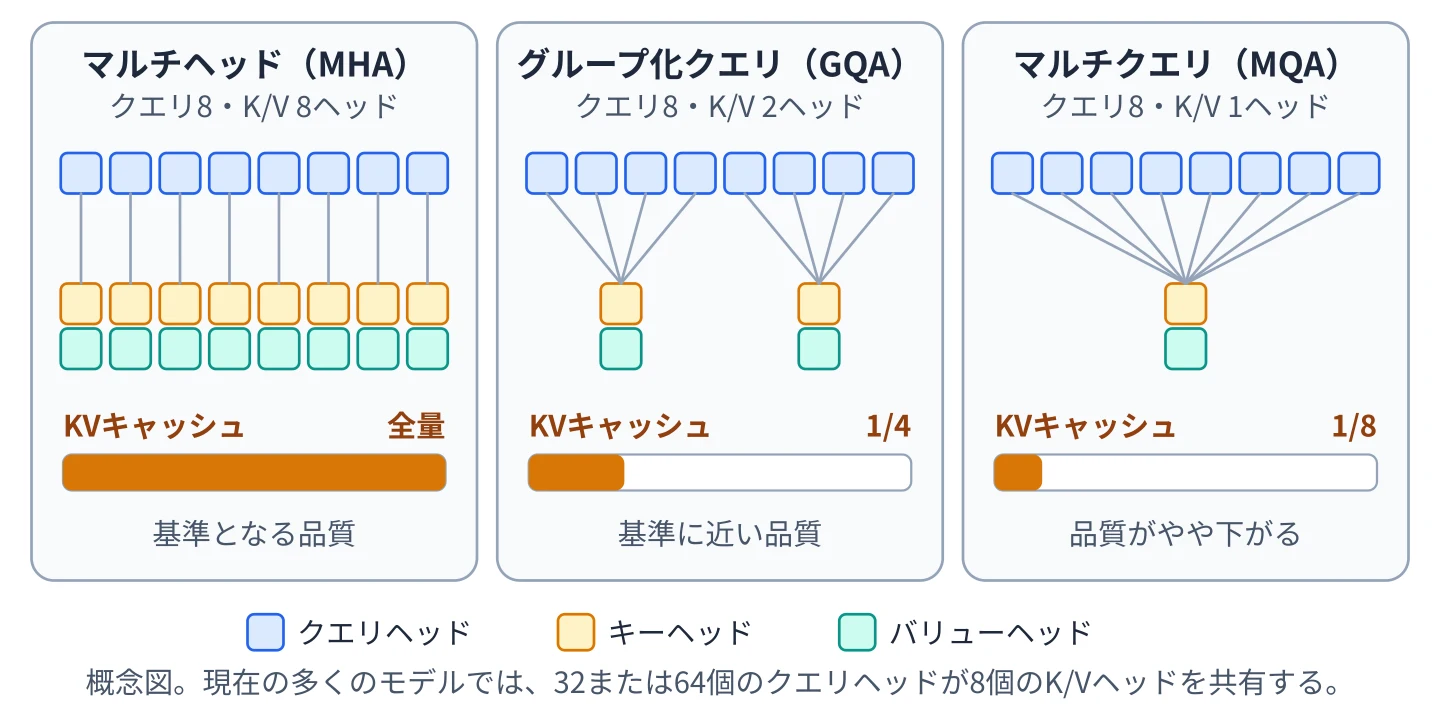
マルチヘッド注意は、この仕組みを拡張したものだ。学習される射影行列がそれぞれ異なる注意の計算を、複数並列に実行する。各ヘッドは異なる種類の関係を捉える。あるヘッドは構文構造に、別のヘッドは意味の類似性に、また別のヘッドは位置の依存関係に特化するといった具合である。すべてのヘッドの出力は連結され、さらに線形変換を通して注意サブレイヤーの最終的な出力になる。
現在のモデルの多くは、生成時のメモリを節約するためにこの構成に手を加えている。グループ化クエリ注意(grouped-query attention)では、各ヘッドが自分のクエリを持つ一方で、いくつかのヘッドからなるグループが一組のキーとバリューを共有する。生成時には過去のすべてのトークンのキーとバリューを保存しておく必要がある(KVキャッシュ)ため、それをヘッド間で共有すれば、品質をほとんど落とさずにキャッシュを数分の一に縮小できる。マルチクエリ注意は、その極端なケースで、すべてのヘッドが一組のキーとバリューを共有する。
重要な変種として、デコーダ専用モデルで使われるマスク付き自己注意がある。次トークン予測の学習中、モデルは未来のトークンを「見て」はならない。そこで因果マスクをかけ、トークン i が i 以下の位置にあるトークンにしか注意を向けられないようにする。これにより、生成に必要な自己回帰の性質が保たれる。
自己注意はなぜこれほど強力なのか。第一に、離れたトークン同士を直接結ぶ経路ができる。情報を一歩ずつ伝えていく再帰型ネットワークとは違い、注意機構は一つの層の中で任意の二つの位置を結びつける。第二に、予測ごとに文脈のどこに焦点を当てるかを動的に調整できる。ある単語がどれだけ関連するかは文脈によって変わり、注意の重みはその変化を反映する。第三に、並列化しやすい。あらゆるトークン対の相互作用を行列積として計算でき、現代のハードウェアとの相性がよい。
一方で、注意機構には計算コストがかかる。長さ n の系列に対して、注意機構は n×n の類似度スコア行列を計算しなければならない。この二乗のスケーリングは、非常に長い系列では高くつく。このコストを減らすための研究は数多い。FlashAttentionのように、結果はまったく同じまま計算の手順を組み替えて、スコア行列全体をメモリに保持しないようにする手法もあれば、各トークンが参照する範囲を局所的な窓に限ったり、線形時間で済む安価な層を混ぜたりする手法もある。それでも、表現の柔軟性の高さから、標準的な全体注意(full attention)は依然として主流であり、ほぼすべての大規模モデルが少なくとも一部の層でこれを使っている。
さらに深く:LLM Primer II — Language Models Through Mathematics(英語版)では、第4章「Attention: The Core Mechanism」で注意機構を完全に導出し、第5章と第6章で位置エンコーディングとTransformerブロックを扱っている。
とはいえ、自己注意だけでは順序を表せない。追加の情報がなければ、モデルは系列を順序のあるリストではなく、単なる集合として扱ってしまう。Transformerが系列の構造をどう保つのか。それが次に取り組む問いである。
リスト4.1 自己注意の中核部分。デコーダ専用モデルで使う因果マスクを含む。マルチヘッド注意では、独立に学習される射影を持つこの計算を複数並列に実行する。
# スケール化内積注意(1ヘッド分)
# Q, K, V: (batch, seq_len, d_k)
# mask: 1=注意してよい、0=未来の位置
scores = Q @ K.transpose(-2, -1) / math.sqrt(d_k)
if mask is not None:              # 因果マスク
    scores = scores.masked_fill(mask == 0, -math.inf)
weights = softmax(scores, dim=-1) # 各行の和は1
out = weights @ V                 # バリューを混合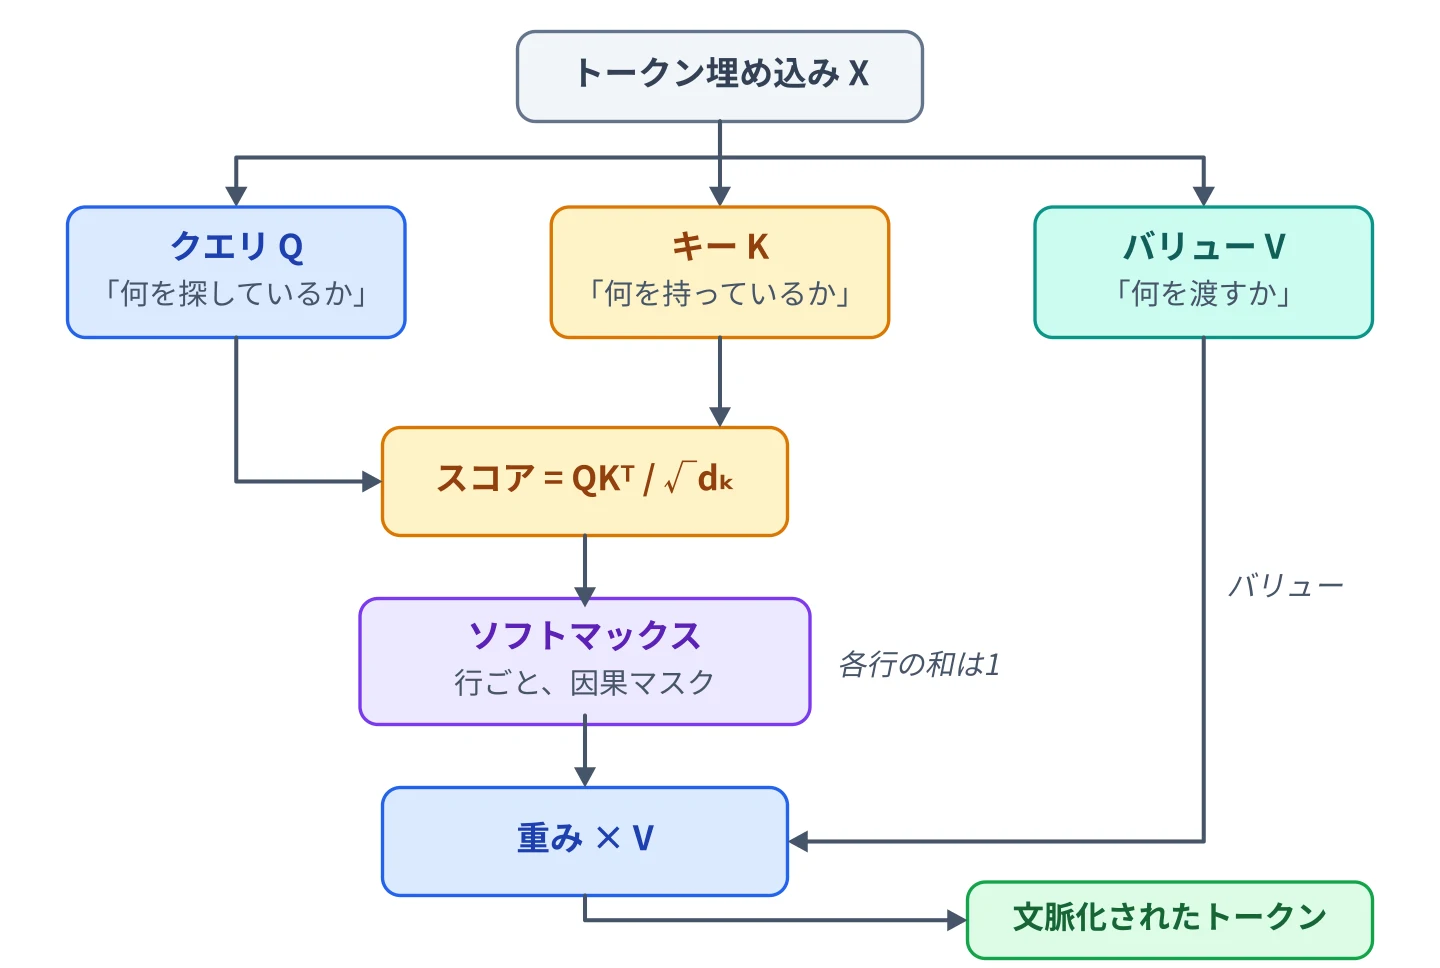
4.3 位置エンコーディング
自己注意によって、すべてのトークンがほかのすべてのトークンと相互作用できる。しかし自己注意そのものは順序に無関心だ。注意機構は、系列としての構造を本来持たないベクトルの集合に対して働く。そのため位置の情報を取り除くと、「犬 が 猫 を 追いかけた」と「を 追いかけた 猫 犬 が」のように単語を並べ替えた系列を区別できなくなる。しかし言語は本質的に順序を持ち、意味は位置に左右される。したがってTransformerには、入力の表現に順序を書き込む明示的な仕組みが必要になる。
かみくだいて言うと
自己注意は、それ単体では単語の順序を知らない。計算の上では、文は順序のない集合にすぎない。位置エンコーディングは、本のページに番号を振るように、各トークンにその位置を示すタグを付けることでこの問題を解決する。位置が加わると、モデルは「犬が人をかんだ」と「人が犬をかんだ」を区別できるようになる。
古典的な解決策は、トークンの位置についての情報を、最初の注意層に入る前の埋め込みに直接注入するものだ。トークン埋め込みができたあと、系列内での各トークンの位置に対応する位置ベクトルをそこに加算する。こうして合成されたベクトルは、意味の情報(トークン埋め込みに由来)と位置の情報(位置エンコーディングに由来)の両方を運ぶ。
pi主なアプローチは二つある。固定の位置エンコーディングと、学習される位置エンコーディングだ。元のTransformerの設計では、位置エンコーディングは周波数の異なる正弦関数を使って作られていた。各位置と各埋め込み次元について、スケールの異なる正弦波と余弦波で値を定めたのである。
piその背後にある直観は、こうした周期関数が位置を連続的かつ微分可能な形で表すので、モデルがトークン間の相対的な距離を推し量れるというものだ。この符号化は決定的に定まり、学習されないため、少なくとも原理的には、学習時に見たよりも長い系列にも一般化できる。
これに対して学習される位置エンコーディングは、位置ベクトルを学習中に最適化するパラメータとして扱う。最大コンテキストウィンドウ内の各位置が、それぞれ学習済みのベクトルを持つ。この方式なら、位置の表現をデータの分布に合わせて調整できる。初期のGPT系モデルは学習される絶対位置埋め込みを使っていたが、現在の大規模言語モデルの多くはRoPE(回転位置埋め込み)を使う。RoPEはすべての注意層の内部で、クエリとキーのベクトルを位置に応じた角度だけ回転させる。その結果、両者の内積はベクトルの加算ではなく、トークン間の相対距離によって決まるようになる。
位置情報はなぜそれほど重要なのか。文の中の依存関係を考えてみよう。英語では主語はふつう動詞の前に来る。節は別の節の中に入れ子になることがある。照応関係(何が何を指すか)は、近さに左右されることが多い。位置の手がかりがなければ、注意機構は意味の類似性は捉えられても、構造上の役割までは識別できない。位置エンコーディングは、注意機構が働くための空間的な足場を提供するのである。日本語でも事情は同じで、述語が文末に来る、修飾語が被修飾語の前に置かれるといった語順の規則が、文の構造を読み取る手がかりになっている。
もう一つの微妙な論点は、相対位置と絶対位置の違いである。絶対位置エンコーディングは、系列内の各インデックスに固有の表現を割り当てる。一方、相対位置エンコーディングは、トークンの絶対的な場所よりもトークン間の距離を重視する。言語に関する多くのタスクでは、絶対的なインデックスよりも相対的な距離のほうが多くを語る。たとえば、隣り合う二つの単語の関係は、それが文書の5番目にあるか105番目にあるかよりも重要なことが多い。現代のアーキテクチャは、長いコンテキストでの推論を改善するために、相対位置の仕組みを取り入れる傾向を強めている。
位置エンコーディングは、コンテキスト長の上限とも関わる。たとえば最大12万8000トークンのコンテキストウィンドウで学習したモデルの場合、位置の表現はその範囲内で最適化されている。学習時に見た長さを超えてコンテキストを延ばすには、性能の劣化を防ぐための慎重な調整が必要になる。位置補間や長さ外挿のスケジュールを組み合わせたRoPEなどの現代的な手法によって、長いコンテキストでの学習は以前よりはるかに扱いやすくなり、数十万から100万トークンのウィンドウも提供されるようになった。ただし、名目上の長さと実際に使える長さは同じではない。入力が長くなるにつれて、公称の上限よりずっと手前で精度が落ちていくことが、評価で繰り返し確認されている。そのため位置の設計は今も、長い文書を扱う能力や、予測地点から遠く離れた情報に確実に注意を向ける能力を直接左右している。
注意機構と位置の構造が整ったところで、これらの部品がタスクの要件に応じて、どのように異なるアーキテクチャの変種へと組み立てられるのかを見ていこう。次の4.4節「エンコーダ、デコーダ、デコーダ専用モデル」で取り上げる。
4.4 エンコーダ、デコーダ、デコーダ専用モデル
Transformerアーキテクチャは、もともと系列から系列への変換、とりわけ機械翻訳の文脈で登場した。当初の設計は、エンコーダとデコーダという二つの主要な部品からなっていた。しかしその後、それぞれ異なる目的に最適化されたアーキテクチャの変種が生まれた。エンコーダ専用、デコーダ専用、エンコーダ・デコーダ型の違いを理解すると、現代の大規模言語モデルがなぜデコーダ専用の構造を採ることが多いのかがはっきりする。
かみくだいて言うと
初期のTransformer研究からは三つの型が生まれた。テキストを読む「エンコーダ」、テキストを書く「デコーダ」、そしてその二つの組み合わせである。今日よく知られたLLMの大半はデコーダ専用で、プロンプトを読むのも続きを書くのも同じ仕組みで行う。エンコーダ専用モデルも、埋め込み、検索、分類などを中心に、表からは見えないところで今も広く使われている。
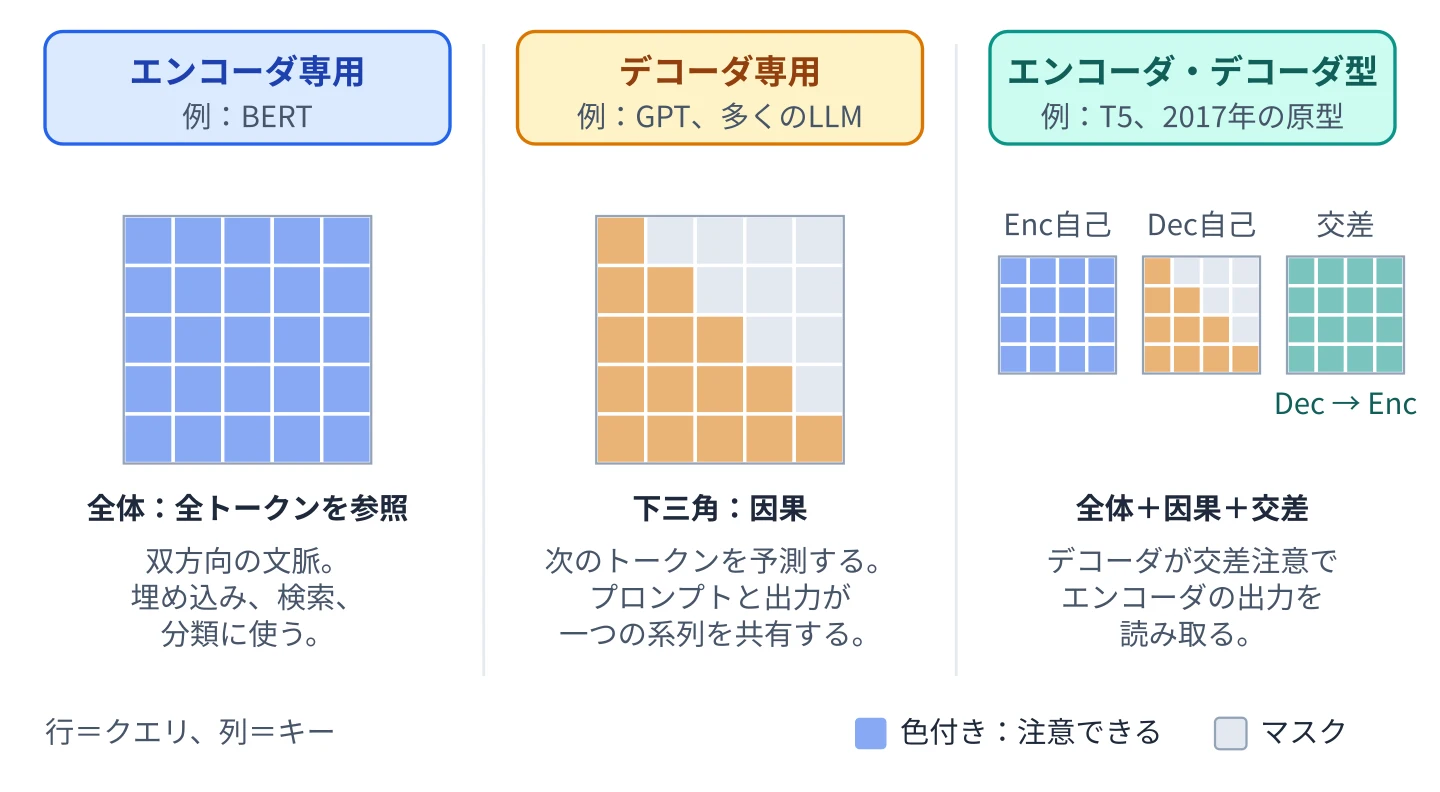
エンコーダは入力系列を処理し、各トークンについて文脈化された表現を作る。重要なのは、エンコーダの自己注意がふつう双方向だという点だ。つまり各トークンは、自分より前にあるトークンにも後ろにあるトークンにも、系列内のすべてに注意を向けられる。双方向の注意により、文脈全体を踏まえた表現を組み立てられる。
BERTなどのモデルはこの構造を使う。これらはマスク言語モデリングという目的で学習される。一部のトークンを隠し、双方向の文脈全体を使ってそれを予測させるのである。エンコーダ専用モデルは、分類、情報抽出、答えがコンテキスト内に含まれている質問応答など、入力テキストを深く理解する必要のあるタスクを得意とする。こうしたタスクでは生成モデルよりはるかに低いコストで動かせるため、より長いコンテキストウィンドウを備えた改良版のエンコーダが今も開発され続けている。検索システムで使われる埋め込みやリランキングの部品の多くも、こうしたモデルが担っている(第7章)。
これに対してデコーダは、自己回帰的な生成のために設計されている。その自己注意にはマスクがかけられ、各トークンはそれより前の位置にあるトークンにしか注意を向けられない。これにより、次トークン予測に必要な因果的な性質が保たれる。元のエンコーダ・デコーダ型Transformerでは、デコーダはクロス注意の層も備えている。この層によってデコーダ側のトークンがエンコーダの出力に注意を向けられるので、翻訳のように出力系列が別の入力系列に依存するタスクをこなせる。
エンコーダ・デコーダ型のアーキテクチャは、入力と出力の系列で構造や言語が異なるタスクに特に適している。エンコーダが元の系列の豊かな表現を作り、デコーダがその表現を条件として目的の系列を生成する。ただし、この構造は複雑さと計算コストを増やす。
デコーダ専用モデルは、独立したエンコーダをなくしてアーキテクチャを簡素化する。問題全体を「続きを書く」タスクとして扱うのである。プロンプトと生成テキストを一つの系列につなげ、モデルは次のトークンを自己回帰的に予測する。学習の目的(前のトークンから次のトークンを予測する)が生成の目的とそのまま一致するので、デコーダ専用モデルは大規模な言語モデリングと自然に噛み合う。現在の汎用の生成LLMのほぼすべてがこの構造を採用しているのは、効率よくスケールし、プロンプトを通じて多様なタスクに汎化できるからだ。
どのアーキテクチャを選ぶかは、トレードオフの反映である。エンコーダ専用モデルは強力な双方向の表現を持つが、本来は生成向きではない。エンコーダ・デコーダ型は構造のある変換をうまく扱えるが、より複雑になる。デコーダ専用モデルはアーキテクチャが単純で、生成タスクを統一的に学習できるため、大規模な運用に向いている。
アーキテクチャの変種が整理できたところで、中心的な問いが浮かぶ。これらのモデルはどのようにスケールするのか。そして、規模を大きくするとなぜ多くの場合に能力が向上するのか。これが次節のテーマである。
4.5 Transformerのスケーリング
Transformerアーキテクチャが言語を効果的にモデル化できると実証されると、進歩の軸は新たな方向、すなわち規模へと移った。研究者たちは顕著なパターンに気づいた。モデルの規模、データセットの規模、計算予算を連動させて増やしていくと、性能が予測可能な形で向上するのである。この経験的な規則性は、スケーリングの振る舞いとして知られるようになった。
かみくだいて言うと
スケーリングとは、ネットワークを大きくし、より多くのテキストを与え、より多くの計算資源で学習させることだ。ある範囲内では、この三つをそろって増やすと、モデルは滑らかかつ予測可能な形で良くなる。この分野がますます大規模な学習に巨額の資金を投じてきたのは、そのためである。
スケーリングにはいくつかの次元がある。最も目に見えやすいのはパラメータ数だ。層の数(深さ)、隠れ表現の大きさ(幅)、注意ヘッドの数を増やすと、モデルの表現能力が広がる。パラメータが多いほど、ネットワークはより複雑な関数を近似し、データ中のより微妙なパターンを捉えられる。しかし、データを増やさずにパラメータだけを増やすと、モデルは容量に比べて学習不足になり、計算資源を無駄にするうえ、極端な場合には過学習を招く。したがって、規模はバランスよく拡大しなければならない。
第二の次元はデータセットの規模である。大規模言語モデルは、書籍、記事、コードなど、さまざまなテキストにまたがる膨大なコーパスで学習される。データセットが大きくなるほど、モデルは言語のパターンや事実の結びつきをより幅広い分布で目にすることになり、汎化性能が高まる。ただし、より多くのデータで学習するには、より多くの計算と長い学習時間が必要になる。
第三の次元は計算資源である。大規模なTransformerの学習には、巨大な行列積を効率よく実行できるGPUやTPUなどの専用ハードウェアが必要だ。分散学習のフレームワークは、データとモデルのパラメータの両方を複数のデバイスに分割する。データ並列やモデル並列といった手法によって、大規模な環境で勾配を計算し、同期させることができる。こうしたエンジニアリング上の工夫がなければ、現代のLLMは計算の面で実現不可能だっただろう。
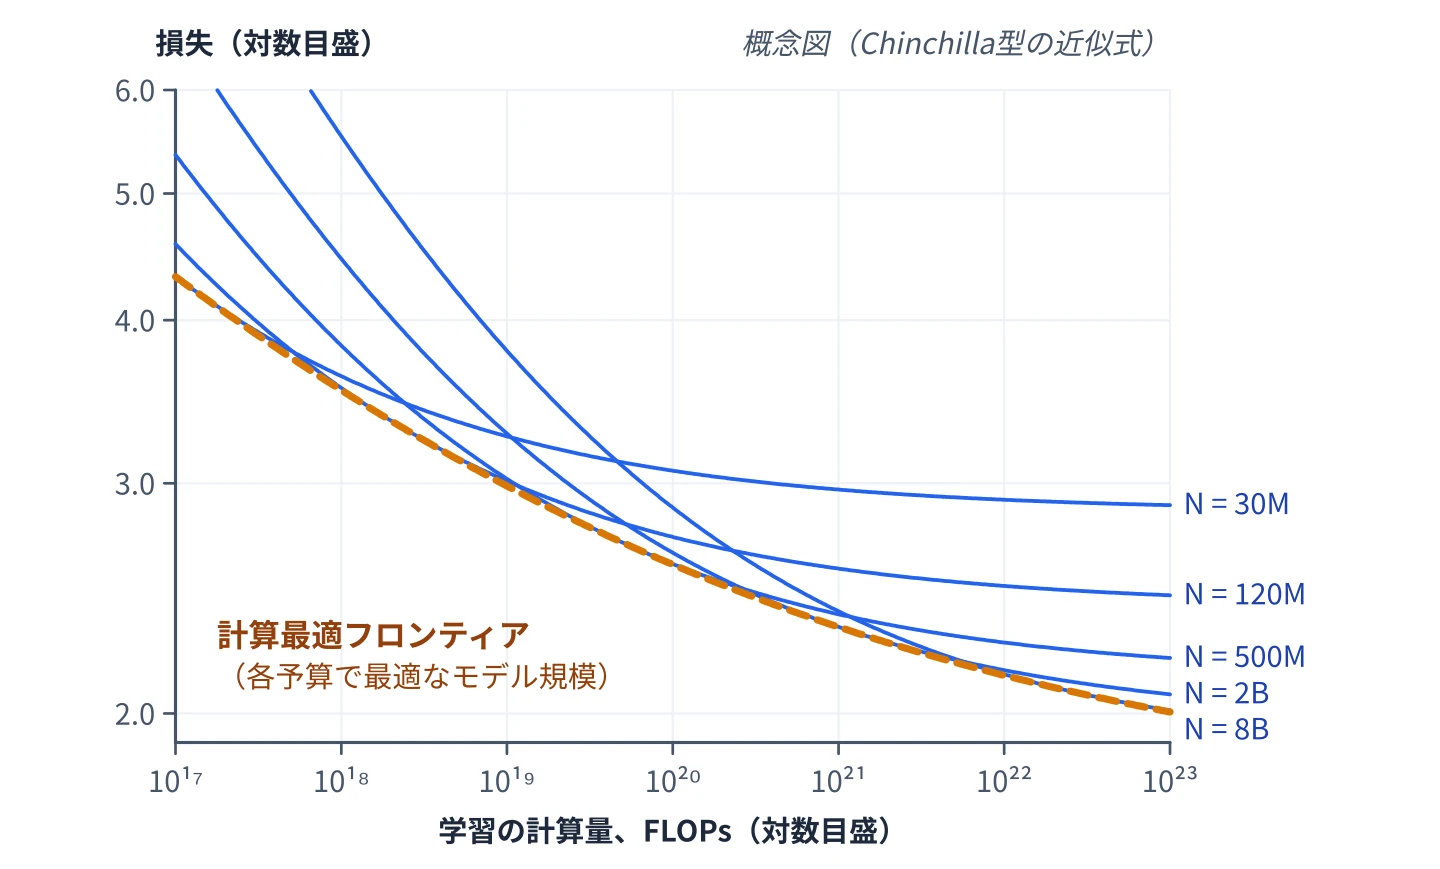
経験的に観察されたスケーリング則は、計算資源を適切に増やしさえすれば、モデルの規模とデータの規模を大きくするにつれて性能が滑らかに向上することを示している。損失は、規模に対しておおむねべき乗則に従って減少する。計算最適な学習に関する2022年の研究によれば、計算予算が一定なら、パラメータ数と学習トークン数はほぼ同じ比率で増やすべきで、その目安はパラメータあたり約20トークンである。実際には、最近のモデルの多くがこの比率よりはるかに多くのトークンで意図的に学習されている。小さめのモデルを長く学習させたほうが、何百万人ものユーザーに提供する際のコストが安く済むからだ。重要なのは、この向上が以前の直観で考えられていたよりも先まで続くことである。小規模では見られない能力も、パラメータが増えるにつれて突然ではなく徐々に現れてくることが多い。
とはいえ、スケーリングはただではない。大きなモデルほど多くのメモリとエネルギーを消費し、推論処理のレイテンシも増える。注意機構の二乗の計算量は、効率よく扱えるコンテキスト長を制約する。モデルが大きくなるにつれて、最適化も繊細になる。安定性を保つには、学習率のスケジュール、バッチサイズ、正則化の手法を慎重に調整しなければならない。スケーリングは安全性とアラインメントの課題も増幅する。能力の高いモデルほど、もっともらしいのに誤っている出力や有害な出力を生み出しうるからだ。
もう一つの重要な要素が、パラメータあたりの効率である。スパース注意、混合エキスパート(MoE)層、改良された正規化手法といったアーキテクチャ上の革新は、計算コストを比例的に増やすことなく能力を高めることを目指している。なかでも混合エキスパートは特に存在感を増している。フィードフォワードのサブレイヤーを多数の並列なエキスパートネットワークに置き換え、学習されたルーターが各トークンをそのうちのごく一部にだけ振り分ける仕組みだ。そのため、モデル全体では数千億、さらには1兆ものパラメータを持ちながら、個々のトークンに対して活性化するのはその数パーセントにとどまる、ということが起こりうる。これにより、全体の容量とトークンあたりの計算量が切り離される。2024年以降、公開情報のそろった最大級のモデルの多くがこの設計を採用している。こうした戦略は、純粋な規模の拡大とアーキテクチャの効率とのあいだに続く緊張関係を映し出している。
2024年以降、スケーリングのもう一つの軸が重要になってきた。推論時に費やす計算、すなわち推論時計算(test-time compute)である。回答の前に長い中間的な推論を生成するよう強化学習で訓練されたモデルでは、より長い思考過程の生成を許したり、複数の解答候補をサンプリングして比較させたりするほど、難しい問題での正答率が着実に向上する。こうしてスケーリングは今や、モデルの大きさや学習期間の長さだけでなく、一つひとつの問い合わせにどれだけの計算を費やすかにも関わるものになっている。
このようにスケーリングは、科学的な洞察であると同時に、エンジニアリング上の課題でもある。アーキテクチャの原理に十分なデータと計算資源を組み合わせれば、継続的な向上が得られることを示した。その一方で、コスト、レイテンシ、持続可能性、ガバナンスをめぐるトレードオフに、実務者は向き合わざるをえなくなっている。
ポイント:Transformerの性能は、パラメータ、データ、計算資源を連動させて増やすことで予測可能な形で向上する。しかしスケーリングは実際的な制約をもたらし、それが現実の運用のあり方を左右する。
アーキテクチャとスケーリングの原理を理解したところで、こうした巨大なモデルが実際にどう学習されるのかを見ていく準備が整った。データをどう準備するのか、分散システム全体で最適化をどう統率するのか、大規模な環境で安定性をどう保つのか。次は第5章「大規模モデルの学習」に進む。
ポチっとでの実践
どの文脈を渡すか
過去のレストラン検索を入れたままテニスコートを探すと、無関係な文脈が混ざります。直前の確認質問や選択中の予定だけを渡し、対象が決められない場合は確認へ戻す設計につながります。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る