 Pocchito
第5章 大規模モデルの学習
モデルの学習は、文章をたくさん集めて計算するだけではありません。何を集め、どう選別し、どのデータで結果を確かめるかが品質を左右します。
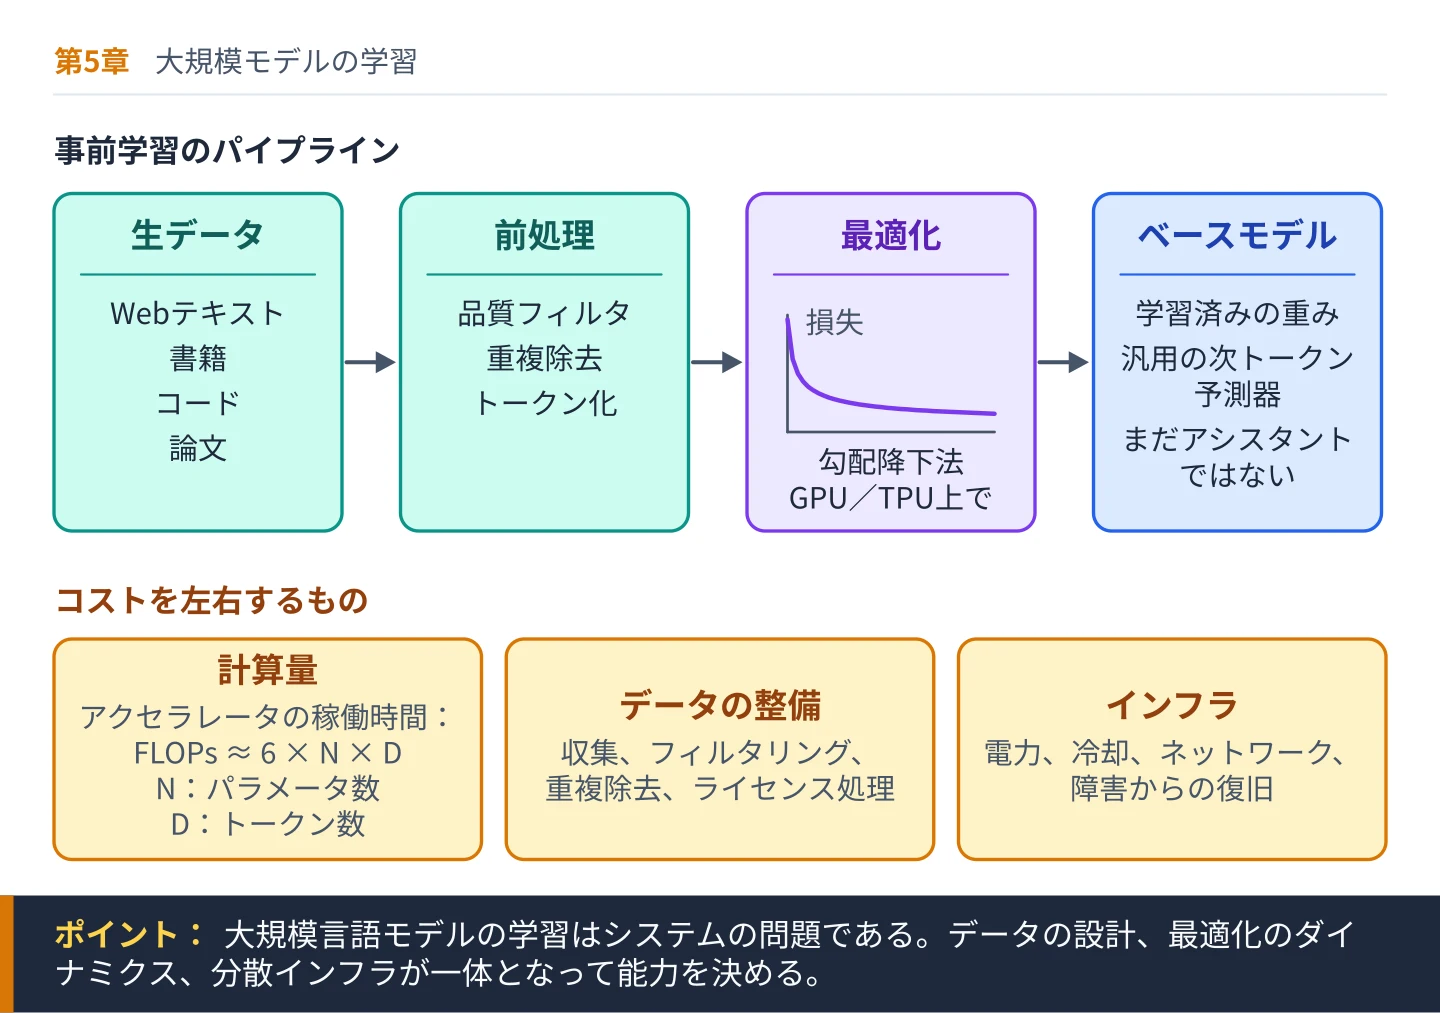
第4章では、Transformerのアーキテクチャを詳しく見た。自己注意、フィードフォワード層、残差接続、位置エンコーディングが組み合わさり、スケールできる構造をなすことを確認した。しかし、アーキテクチャだけでは能力は生まれない。パラメータがランダムなままのTransformerは、数式でできた抜け殻にすぎない。それを大規模言語モデルに変えるのが学習である。
本章では、大規模モデルが実際にどう学習されるのかを見ていく。話の軸はアーキテクチャの設計から、数十億、さらには数兆のパラメータをもつシステムを構築する現場の実情へと移る。学習は単一のアルゴリズム的な手順ではない。生のデータから始まり、多様な領域にわたって、較正された確率でトークンを予測できるモデルに至るまでのパイプラインである。その各段階が、モデルの挙動、信頼性、性能を左右する。
5.1節「データ収集と選別」では、学習コーパスがどのように組み立てられるかを扱う。現代のLLMは、Webテキスト、書籍、コードリポジトリ、学術文献、整備済みのデータセットなど、性質の異なる多様なソースから学ぶ。データセットの構成、重複除去、ドメインのバランス、フィルタリングの判断が、モデルが最終的に何を学ぶかをどう形作るのかを分析する。
5.2節「前処理とデータ品質」では、生のテキストを学習用にクリーニングし、正規化し、トークン化し、分割し、整形する工程に焦点を当てる。前処理の選択が最適化の安定性、トークン分布、下流タスクの性能に影響する理由を論じる。データ品質は抽象的な関心事ではなく、学習の進み方そのものに直接効いてくる。
5.3節「損失関数と勾配降下法」では、学習の数学的な核心に立ち返る。交差エントロピー損失が次トークン予測をどう定式化するのか、誤差逆伝播法で勾配がどう計算されるのか、そして最適化アルゴリズムが数十億のパラメータをどう効率よく調整するのかを説明する。
5.4節「ハードウェアと分散学習」では、現代のLLM開発が要求するエンジニアリングの規模を扱う。大規模モデルの学習には、専用のアクセラレータ、分散システム、メモリ管理の工夫が欠かせない。データ並列、モデル並列、混合精度学習によって、大規模な最適化がどのように現実のものになるのかを見ていく。
5.5節「過学習、未学習、正則化」では、汎化を取り上げる。モデルが学習データを細かく覚えすぎたり、逆に十分に学べなかったりする仕組みと、大規模な環境で正則化が表現力と頑健性のバランスをどう取るのかを論じる。
まずは出発点であるデータそのものから始めよう。
5.1 データ収集と選別
アーキテクチャが、モデルが原理的に何を学べるかを決めるとすれば、実際に何を学ぶかを決めるのはデータである。大規模言語モデルを形作るのは、明示的なプログラミングよりも、どんなテキストに触れたかだ。学習に使われたテキストの分布が、そのままモデルが内に取り込むパターンの分布になる。したがって、データの収集と選別は周辺的な作業ではなく、設計の中心にある判断である。
かみくだいて言うと
学習は、書籍、Webサイト、コードリポジトリなど多くのソースから、数兆語にもなる膨大なテキストを集めるところから始まる。そのテキストの質と配合が、完成したモデルにできることを大きく左右する。「ゴミを入れればゴミが出てくる」はまさにそのとおりで、丁寧な選別が作業の大きな部分を占める。
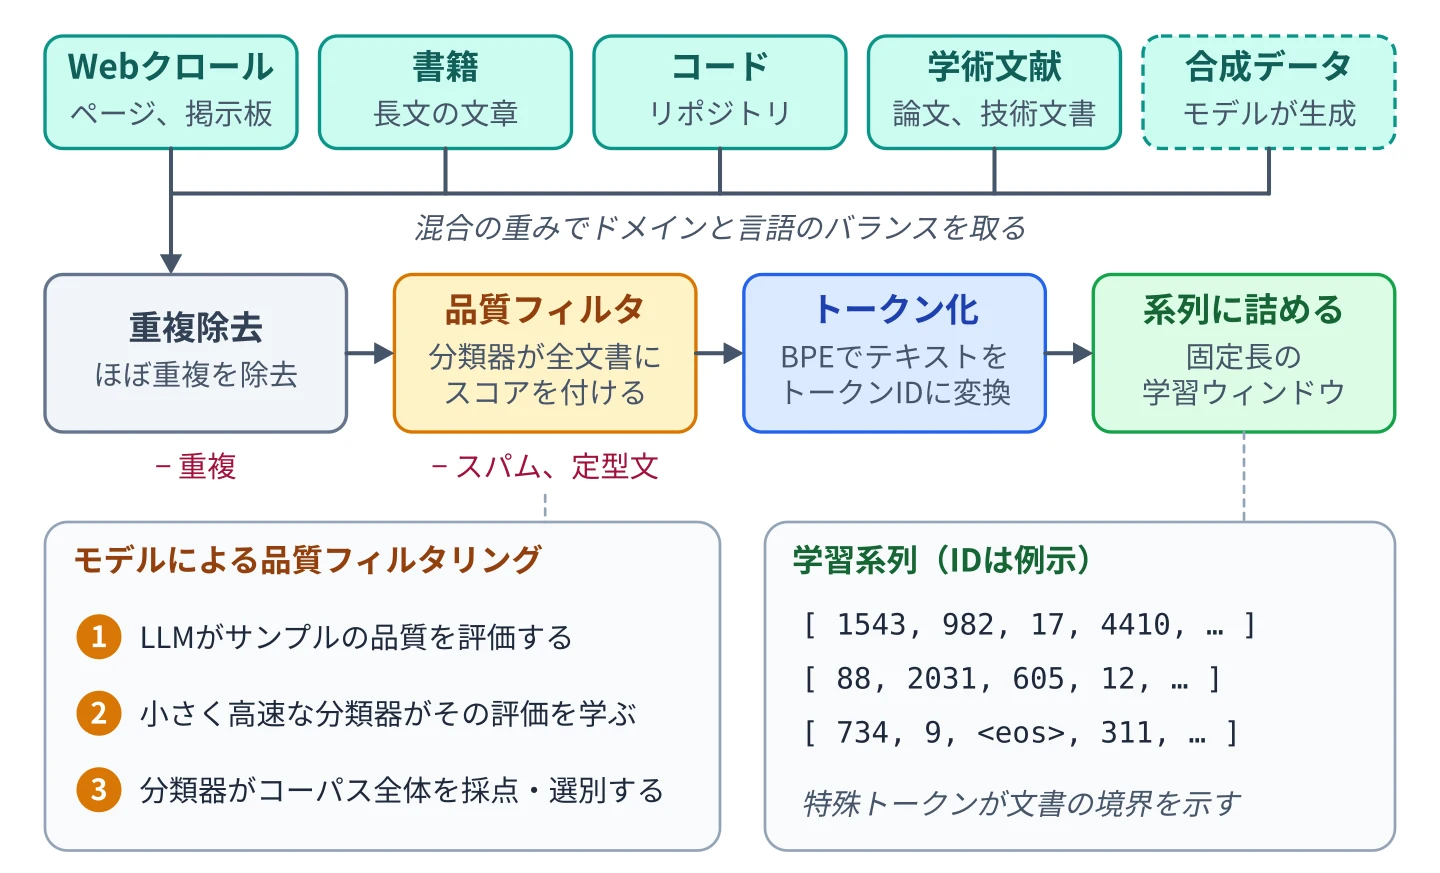
現代のLLMは、単一の巨大なソースではなく、複数のデータセットを混ぜ合わせたもので学習する。混合には、Webクロール、書籍、学術論文、コードリポジトリ、技術文書、対話データなどが含まれる。さらに最近では、例題の解答や説明の言い換えといった狙いを絞った事例を補うために、他のモデルが生成した合成テキストも増えている。ソースごとに言語的な性格は異なる。Webテキストは幅広いが、品質にばらつきがある。書籍は長文の構成と物語の一貫性をもたらす。コードは構文の規則性と論理の厳密さを、学術文献は形式的な推論と専門用語をもたらす。この混合の構成が、下流での能力を直接左右する。
規模だけでは十分ではない。大量のテキストをただ収集するだけでは、冗長な内容、ノイズ、低品質なコンテンツが入り込む。たとえばWebデータには、重複したページ、スパム、定型文(ボイラープレート)、機械生成の残骸が多く含まれる。重複除去とフィルタリングを行わなければ、モデルは繰り返し現れるパターンを不釣り合いに記憶してしまう。重複除去の手法はほぼ同一の文書を取り除き、実質的なデータの多様性を高めるとともに、特定の言い回しへの過学習を抑える。
選別には、ドメインと言語のバランスを取ることも含まれる。ある一つのドメインがコーパスの大半を占めると、モデルはその文体や語彙を過剰に反映しかねない。たとえば技術系フォーラムに大きく偏ったデータセットで学習すると、生成される文章は技術的な口調に寄っていく。多言語のバランスを取るには、比率を考えたサンプリングを慎重に設計する必要がある。同じ言語の中でも文体の違いは重要だ。対話、物語、手順の説明、公式な報告書は、それぞれ異なる構造のパターンを教える。
有害なコンテンツや低品質なコンテンツも重要な課題である。フィルタリングの仕組みは、露骨な暴言、誤情報、危険な指示を含むテキストを取り除くことを目指す。ただし、フィルタリングを強めすぎると、そうした話題を文脈の中で正当に論じたテキストまで失われる。課題は単なる削除ではなく、きめ細かな分類にある。文書をコーパスに含める前に、自動分類器でスコアを付けることが多い。近年よく使われる手法では、大規模言語モデルに文書のサンプルを品質や教育的価値の観点で評価させ、その評価をもとに小さく高速な分類器を学習して、コーパス全体をフィルタリングする。特に影響の大きいデータセットでは、自動化されたパイプラインを人手のレビューで補うこともある。
ライセンスと出所も、実務上の検討事項である。モデルの商業的な重要性が増すにつれ、学習データが合法的に取得され、適切なライセンスの下にあることを確かめる作業は欠かせなくなっている。技術的な選別と並行して、データガバナンスの枠組みも整いつつある。たとえば欧州連合(EU)では、2025年8月以降、汎用AIモデルの提供者に対して、学習に使用したコンテンツの概要を公表し、著作権法を遵守するための方針を定めることが義務づけられている。日本では、著作権法第30条の4(2018年改正で導入)により、情報解析のように著作物の表現を享受することを目的としない利用は原則として著作権者の許諾なく行えるが、著作権者の利益を不当に害する場合は例外とされており、生成AIの学習への当てはめについては文化庁の文化審議会著作権分科会法制度小委員会が2024年3月に「AIと著作権に関する考え方について」を取りまとめている。
見落とされがちだが重要な要素に、サンプリング戦略がある。学習中、文書は複数のソースから確率的に混ぜて取り出されることが多い。各ソースに割り当てるサンプリングの重みが、学習の進み方に影響する。たとえば、丁寧に整備された高品質のデータセットは、生のWebテキストよりも多めにサンプリング(オーバーサンプリング)されることがある。カリキュラム戦略では、最適化を安定させたりアラインメントを改善したりするために、学習の段階ごとにサンプリングを調整する。よく行われるのは、事前学習の最後に短い「アニーリング」段階を設け、学習率をゼロに向けて減衰させながら、混合を最高品質のソースに寄せていくやり方である。
文書レベルでデータの収集と選別が済んだら、次にそれを大規模な最適化に適した、構造化された学習系列に変換する必要がある。
5.2 前処理とデータ品質
データを大まかに収集・選別したあとは、それを学習に適した形に変換しなければならない。この段階が前処理であり、ここで生のテキストは、モデルの目的に沿った構造化された学習系列になる。アーキテクチャに比べて注目されることは少ないが、前処理はモデルの安定性、効率、下流での挙動に大きな影響を与えうる。
かみくだいて言うと
学習を始める前に、テキストはクリーニングされる。重複を取り除き、明らかに低品質なものを除外し、すべてをトークンに変換する。地味な工程だが、データを1周するごとにモデルが実際にどれだけの情報を得られるかは、ここで決まる。
最初の手順は正規化である。多様なソースから集めたテキストには、文字コードの不統一、書式の残骸、HTMLの断片、不規則な空白が含まれる。正規化によって、文字の符号化を統一し、マークアップを除去または標準化し、書式が人工的なトークンのパターンを生まないようにする。小さな不統一であっても、トークン分布を変え、学習効率を落とすことがある。
続いてトークン化を行う。選んだトークナイザが、正規化済みのテキストをトークンIDの系列に変換する。モデルは固定長のコンテキストウィンドウの中で動作するため、長い文書は指定した最大長のチャンクに分割される。この分割の扱いが重要になる。テキストを機械的に切ると、意味のつながりが途切れる。境界をまたいで文脈を保つために、重なりをもたせたスライディングウィンドウを使うパイプラインもあれば、文書の切り替わりを示す特殊トークンを挿入するパイプラインもある。こうした設計上の判断は、モデルが談話の構造をどう学ぶかに微妙な影響を与える。
前処理の段階では、系列レベルでの重複除去をあらためて行うことが多い。キュレーションの段階で文書単位の重複除去をしていても、似た断片は残りうる。ほぼ重複した系列を取り除けば、モデルが繰り返し現れるパターンに過大な重みを置くことを防ぎ、汎化が向上する。実質的なデータセットの大きさは、生のトークン数だけでは測れない。測るべきは、重複のない情報の量である。
データ品質のフィルタリングもこの段階で続く。自動分類器がテキストの断片に品質スコアを付け、読みやすさや一貫性のしきい値に届かないものを除外することがある。言語識別モデルを組み込み、テキストが意図した言語の分布に合っているかを確かめるパイプラインもある。フィルタリングはトレードオフである。厳しく除外すれば平均的な品質は上がるが多様性は下がり、緩くすれば網羅性は上がるがノイズが混じりやすくなる。
学習目的に合わせた整形も欠かせない。大規模言語モデルは自己回帰的に学習するので、各トークンをそれより前の文脈から予測する形にテキストを並べる必要がある。境界や構造を示す目印として、特殊トークンを挿入することもある。指示チューニングのパイプラインでは、プロンプトと応答を明示的に整形し、対話の構造をモデルに教える。
データを混合する戦略は、前処理の段階でも続くことが多い。データセットをまたいだ重み付きサンプリングによって、品質の高いソースやドメイン上重要なソースが、相対的に多くの学習事例を供給するようにする。学習の手順によってはカリキュラム戦略を採り、まず単純なデータや高品質なデータを与えて学習を安定させてから、ノイズの多いコーパスを加えていく。
品質は、モデルの挙動だけでなく、最適化の進み方にも影響する。ノイズが多く一貫性に欠けるデータは勾配の分散を大きくし、収束を遅らせ、学習を不安定にするおそれがある。きれいなデータほど、損失曲線は滑らかになり、学習も速く進む傾向がある。ただし、フィルタリングしすぎると分布が狭くなりすぎ、汎化が損なわれる。よい前処理は、多様性と一貫性のバランスを取る。
データが最適化に使えるトークン系列の形に整ったところで、モデルがそこから数学的にどう学ぶのかを見ていこう。次節の5.3節「損失関数と勾配降下法」で扱う。
5.3 損失関数と勾配降下法
データがトークン化された系列として準備できれば、学習の目的ははっきりする。すべての位置で正しい次トークンに高い確率を割り当てるように、モデルのパラメータを調整することだ。この目的を定式化するのが損失関数であり、その損失を最小化する過程を動かすのが勾配降下法である。
かみくだいて言うと
モデルは最初、ほとんどでたらめに推測する。損失関数は、それぞれの推測がどれだけ外れていたかを測る。勾配降下法は、もう少し外れの小さい推測になる方向へ、内部のつまみをほんの少しずつ動かす手順である。これを何十億回も繰り返すことで、ランダムな設定が使えるモデルに変わる。
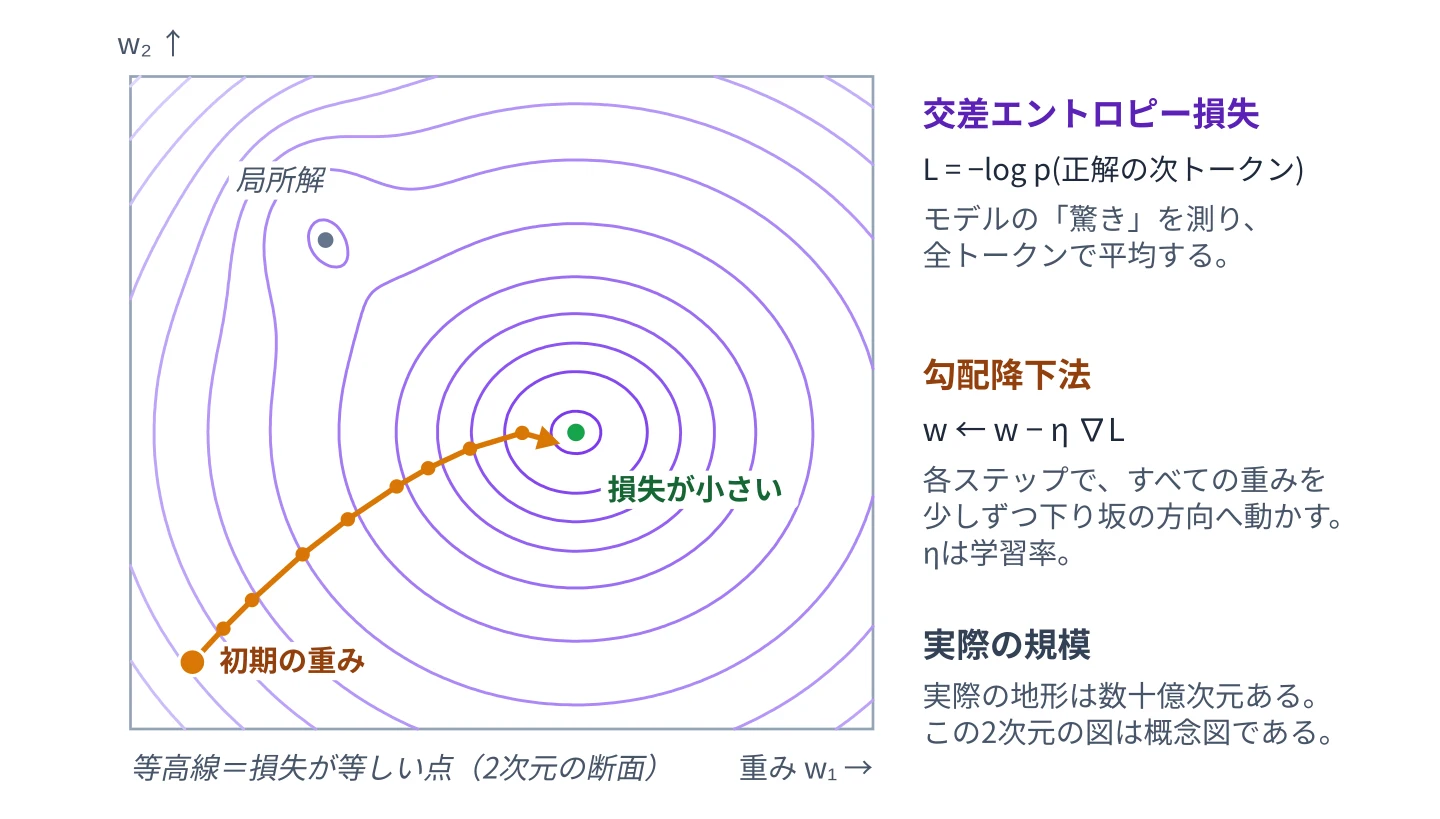
言語モデリングでもっとも一般的な損失関数は、交差エントロピー損失である。系列の各位置で、モデルは語彙全体にわたる確率分布を出力する。正解の次トークンをワンホットベクトル、つまり正解のトークンだけが確率1で、それ以外はすべて0のベクトルで表すとしよう。交差エントロピーは、この真の分布と予測された分布の違いを測る。正解のトークンに高い確率を割り当てていれば損失は小さく、低い確率しか割り当てていなければ損失は大きい。
直観的に言えば、交差エントロピーは「驚き」に罰を与える。モデルが「自信をもって正解」していれば損失は下がり、「自信をもって外す」と損失は急激に大きくなる。したがって学習とは、トークン系列を繰り返し与え、データセット全体での平均的な驚きが小さくなるようにパラメータを調整していくことである。
パラメータを更新するには、各パラメータについての損失の勾配を計算する。勾配は、あるパラメータを少しだけ変えたときに損失がどれだけ変わるかを表す。誤差逆伝播法は、微積分の連鎖律を出力側から入力側へ層ごとに適用して、この勾配を効率よく計算する。大規模言語モデルでは、学習データのミニバッチごとに、この計算が数十億のパラメータにわたって行われる。
データセット全体の勾配を一度に計算するのは計算量の面で現実的ではない。そこで学習では、確率的勾配降下法(SGD)やその変種を使う。データセットをミニバッチに分け、ミニバッチごとに勾配を計算し、パラメータを少しずつ更新していく。これによって最適化の過程にノイズが入るが、そのノイズが浅い局所解から抜け出す助けとなり、汎化を改善することもある。
現代の大規模学習で素のSGDが使われることはまれである。一般的なのは、AdamやAdamWといった適応的オプティマイザだ。これらは勾配の統計量を逐次推定し、パラメータごとに個別に学習率を調整する。そのため、特に深いアーキテクチャで、収束が速く更新も安定する。学習率スケジュールも学習を改善する。学習率を徐々に上げていくウォームアップ段階から始め、その後、時間とともに減衰させることが多い。デフォルトは今もAdamWだが、重み行列を独立した数値の集まりではなく一つの行列として扱う新しいオプティマイザ、たとえばMuonも、1兆パラメータ規模のいくつかの学習で成果を上げている。
バッチサイズの選択も最適化と関係する。バッチサイズを大きくすると勾配の推定は安定するが、必要なメモリが増え、スケールのさせ方を誤ると汎化が損なわれることもある。経験的なスケーリング則によれば、モデルサイズが大きくなるにつれて、効率的な学習を保つためにバッチサイズと学習率を再調整する必要がある。典型的には、バッチを大きくし、ピーク時の学習率を小さくする。
もう一つ重要な概念が勾配クリッピングである。非常に深いネットワークでは、勾配がときに極端に大きくなり、更新が不安定になることがある。クリッピングは勾配の大きさに上限を設け、学習中の安定性を保つ。
損失の定式化、勾配の計算、オプティマイザの選択、スケジューリング、安定化の技法。これらすべてが組み合わさって、モデルがどれだけ効率よく、確実に学習するかが決まる。最適化は単なる機械的な処理ではない。膨大なパラメータ空間の上で動く、細かく調整された動的なシステムである。
アルゴリズムの水準で最適化を理解したところで、大規模な学習の現実に目を向ける準備が整った。次節の5.4節「ハードウェアと分散学習」では、このような最適化を実現するために必要なインフラを取り上げる。
5.4 ハードウェアと分散学習
現代の大規模言語モデルの学習は、単なる数学の問題ではなく、大規模なシステムエンジニアリングの問題である。数十億のパラメータをもつモデルは1台のデバイスには容易に収まらない。仮に収まったとしても、学習には非現実的なほど長い時間がかかる。そのため、ハードウェアと分散学習の戦略が、LLMを実現するうえで中心的な役割を担う。
かみくだいて言うと
現代のLLMは、1台のコンピュータでは学習できない。データセンター内で相互に接続された多数の専用チップ、ときには数千個ものチップに分割して学習させる。その複雑さは計算だけの話ではなく、産業規模の話でもある。電力、冷却、ネットワーク、スケジューリングのすべてが、第一級のエンジニアリング課題になる。
Transformerの学習の中核にあるのは行列積である。注意層、フィードフォワードネットワーク、射影層はいずれも、密な線形代数の計算に大きく依存している。GPU(Graphics Processing Unit)やTPU(Tensor Processing Unit)は、まさにこの種の計算向けに最適化されている。数千もの浮動小数点演算を並列に同時実行できるため、汎用のCPUに比べて計算を大幅に高速化できる。
とはいえ、高性能なGPUでも1台あたりのメモリには限りがある。数百億から数千億のパラメータをもつモデルは、1台のデバイスにすべて載せることができない。そこで学習を多数のデバイスに分散させる。計算を分散させる戦略はいくつかあり、それぞれにトレードオフがある。
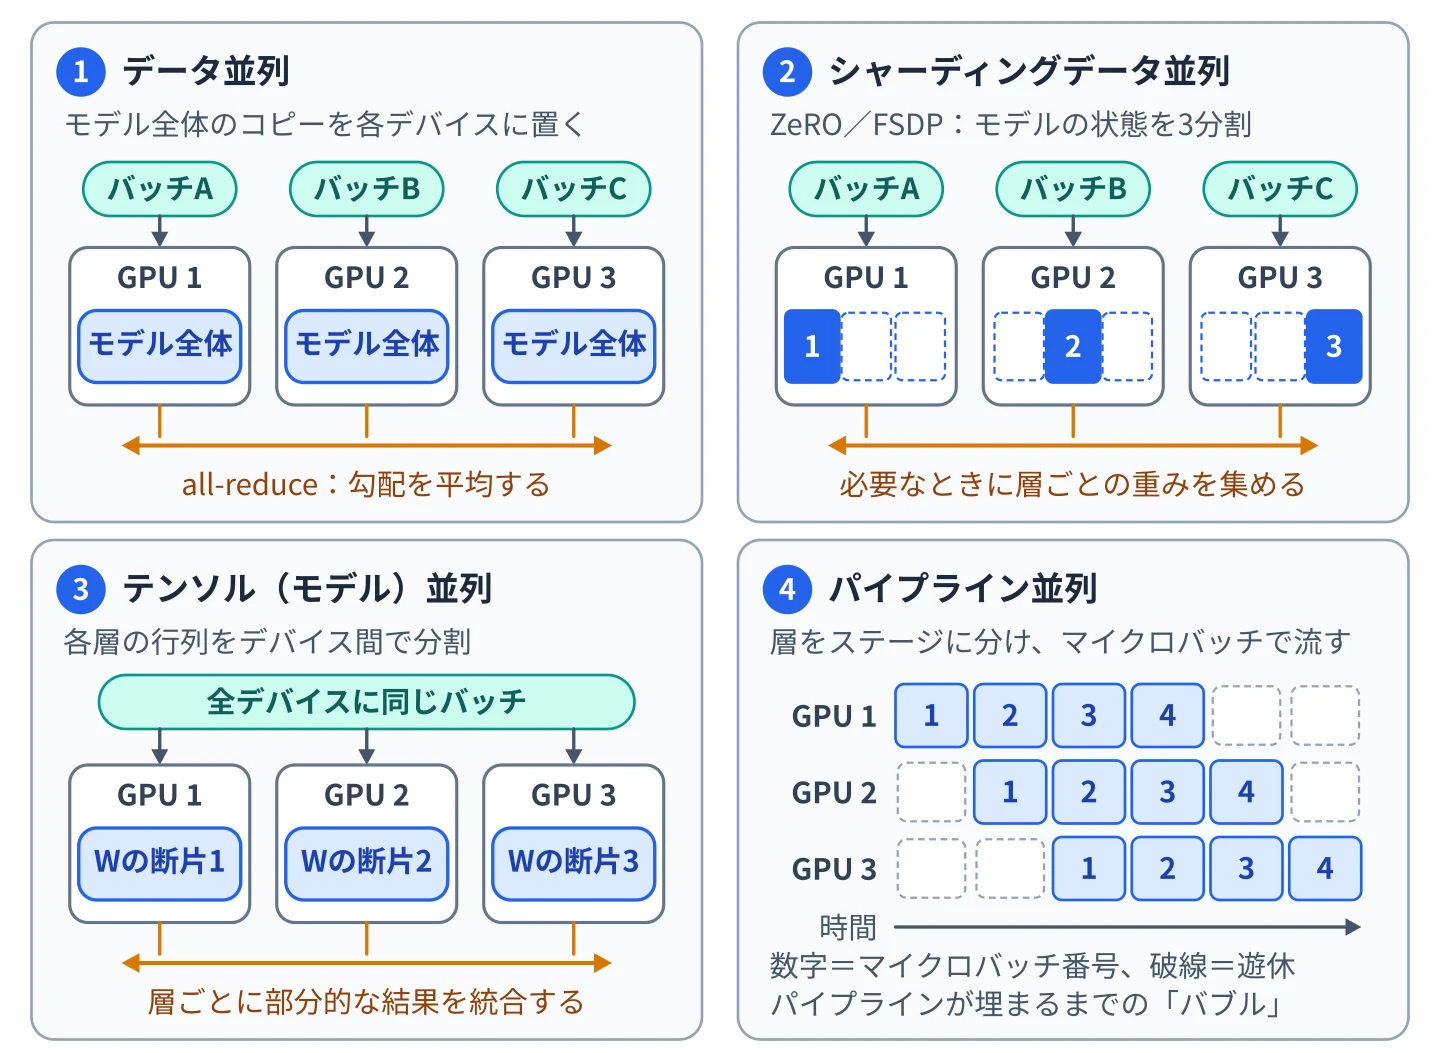
データ並列は概念的には単純である。各デバイスがモデルの完全なコピーを保持し、異なるミニバッチを別々のデバイスで並列に処理する。順伝播と逆伝播のたびにデバイス間で勾配を同期し、すべてのデバイスでパラメータを同じように更新する。モデルがメモリに収まる場合にはよくスケールするが、デバイス数が増えるにつれて通信のオーバーヘッドが大きくなる。
広く使われている改良版では、各デバイスがモデルの完全なコピーをもつ必要がなくなる。シャーディングデータ並列では、パラメータ、勾配、オプティマイザの状態をデバイス間で分割して保持し、各デバイスはある層を計算するときにだけ必要な部分を集めてくる。ZeROやPyTorchのFully Sharded Data Parallel(FSDP)といったシステムがこの方式を実装している。デバイスあたりのメモリはデバイス数にほぼ反比例して減るが、その代わりに通信が増える。
モデル並列は、モデルそのものを複数のデバイスに分散させる。パラメータを複製する代わりに、異なる層、あるいは層を分割した部分を別々のデバイスに配置する。順伝播と逆伝播では、中間の活性値がデバイス間を移動する。これにより1台のGPUに収まらないほど大きなモデルも学習できるが、通信はさらに複雑になる。
パイプライン並列は、データ並列のバッチ処理の考え方を取り入れたモデル並列の一形態である。モデルを連続する層からなるステージに分け、各ステージを1台または一群のデバイスに割り当てる。各ミニバッチをさらに小さなマイクロバッチに分け、時間をずらしてパイプラインに流すことで、異なるステージが同時に別々のマイクロバッチを処理し、ハードウェアの稼働率を高く保つ。この方式は遊休時間を減らすが、ボトルネックを避けるための慎重なスケジューリングが必要になる。
実際の大規模学習では、これらの戦略を組み合わせることが多い。組み合わせることで、数千から数万台のアクセラレータにまで学習をスケールさせられる。大規模な学習では、個々の行列演算をデバイス間で分割する(テンソル並列)、層をパイプラインのステージに分ける、長い系列をいくつかの区間に分ける(コンテキスト並列)、混合エキスパート層をエキスパートごとに分ける、データを複数のレプリカに分ける、といった分割を同時に行うこともある。勾配を同期し中間データを効率よくやり取りするには、NVLinkや専用のネットワークファブリックといった高帯域の相互接続が欠かせない。
もう一つの重要な検討事項がメモリ管理である。混合精度学習などの技法では、一部のテンソルを低精度の形式(たとえば32ビットではなく16ビットの浮動小数点数)で表してメモリ使用量を減らす。これによりメモリの占有量が減ってスループットが上がり、多くの場合モデルの品質も損なわれない。学習用の標準的な16ビット形式はbfloat16で、32ビット浮動小数点数と同じ数値範囲を保つ。最近の大規模な学習の中には、行列積の大半を8ビット浮動小数点で行うものもあり、最新のアクセラレータが対応する4ビットの学習形式も大規模な学習で実証されている。勾配チェックポイントは、一部の中間活性値を保存せずに逆伝播の際に再計算することで、メモリ消費をさらに減らす。
耐障害性もきわめて重要である。長い学習は数週間から数か月に及び、数万台のデバイスという規模では、ハードウェアの故障は例外ではなく日常的に起こる。公開されたある54日間の学習では、予期しない中断が400回以上、およそ3時間に1回の割合で記録された。チェックポイントの仕組みでモデルの状態を定期的に保存しておけば、ハードウェアの故障後にも学習を再開できる。分散学習フレームワークは、これらの処理を調整してデバイス間の整合性を保つ。
ハードウェアの選択は、アーキテクチャの判断にも影響する。たとえば、注意機構の計算コストが系列長の2乗で増えることは、系列が長くなるほど大きな問題になる。こうしたエンジニアリング上の制約が、メモリ効率のよい注意機構の変種やスパース化の技法の研究を後押しすることも多い。
インフラとスケールの問題を見たところで、次に、学習したモデルがどれだけうまく汎化するかを考えなければならない。データと計算資源が十分にあっても、モデルは学習データを細かく覚えすぎることもあれば、十分な構造をつかめないこともある。次は5.5節「過学習、未学習、正則化」に進む。
5.5 過学習、未学習、正則化
大規模なデータセットと強力なハードウェアがあっても、大規模言語モデルの学習には繊細なバランスが求められる。モデルはデータから学ぶ量が少なすぎることもあれば、誤った形で学びすぎることもある。この両極端を未学習と過学習と呼ぶ。信頼できるシステムを作るには、この二つを理解しておくことが欠かせない。
かみくだいて言うと
過学習とは、モデルが根底にあるパターンを学ぶ代わりに、学習データの事例そのものを覚えてしまうことである。未学習とは、役に立つほど十分に学べていないことである。学習はこの二つの間でバランスを取る作業であり、丸暗記ではなく本当の学習へと結果を導くために、いくつかの標準的な技法(まとめて正則化と呼ばれる)が使われる。
未学習は、データの構造をとらえるのに十分な表現力や学習量がモデルに欠けているときに起こる。この場合、学習損失も検証損失も高いままになる。根底にあるパターンを十分に表現できないため、モデルは予測の不確かさを減らせない。原因としては、モデルが小さすぎる、学習時間が足りない、最適化の設定が悪い、正則化が強すぎる、などが挙げられる。実際には、未学習は平板でありきたりな出力や、文脈を踏まえた推論の弱さとして現れる。
これに対して過学習は、モデルが学習データを具体的に学びすぎたときに起こる。学習損失はとても低くなるが、未知のデータで測る検証損失は高いまま、あるいは上がり始める。モデルは汎化する代わりにパターンを丸暗記している。言語モデルでは、小さなデータセットの場合ほど過学習ははっきり現れないことがある。大規模なコーパスにはきわめて大きな多様性があるからだ。それでも、データの重複、狭いドメインへの偏り、不十分な正則化があれば、記憶による影響は生じうる。
目指すのは汎化である。モデルは、学習に使った系列だけでなく、未知の新しいテキストに対してもうまく機能しなければならない。正則化の技法は、このバランスを保つ助けになる。たとえば重み減衰は、パラメータの値が大きくなりすぎることに罰則を課し、複雑すぎる解を避けさせる。ドロップアウトは、学習中にネットワークの一部をランダムに無効化し、特徴どうしが互いに依存しすぎるのを防いで、表現に冗長性をもたせる。学習事例にばらつきをもたせるデータ拡張も、頑健性の向上につながる。ただし、ほとんどのテキストを一度しか見ない大規模な事前学習では、ドロップアウトは汎化の利点がないまま学習を遅くするため、通常は無効にされる。主な手段は重み減衰と丁寧な重複除去であり、ドロップアウトが再び使われるのは、主に小さなデータセットでのファインチューニングである。
早期終了も一つの戦略である。学習中に検証損失を監視していれば、過学習が進む前に最適化を打ち切れる。膨大なコーパスで学習した非常に大きなモデルでは、小さなデータセットの場合より過学習が軽いことが多いが、特定ドメイン向けのファインチューニングで再びそのリスクが生じうる。
スケールと汎化は微妙な形で関わり合っている。古典的な統計学の直観では、データが支えられる以上にモデルの表現力が大きくなると、テスト誤差は上がるはずである。ところが、非常に大きなモデルは多くの場合、改善し続ける。実際に観察される形を表すのが「二重降下(double descent)」という現象だ。表現力を大きくしていくと、テスト誤差はまず下がり、次に補間しきい値(モデルが学習データにちょうどぴったり当てはまるだけの大きさになる点)の付近でピークまで上がり、さらに表現力を大きくすると再び下がる。現代の大規模言語モデルは、一般にこのピークをはるかに越えた領域で動作している。とはいえ、過学習が起こらなくなるわけではない。表現力に比べてデータが限られている場合や、コーパスに重複が多い場合には、記憶はやはり生じる。表現力とデータセットの規模は、ともに大きくしていく必要がある。
大規模なモデルでは、まれな系列の記憶も懸念される。そこには機微な情報が含まれている可能性がある。全体としての検証指標が良好でも、個別の記憶がプライバシー上のリスクになりうる。丁寧なデータ選別と正則化によって、このような影響を減らせる。
ポイント:効果的な学習とは、モデルの表現力とデータの多様性のバランスを取り、予測誤差を最小化しながら、未知の文脈への汎化を保つことである。
学習済みのベースモデルが手に入ったら、次の段階は適応である。事前学習によって幅広い言語能力は得られるが、実用的なシステムには多くの場合、特化、アラインメント、ドメインへの焦点化が必要になる。
ポチっとでの実践
評価データを分ける理由
学習候補と評価ケースを分ける際、文面が違っても同じ場面の言い換えなら近い例として扱います。練習に使った問題の別表現が評価側に入ると、初めて見る依頼への対応力を過大に見積もりやすくなるためです。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る