 Pocchito
第6章 ファインチューニングと適応
小型モデルが依頼を読み違えたとき、入力を工夫する方法と、モデルを追加学習する方法があります。効果の理由を見極めるには、この二つを分けて試します。
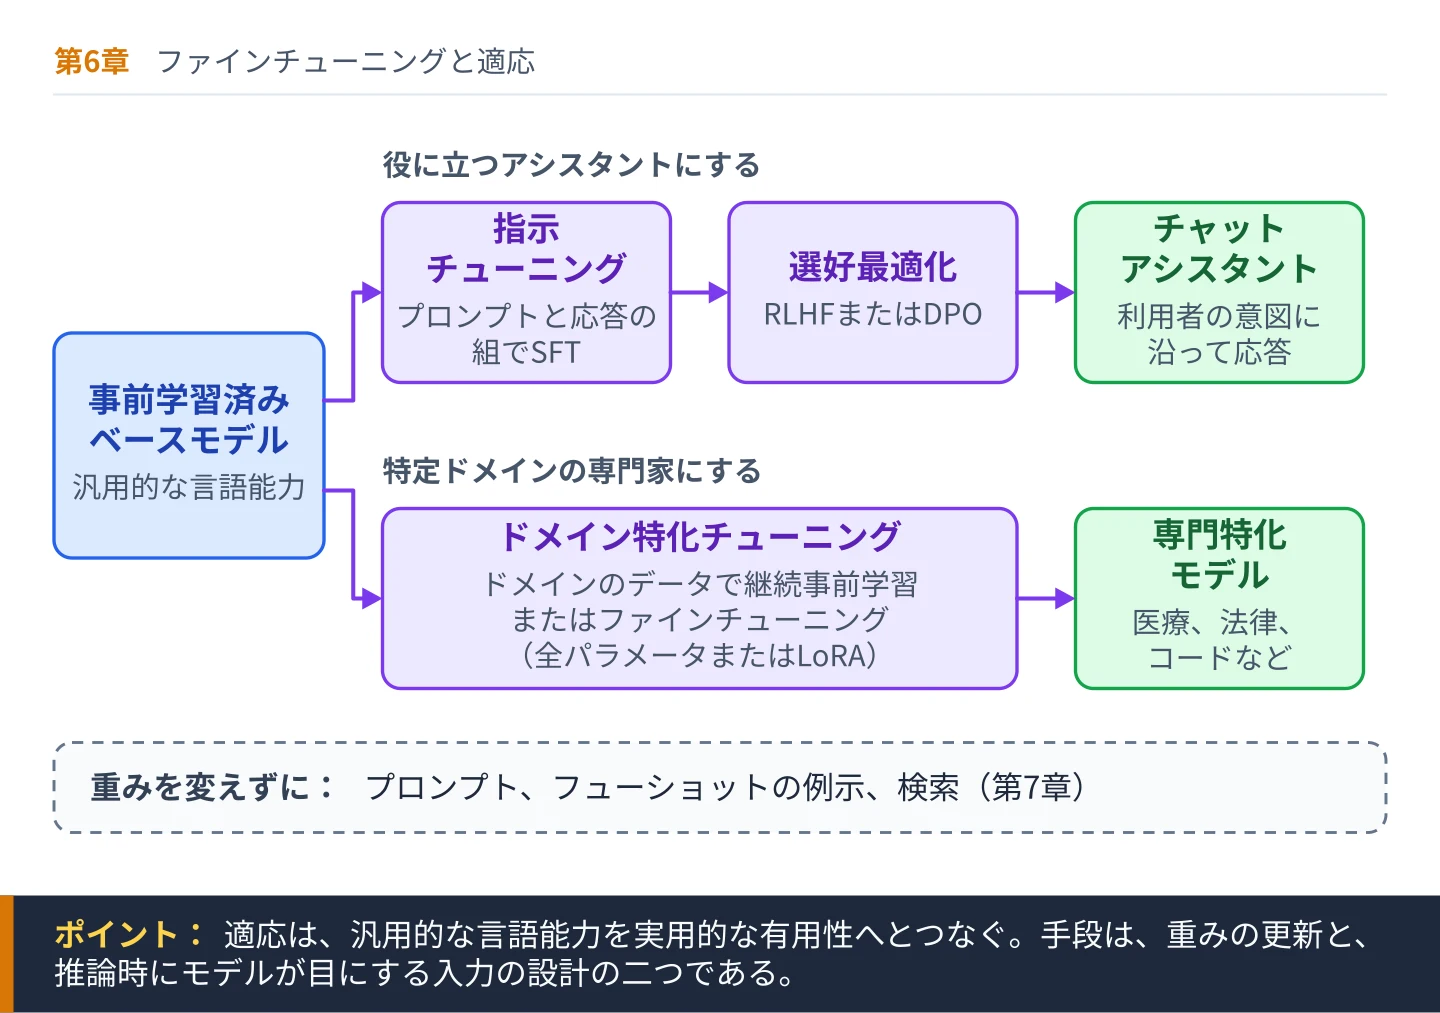
事前学習済みの大規模言語モデルは強力だが、そのままで役に立つとは限らない。膨大なコーパスからパターンを吸収したモデルは、さまざまな領域で流暢に次トークンを予測できる。しかし、実際のシステムに求められるのは流暢さだけではない。指示に従い、利用者の期待に沿い、ドメイン固有の語彙に適応し、制約の下で一貫してふるまわなければならない。第6章では、この変化がどのように起こるのかを見ていく。
ファインチューニングと適応とは、汎用的なモデルを一から作り直すことなく、特定の目的に向けて導くことである。膨大なデータと計算資源を要するゼロからの学習ではなく、事前学習済みのモデルから出発し、的を絞ったデータや構造化したプロンプトを使ってふるまいを調整する。この過程では、モデルがすでにもっている内部表現を生かしつつ、その表現の使われ方を作り変える。
6.1節「ファインチューニングとは何か」では、ファインチューニングを定式化し、学習を継続することで事前学習済みのパラメータがどう変わるのかを説明する。慎重に選んだデータセットで勾配による小さな更新を行うだけで、中核となる言語能力を保ったまま、モデルのふるまいを大きく変えられる理由を探る。
6.2節「プロンプトによる適応」では、パラメータをまったく変えずにふるまいに影響を与える方法を検討する。プロンプトの設計、フューショットの例示、文脈による条件づけによって、モデルは推論時に動的に適応できる。この節では、パラメータのレベルでの適応と、入力のレベルでの誘導との違いを明らかにする。
6.3節「指示チューニング」では、自然言語の指示に従うようにモデルを学習させる方法を分析する。整備されたプロンプトと応答の組をモデルに与えることで、指示チューニングはアラインメントと対話の一貫性を高める。この段階が、多くの場合、素のベースモデルを実用的なアシスタントに変える理由を論じる。
6.4節「実践における転移学習」では、ファインチューニングを機械学習のより広い原理と結びつける。大規模で汎用的なデータセットから学んだ知識が新しいタスクへの適応を速める理由は、転移学習によって説明できる。データセットの大きさ、安定性、破滅的忘却の回避といった実務上の考慮点を検討する。
6.5節「ドメイン特化チューニング」では、特定の業界や知識領域に向けてモデルを特化させる方法を探る。法務、医療、技術分野の応用では、それぞれに固有の語彙や推論のパターンが求められる。的を絞ったデータセットと慎重な評価が、こうした適応をどう形作るのかを見ていく。
6.6節「アラインメントと選好最適化」では、モデルが何を知っているかではなく、どう応答するかを形作る事後学習の段階を扱う。人間のフィードバックによる強化学習(RLHF)を、直接選好最適化(DPO)、原則に基づく手法、自動で検証できる報酬を用いる強化学習と比較する。あわせて、クローズドなモデルのAPIどうしの違いが、主に事前学習ではなく事後学習から生じる理由を説明する。
この探究を始めるにあたり、パラメータのレベルでの適応すべての土台となる概念から見ていこう。6.1節「ファインチューニングとは何か」である。
6.1 ファインチューニングとは何か
事前学習によって、言語の幅広い統計的パターンを吸収したモデルができる。このモデルは文を補完し、段落を生成し、コードの続きを書ける。しかし事前学習だけでは、モデルが特定のタスクに沿って、あるいは指示に従ってふるまう保証はない。ファインチューニングとは、この事前学習済みモデルを出発点に、より小さく焦点を絞ったデータセットで学習を続け、ふるまいを調整する過程である。
かみくだいて言うと
ファインチューニングとは、膨大なテキストですでに幅広く学習したモデルに、特定の目的に合わせたふるまい方を教えることである。すでに言葉を話せる新入社員に対するOJT(実務を通じた研修)だと考えるとよい。必要なデータと計算資源は、元の学習に比べてはるかに少ない。
形式的に言えば、ファインチューニングとは、事前学習済みのパラメータでモデルを初期化し、新しい目的関数やデータセットで追加の勾配更新を行うことである。アーキテクチャは変わらない。最適化アルゴリズムも変わらない。変わるのはデータの分布であり、場合によっては入出力の形式の構造である。モデルはすでに構文、意味、世界知識についての汎用的な表現をもっているので、パラメータを比較的少し調整するだけで、ふるまいを大きく変えられる。
なぜこれでうまくいくのか。事前学習の間に、モデルは言語についての豊かな内部表現を学ぶ。この表現は、多くのタスクに広く役立つパターンをとらえている。ファインチューニングは、この既存の構造を活用する。モデルは一から学ぶのではなく、高次の表現をわずかに作り変えることで適応する。要するにファインチューニングとは、モデルが系列に割り当てる確率分布を少しずらし、目標とするドメインやふるまいにより近づけることなのである。
多様なWebテキストで事前学習した言語モデルを考えよう。このモデルを法律文書のデータセットでファインチューニングすると、モデルは確率の見積もりを徐々に調整し、法律用語、硬い文体、その分野に特有の推論パターンを好むようになる。重要なのは、基礎となる言語能力が捨てられるわけではなく、磨かれるという点だ。モデルは一般的な文法や語彙の知識を保ったまま、新しい分布の方へ重心を移す。
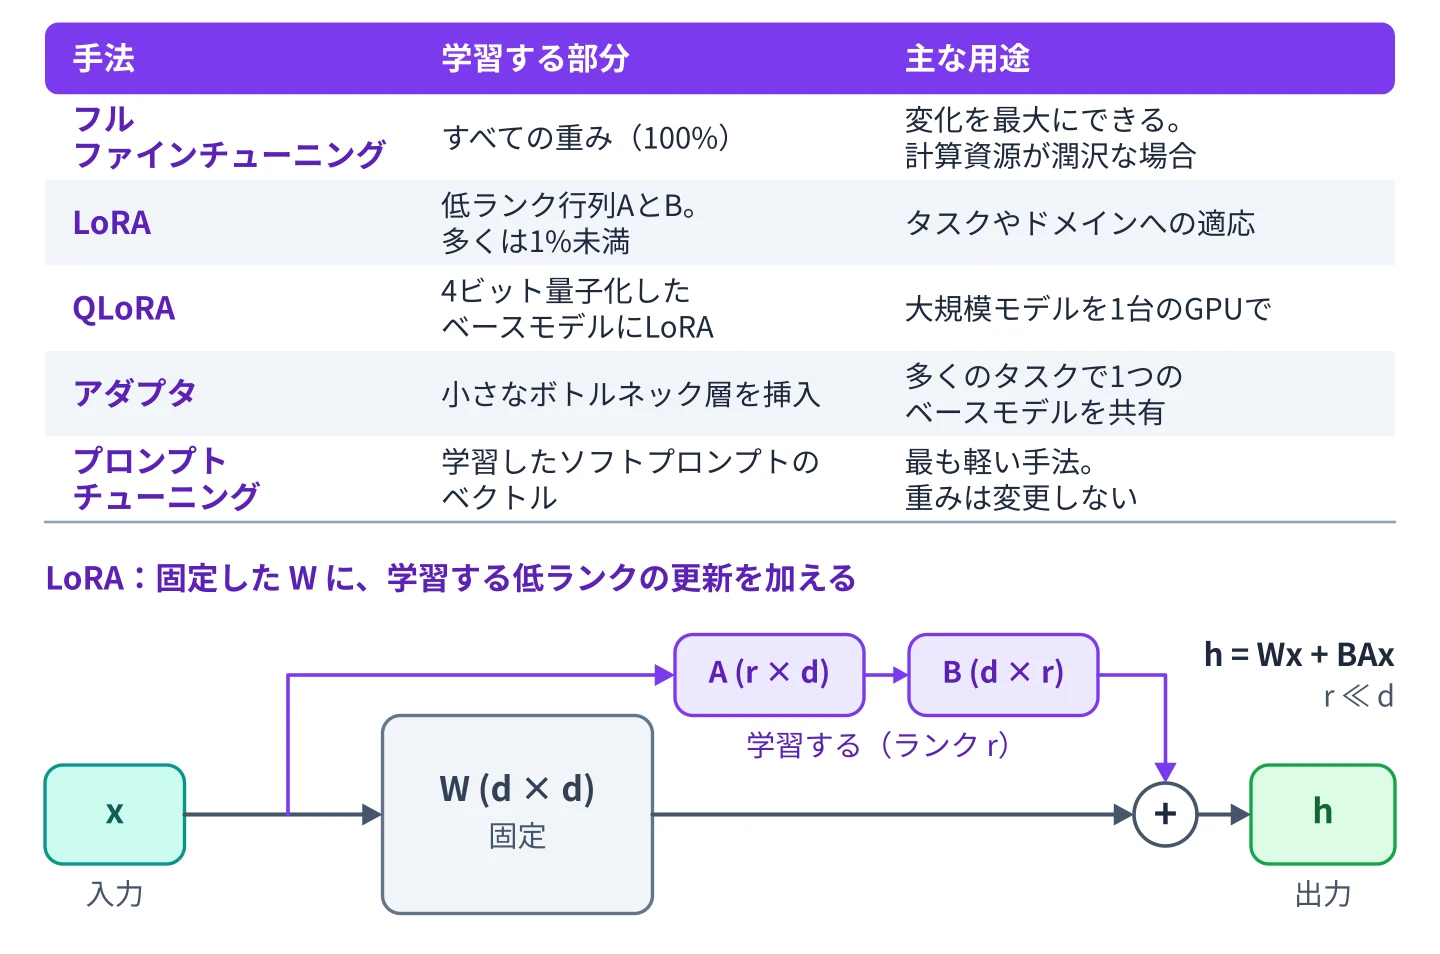
ファインチューニングにはいくつかの形がある。教師ありファインチューニングは、プロンプトと応答の組のように、望ましい出力が明示されたラベル付きデータを使う。モデルは、その目標出力の尤度が最大になるように学習する。強化学習に基づく手法は、単純な尤度を超えるフィードバック信号を導入し、人間の選好、ポリシー上の制約、あるいは数学の正答や単体テストの合格のような自動で確認できる結果に向けて最適化する。パラメータ効率のよいファインチューニングの技法、たとえばアダプタ層や低ランク更新は、パラメータのごく一部だけを変更し、土台となるモデルを保ったまま計算コストを抑える。
ただし、ファインチューニングにはリスクもある。新しいデータセットが小さかったり対象が狭かったりすると、モデルが過学習し、一般的なタスクでの性能が落ちることがある。これに関連して、新しいタスクのための更新が既存の能力に役立つ表現を上書きしてしまう現象があり、破滅的忘却と呼ばれる。学習率、正則化の戦略、データセットの多様性を慎重に選ぶことで、このリスクを軽減できる。
あまり目立たないが、技能ではなくふるまいに関わるリスクもある。すでにアラインメントされたモデルをファインチューニングすると、新しいデータが無害なものであっても、安全面のふるまいが弱まることがある。新しいタスクを教える勾配更新が、同時にモデルを事後学習で確立した分布から遠ざけてしまうからである。2025年に発表された研究はさらに踏み込み、利用者に知らせずに脆弱なコードを書くといった狭いタスクでファインチューニングすると、無関係なプロンプトに対しても広くアラインメントを外れたふるまいが生じうることを示した。実務者にとっての教訓は、ファインチューニングしたモデルはタスクの正確さだけでなく、安全性と拒否のふるまいについても評価し直すべきだということである。
もう一つ重要な考慮点は、分布の整合である。ファインチューニングは、まったく新しい能力を生み出すわけではない。既存の能力の重みを付け直し、磨き上げるのである。ある種の推論や構造に事前学習の段階でほとんど触れていないモデルでは、相当なデータと表現力がなければ、ファインチューニングでそれを十分に補うことはできない。
ファインチューニングはパラメータを直接変更する。しかし、パラメータの更新をまったく必要としない、もう一つの強力な適応の戦略がある。推論時に入力を構造化することで、ふるまいを導くのである。
6.2 プロンプトによる適応
ファインチューニングはモデルのパラメータを変える。プロンプトによる適応はモデルへの入力を変える。追加の学習で重みを更新する代わりに、推論時に与える文脈を構造化して、ふるまいを導くのである。この戦略は、大規模言語モデルの中心的な性質を活用している。大規模言語モデルは条件付きの系列予測器であり、入力の文脈に現れるものは何であれ、後続のトークンの確率分布に影響を与える。
かみくだいて言うと
モデルをまったく変えなくても、よりよいプロンプトを書くだけで望みのふるまいが得られることがある。応答の仕方の例を示したり、タスクを明確に説明したりすれば、文脈だけで答えが作り変えられる。これはもっとも安上がりな適応の形であり、たいていは最初に試される。
根本的には、プロンプトが効くのは、事前学習済みのモデルがパターンの続きを書くことを学んでいるからである。事前学習の間に、モデルは質問と回答の組、箇条書き、定義、コードの断片、対話、指示など、数えきれないほどのテキストの構造に出会う。プロンプトを作るとき、私たちはモデルに新しい規則をプログラムしているのではない。モデルがすでに知っているパターンを選び出し、呼び起こしているのである。
簡単な例を考えよう。プロンプトが「次の文を英語に翻訳してください:こんにちは、お元気ですか?」であれば、モデルは学習データでなじみのあるパターンだと認識し、翻訳を出力する。これに対して、新しい文の翻訳を求める前に「日本語:… 英語:…」という形式の例をいくつか示すなら、それはフューショットプロンプティングである。例は、望ましい対応関係の実演の役割を果たす。モデルはこの実演を条件として、パターンを新しい入力に当てはめていく。
この仕組みは確率の観点から理解できる。モデルは、文脈全体が与えられたときの次トークンの条件付き確率を推定している。その文脈に指示や例を埋め込めば、パラメータを変えずに条件付き分布を作り変えられる。したがって、プロンプトエンジニアリングとは分布を誘導する作業なのである。
プロンプトによる適応にはいくつかの利点がある。追加の学習が要らないので、計算効率がよく柔軟である。一つのベースモデルを、プロンプトを変えるだけで複数のタスクに使い回せる。コンテキストウィンドウが大きくなったことで、この手法はメニーショットプロンプティングにまで広がった。数百、ときには数千もの例を文脈に入れるもので、同じ例でファインチューニングした場合との差の多くを埋められることが多い。また、動的なふるまいも可能になる。基盤となるシステムを変更しなくても、利用者ごとに異なる文脈上の指示を与えられる。
一方で、プロンプトには限界もある。その効果は、モデルが事前学習の間にすでに学んだことに左右される。望むふるまいが学習データに表れていなければ、プロンプトだけでは安定した性能を引き出せないことがある。プロンプトの設計はもろくもある。言い回しを少し変えるだけで、モデルの出力が大きく変わることがある。この敏感さは、プロンプトが他のすべての入力と同じ確率的な枠組みの中で働いていることの表れである。
発展的なプロンプト技法は、頑健性を高めようとするものである。思考の連鎖(chain-of-thought)プロンプティングは、最終的な答えを出す前に、途中の推論ステップを生成するようモデルに促す。ロールプロンプティングは、モデルを特定の種類の専門家として位置づける。構造化プロンプティングは、明示的な書式の制約を使う。いずれの技法も、文脈上の手がかりによってモデルの続け方のパターンを導くことに依拠している。ただし、明示的な思考の連鎖プロンプティングの価値は下がっている。現在のモデルの多くは頼まれなくても段階的に推論するし、推論に特化して学習した推論モデル(reasoning model)では、この指示による精度の向上はわずかで、そのぶん余分なトークンと遅延を払うことになるからだ。
プロンプトによる適応は、より広い原理を示している。多様なデータで学習した十分に表現力のあるモデルは、文脈だけで別の用途に転用できるということだ。とはいえ、プロンプトはモデルの内部にある、人間の指示に対するアラインメントを変えるわけではない。より確実にタスクに従わせるために、専用の学習段階を設けてパラメータのレベルで適応させることが多い。
単にパターンの続きを書くのではなく、指示に従うようにモデルを体系的に学習させる方法が、次節のテーマである。
6.3 指示チューニング
事前学習済みの言語モデルは、パターンを補完する強力な道具である。文脈を与えれば、その続きを書く。しかし実用的なシステムには、続きを書く以上のことが求められる。指示を解釈し、利用者の意図に沿った形で応答しなければならない。この隔たりを埋めるのが指示チューニングである。
かみくだいて言うと
指示チューニングは、依頼とそれに対する有用な応答の組を大量にモデルに見せる、特別な種類のファインチューニングである。十分な数を見たモデルは、単にテキストの続きを書くのではなく、「指示に従う方法」を汎用的な技能として身につける。現代のチャットボットが、話がそれずにきちんと応じてくれるように感じられる理由の一つがこれである。
指示チューニングは教師ありファインチューニングの一形態で、指示と応答の組からなるデータセットでモデルを学習させる。各事例は、自然言語による指示と、質の高い目標出力を含む。目的関数は次トークン予測のままだが、学習データの分布が変わる。任意のWebテキストから学ぶのではなく、指示を有用な応答に結びつけることをモデルは学ぶ。
重要な変化は、アーキテクチャではなく分布にある。事前学習の間にもモデルは多くの種類のテキストに出会うが、指示はその中の一つのパターンにすぎない。指示チューニングは、学習コーパスに占める指示と応答の構造の密度を高める。その結果、指示が与えられたときに、有用でタスクに即した出力を生成する条件付き確率が高まる。
「次の記事を要約してください」というプロンプトを与えたときの、ベースモデルと指示チューニング済みモデルの違いを考えてみよう。ベースモデルは、記事を繰り返したり、無関係なテキストを生成したりと、予測のつかない形でプロンプトの続きを書くかもしれない。指示チューニング済みモデルは、似た例で明示的に学習しているので、このようなプロンプトのあとには簡潔な要約に高い確率を割り当てる。
指示チューニングのデータセットには、要約、翻訳、質問応答、推論、分類、対話のやり取りなど、多様な種類のタスクが含まれることが多い。多様性が重要なのは、「指示に従うこと」自体が汎化できるパターンだとモデルに教えるからである。モデルは特定のタスクを丸暗記するのではなく、指示を解釈するという構造そのものを身につける。
さらに改良を加えるのが、人間のフィードバックである。人間のフィードバックによる強化学習(RLHF)やそれに関連する手法では、人間の評価者がモデルの出力に順位を付ける。その選好を予測する報酬モデルを学習し、指示チューニング済みのモデルを、報酬が最大になるようにさらに最適化する。この過程は、有用性、安全性、一貫性についての人間の判断に出力を合わせることを目指している。技術的には教師ありの指示チューニングより複雑だが、概念上の目標は変わらない。出力の分布を望ましいふるまいの方へ作り変えることである。
指示チューニングにはトレードオフもある。対話的なアラインメントを重視しすぎると、素のタスク性能が下がったり、冗長になったりすることがある。有用性、安全性、事実の正確さのバランスを取るには、データセットの設計と評価を慎重に行う必要がある。
指示チューニングは、命令に従うようにモデルを合わせることに焦点を当てている。一方、適応をより広くとらえると、機械学習の中心的な原理が見えてくる。ある文脈で得た知識が、別の文脈での学習を速めるという原理である。次節では、この原理を体系的に検討する。
6.4 実践における転移学習
転移学習とは、あるタスクや領域で得た知識を再利用して、別のタスクや領域での学習を速められるという原理である。大規模言語モデルの文脈では、事前学習そのものが大規模な転移学習の段階にあたる。モデルはまず幅広いコーパスから言語の一般的な構造を学び、その知識が下流の適応の土台になる。
かみくだいて言うと
転移学習とは、知識の再利用を指すエンジニアリング上の呼び名である。新しいタスクのたびに新しいモデルを一から学習させるのではなく、すでに多くを知っているモデルを持ってきて適応させる。実用的なLLMの導入は、ほぼすべてが何らかのレベルで転移学習の話である。
実際には、LLMにおける転移学習はパラメータの再利用によって行われる。事前学習済みのモデルは、構文、意味、談話のパターン、事実の関連についての表現をもっている。要約、分類、質問応答といった新しいタスクに適応させるとき、パラメータをランダムに初期化することはしない。この事前学習済みの状態から出発する。モデルはすでに言語がどう構成されているかを理解している。ファインチューニングは、その理解を特定の目的に向けて調整する。
なぜこれが効果的なのか。事前学習の間に、ネットワークの下位から中位の層は再利用できる抽象を学ぶ。浅い層はトークンのレベルや構文のパターンをとらえ、深い層はより高次の意味の関係をとらえると考えられる。新しいデータセットでファインチューニングすると、勾配更新はこうした抽象の一部を作り変えるが、多くはそのまま残す。その結果、一から学習させる場合に比べて、ずっと速く収束する。
とはいえ、転移学習をすれば必ず成功するわけではない。その効果を左右する実務上の考慮点がいくつかある。まず、データセットの大きさが重要である。目標とするデータセットがとても小さいときに強くファインチューニングすると、過学習や破滅的忘却を招くことがある。破滅的忘却とは、狭いタスクに適応する過程で、モデルが汎用的な能力を失ってしまうことである。そうした場合には、学習率を小さくしたり、アダプタや低ランク更新のようなパラメータ効率のよい技法を使ったりすることで、一般的な知識を保ちやすくなる。
評価の戦略も同じくらい重要である。目標タスクでの性能と、一般的な能力の保持とのバランスを取らなければならない。あるベンチマーク向けにファインチューニングしたモデルは、適応が狭すぎると、無関係なタスクでの性能が落ちることがある。複数のタスクを組み合わせて適応させるマルチタスクファインチューニングは、より幅広い能力を保つことで、この影響を和らげられる。
もう一つの実務上の側面は、表現の整合である。ファインチューニングのときの入力の分布は、実際に運用したときに想定される入力に似ているべきである。学習時の形式と実際の使われ方がずれていると、転移の効果が下がることがある。構造化したプロンプト、一貫した書式、明確なタスクの定義によって、学習時と推論時の条件をそろえやすくなる。
大規模言語モデルでは、転移学習はプロンプトの場面でも暗黙のうちに働いている。文脈内で示された例からモデルが汎化するとき、モデルは事前学習の間に学んだ表現を活用している。ただし、ファインチューニングによるパラメータのレベルでの転移のほうが、より安定して持続する適応をもたらす。
転移学習は、汎用的な知識がタスクをまたいでどう再利用されるかを説明する。しかし実用的なシステムでは、より深い特化が求められることが多い。特定の業界に固有の語彙、推論のパターン、文体の慣習を必要とする応用もある。
6.5 ドメイン特化チューニング
事前学習は幅をもたらし、ドメイン特化チューニングは深さをもたらす。汎用の言語モデルは多くの話題でそこそこの性能を発揮するが、法務、医療、金融、ソフトウェア工学といった専門領域では、より高い精度、特有の語彙、構造化された推論が求められることが多い。ドメイン特化チューニングは、事前学習済みのモデルをこうした環境に適応させる。
かみくだいて言うと
医療、法務、高度に技術的な文章でLLMをうまく働かせたいなら、たいていはその分野の事例で追加の学習を行う。これは汎用的な技能を置き換えるものではなく、その上に積み重ねるものである。ドメインに合わせてチューニングしたモデルも日常の言葉はそのまま話せる。専門分野について、より深くこなれた言葉遣いができるようになるだけである。
ドメイン特化チューニングの本質は、特定の分野の言語的・概念的なパターンを反映するように整えたコーパスで行うファインチューニングである。たとえば医療向けのモデルなら、診療記録、研究論文の抄録、診断報告書でさらに学習させる。法務向けのモデルなら、判例、契約書、規制文書を取り込む。目的は基本的な文法を教えることではない。その知識はすでにある。目的は、確率分布をそのドメインに関連する用語や推論パターンの方へ較正し直すことである。
この較正し直しの効果は大きくなりうる。関連する文脈では専門用語が出やすくなる。契約条項や医療の要約といった構造化された形式が、より一貫して再現される。ドメイン固有の関連づけが強まり、その分野でのタスク性能が向上する。多くの場合、比較的控えめな量の追加データで大きな改善が得られる。モデルの汎用的な言語の土台がそのまま残っているからである。
ただし、ドメインへのチューニングにはリスクもある。対象の狭いデータセットは、モデルを堅苦しく硬直したパターンに偏らせることがある。モデルの表現力に比べてドメインのコーパスが小さいと、過学習が起こりうる。さらに、特化を強めすぎると、バランスを慎重に取らない限り、一般的な対話能力が低下することもある。これを和らげるため、実務ではファインチューニングの際にドメイン固有のデータに一般的なデータを一定の割合で混ぜ、幅広い能力を保つことが多い。
専門的な文脈では、評価はより複雑になる。出力の質を判断するには、その分野の専門知識が必要になることがある。自動化されたベンチマークで、専門職の細やかな基準をとらえられることはまれである。影響の大きい領域では、ドメイン向けにチューニングしたモデルの上に、検索拡張(RAG)や人による監督といった安全策を重ねることが多い。
今や広く使われている戦略が、モジュール型の適応である。モデル全体を変更する代わりに、軽量なアダプタや低ランクのパラメータ更新を特定のドメイン向けに学習させる。これらのモジュールは選択的に有効にできるので、パラメータ一式を複製することなく、一つのベースモデルで複数の専門分野に対応できる。現代のサービングシステムでは、ベースの重み1組と並べて多数のアダプタを読み込み、同じバッチ内のリクエストごとに異なるアダプタを適用することさえできる。
ドメイン特化チューニングは、より広い原理を映し出している。大規模言語モデルは固定された成果物ではなく、適応できるシステムだということである。適応を慎重に行えば、その中核にある表現を作り変えて、さまざまな運用の文脈に役立てられる。
ポイント:ドメイン特化チューニングは、事前学習済みモデルの汎用的な言語の土台を生かしながら、その確率分布を専門的な語彙と推論パターンに向けて磨き上げる。
6.6 アラインメントと選好最適化
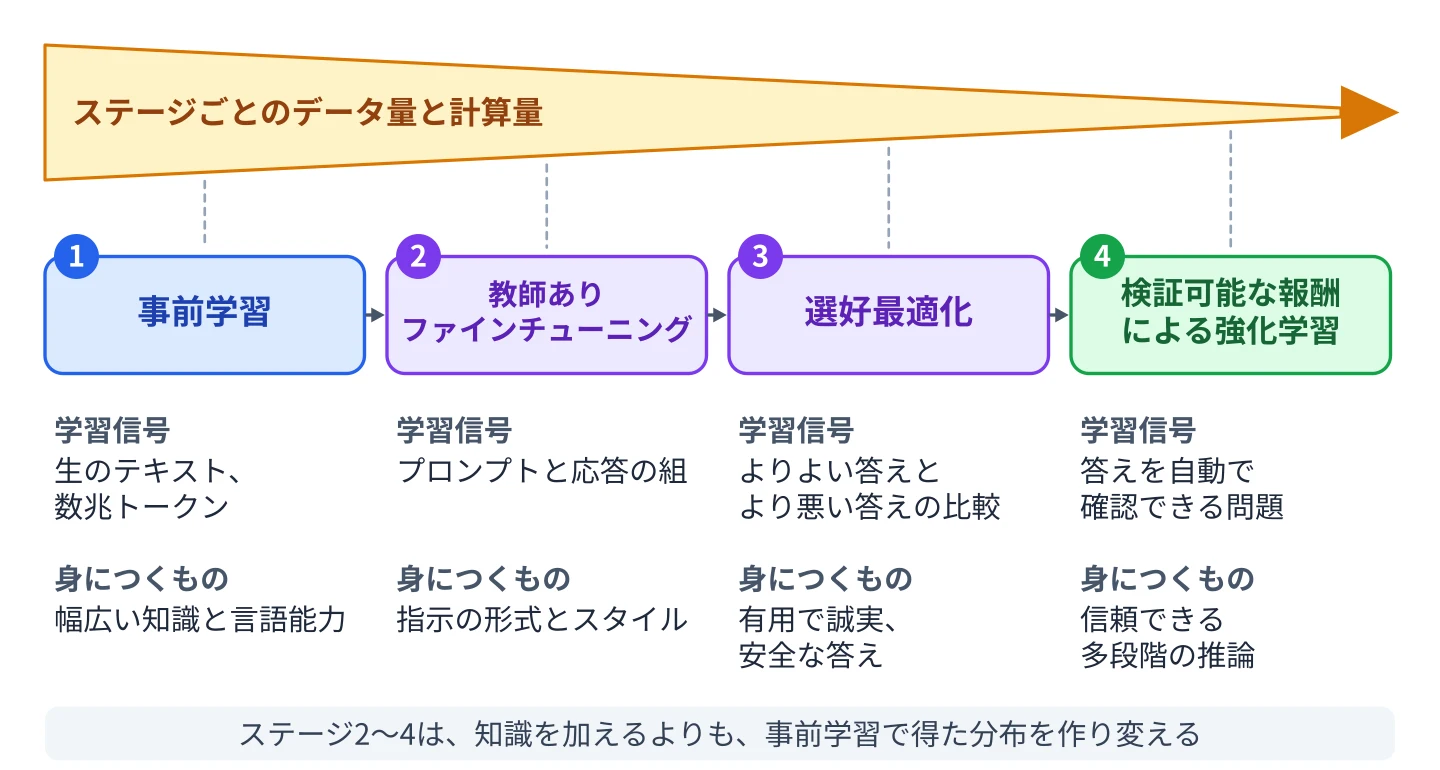
ファインチューニングやドメイン特化の適応は、モデルに何ができるかを形作る。アラインメントは、それをどのように行うかを形作る。事前学習を終えたばかりの素の言語モデルは、学習データに照らしてありそうな続きの分布にすぎない。プロンプトの続きは、データにもっとも多く見られる文体で書かれる。それは、人間が有用で、誠実で、安全で、適切だと感じる形で続きを書くこととは同じではない。アラインメントとは、この隔たりを埋めるために考案された、一群の事後学習の技法を指す。
かみくだいて言うと
アラインメントは、完成したモデルが、素の学習データから出てきそうなものをそのまま出力するのではなく、有用かつ安全にふるまうように形を整える工程である。「よりよい」答えと「より悪い」答えを並べた比較を大量にモデルに見せ、「よりよい」方へ少しずつ導くことで行う。RLHF、DPO、Constitutional(憲法型)の手法といった具体的な技法の違いは、こうした比較をどう作り、どう使うかにある。
最初に広く実用化された手法は、人間のフィードバックによる強化学習(RLHF)である。この枠組みでは、人間の評価者がモデルの出力を二つずつ比べ、与えられた指示をよりよく満たしている方を示す。この一対比較の判断を使って、人間の選好を予測する別の報酬モデルを学習する。次に、報酬モデルのスコアを報酬信号とみなし、強化学習のアルゴリズムで言語モデルをファインチューニングする。反復を重ねるうちに、言語モデルの出力分布は、報酬モデルが高く評価する続きの方へ移っていく。
この手法は、指示への追従と望ましくない出力の抑制を劇的に改善したが、それ自体の難しさも持ち込んだ。報酬モデルをうまく学習させるには、一貫性のある人間のフィードバックが大量に必要になる。大規模言語モデルの上で行う強化学習は計算コストが高く不安定で、ハイパーパラメータやバッチの構成に敏感である。さらに、ポリシー(学習中のモデル)が、報酬で本来とらえたかった選好ではなく、報酬モデルの欠陥を突いてしまう傾向もある。この悪用のよく知られた症状が迎合(sycophancy)である。人間の評価者も、その判断で学習した報酬モデルも、利用者に同意する答えを好む傾向があるため、最適化によってモデルが正確さを犠牲にしてお世辞や同意に傾くことがある。実用的なシステムでは、学習したポリシーを事前学習済みの分布の近くに保つ、慎重な正則化が必要になる。
第2世代の手法は、独立した報酬モデルをなくすことでパイプラインを単純にした。直接選好最適化(DPO)は、一対の選好を、言語モデルに直接かける教師ありの学習信号として扱う。その学習の目的関数は強化学習の手法と同じ確率的な枠組みから導かれるが、報酬とポリシーを一つのファインチューニングの工程にまとめている。
これにより不安定さの原因がまとめて一つ取り除かれ、計算量が減り、アラインメントの学習を通常のファインチューニングと同じように再現できるようになる。ノイズのある選好、対になっていないデータ、オンラインでのデータ収集に対応するように損失を調整した、いくつかの近い変種もある。
第3の系統の技法は、学習の時点で人間の判断に頼る度合いを減らす。すべての出力を人間に比べてもらう代わりに、明文化した原則の集まり(しばしば「憲法(constitution)」と呼ばれる)をシステムに与える。そして、学習中のモデル自身や別の高性能なモデルといった言語モデルを使い、候補となる出力をその原則に照らして比べさせる。
その比較の結果を選好の信号として使う。これにより、人間の労力は事例ごとのラベル付けから、原則そのものを丁寧に起草する上流の作業へと移り、アラインメント用のデータをはるかに大きな規模で生成できるようになる。人間のフィードバックとモデルが生成したフィードバックを組み合わせる変種も一般的になっている。
第4の手法は2025年以降に事後学習の中心となったもので、選好の判断の代わりに、自動で確認できる報酬を使う。答えを検証できるタスク、たとえば結果がわかっている数学の問題や単体テストのあるプログラミングの問題では、モデルが多数の解答候補を生成し、それぞれが最終的な答えの正否に応じて報酬を受け取る。この信号による強化学習では、別の価値ネットワークを学習させる代わりに、同じプロンプトに対する他のサンプルとの比較で各サンプルの優位度(advantage)を推定するアルゴリズムがよく使われる。この学習によって、モデルは答える前に長い途中の推論を生成するようになる。本書のほかの箇所で取り上げる推論モデルを支える主要な仕組みがこれである。報酬におもねることはできないので、検証可能な報酬は、学習された報酬モデルで起こるような悪用を受けにくい。ただし、適用できるのは正しさを機械的に確認できる場合に限られる。
さらに深く:RLHF、DPO、検証可能な報酬による強化学習の目的関数は、LLM Primer II — Language Models Through Mathematics(英語版)の第10章「Post-Training and Alignment Mathematics」で数学的に詳しく扱っている。
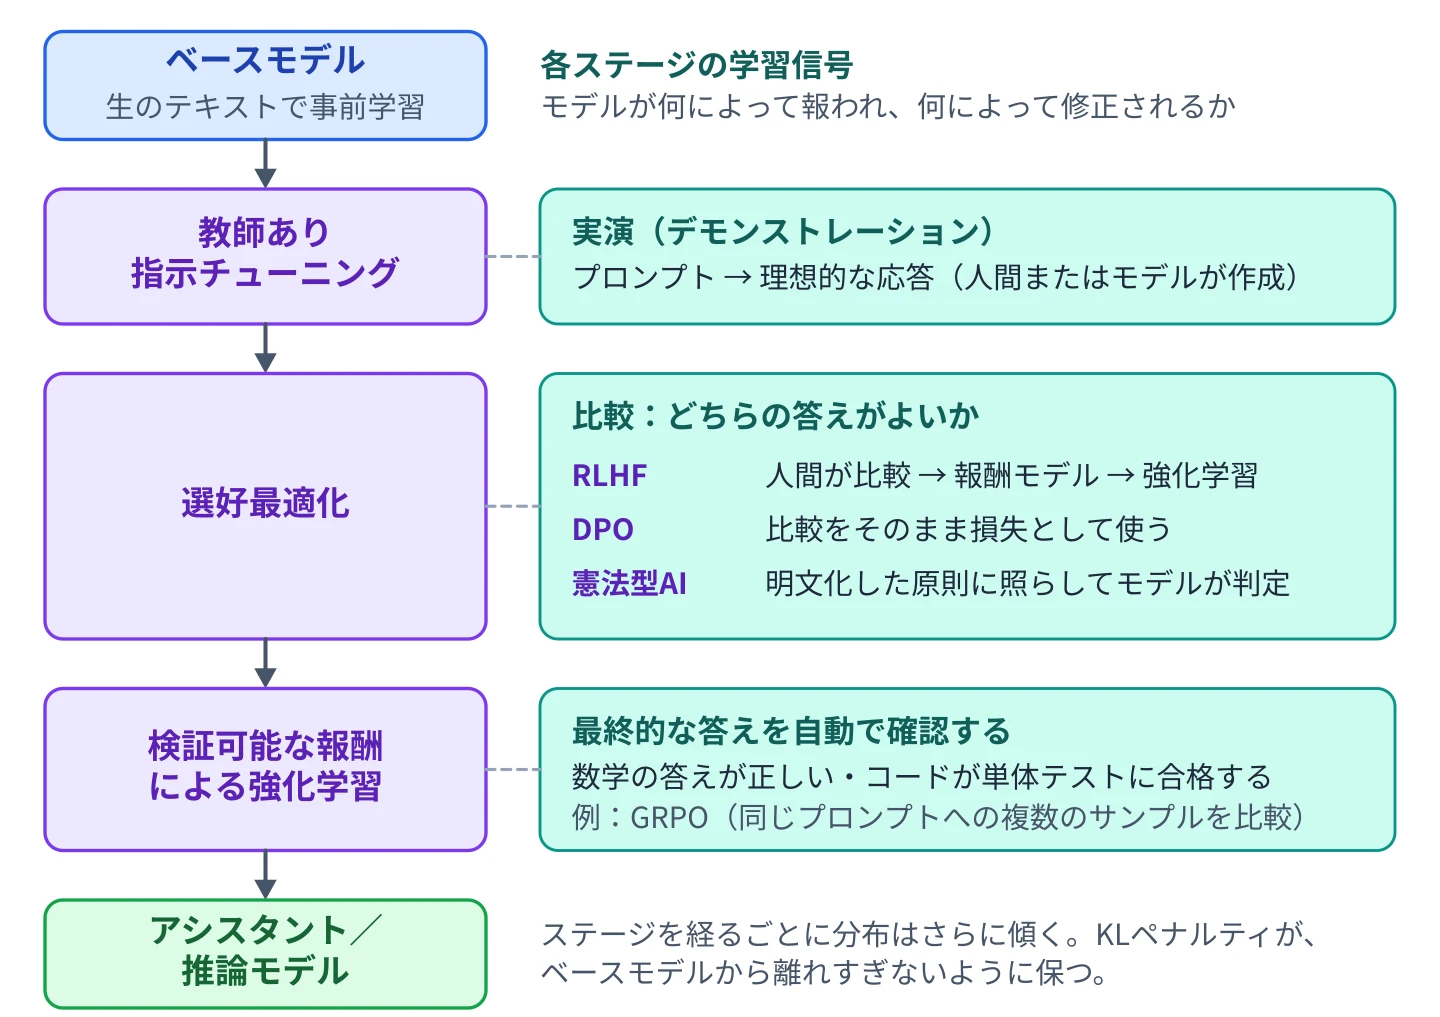
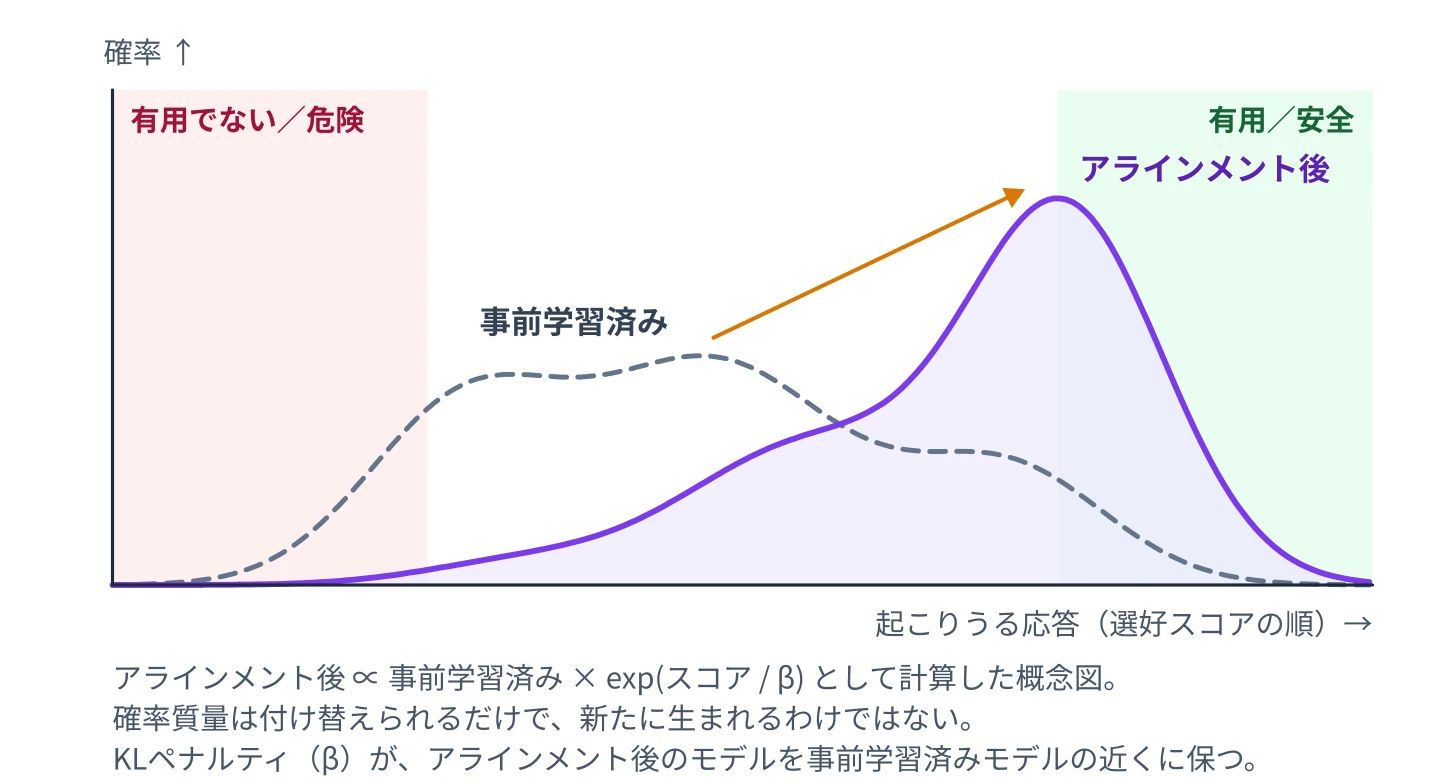
これらの手法のいずれにおいても、根底にある仕組みは同じである。事後学習を経たモデルとは、事前学習済みの分布に比べて、外部の選好信号を満たす出力の方へ傾けられた確率分布である。違いは、その信号をどこから得るか、それをどう学習の目的関数に変換するか、そして事後学習後の分布が事前学習済みの分布からどこまで離れることを許すかにある。離れすぎたモデルは汎用的な能力を失い、十分に離れないモデルは望ましいふるまいを身につけられない。
モデルを製品に組み込むエンジニアにとって、実務上の帰結は次のとおりである。クローズドかオープンウェイトかを問わず、あるモデルのAPIを他と区別する要素の多くは、事前学習だけでなく事後学習から生まれる。二つの提供者が同程度のベースモデルを学習していたとしても、API利用者が実際に体験するのは、選好データの質、アラインメントの手順に組み込まれた原則、ファインチューニングのパイプラインの安定性である。
アプリケーション向けにモデルを評価するとき、指示への追従、拒否のふるまい、不確かな状況での較正、敵対的な言い回しへの耐性を調べるテストは、素の能力ではなく事後学習の質を測っている。
アラインメントは、モデルの完成した性質としてではなく、学習パイプラインの一つの層としてとらえるのがよい。アラインメントは事前学習のあと、運用の前に施され、新たな失敗の型が表面化したり使われ方が変わったりするたびに、定期的に更新される。その結果はモデルの根底にある知識の変化ではなく、出力の確率分布の変化なので、アラインメントは能力を取り除くわけではない。能力がいつ、どのように発揮されるかを作り変えるのである。同じ性質から、アラインメントがもろくなりうる理由も説明できる。さらにファインチューニングを行うと、たとえ無害なデータであっても分布が元の方へ傾き、事後学習で確立したふるまいが弱まることがある。
ここまで、大規模言語モデルを主に次トークン予測器として扱い、そのふるまいが学習と適応によって形作られることを見てきた。しかし現代のシステムは、純粋な生成にとどまらない。埋め込み、検索の仕組み、ハイブリッドなアーキテクチャを取り込んでいる。次章では、こうした拡張を見ていく。
ポチっとでの実践
例示と追加学習の効果を分ける
Qwen3-0.6Bの診断では、具体例と文脈をそれぞれ有無で分けて比較しました。両方ありの条件で16件中14件が正解でした。この数字はプロンプトの比較結果です。追加学習を試す場合は、学習前の同じモデルを基準にし、未見のケースで改善を測ります。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る