 Pocchito
第7章 次トークン予測の先へ
質問に関係する資料を探し、回答の根拠にするまで。検索と生成を組み合わせるしくみを解説します。
RAG(検索拡張生成)は、質問に関係する資料を探し、その抜粋をモデルに渡して回答を作る方法です。
図解 社内規程を調べて回答する例
1.質問を受け取る
「出張の交通費はいつまでに申請する?」↓
2.関連する資料を検索する
閲覧権限のある規程から「出張旅費」と「精算期限」に関係する箇所を探します。↓
3.質問と資料の抜粋をモデルに渡す
例として「出張終了後7日以内に申請する」と記載された条項を入力に加えます。↓
4.根拠とともに回答する
「出張終了後7日以内です」と回答し、参照した規程と条項を示します。
規程の文言と期限は説明用の例です。該当する資料が見つからなければ、その旨を伝えます。
本書ではここまで、大規模言語モデルを「系列の次のトークンを予測するように学習したシステム」として説明してきた。この捉え方は技術的に正確であり、すべての土台でもある。しかし、LLMを中心に組み立てられた現在のAIシステムは、単に文章の続きを書くだけのものではない。情報を検索し、意味をベクトル空間に埋め込み、外部のメモリと連携し、複数のモダリティを扱う。第7章では、こうした広がりへと視野を広げる。
本章のねらいは、次トークン予測を捨てることではない。次トークン予測が、より豊かなシステムを組み立てる部品になることを示すことにある。モデルが言語について質の高い内部表現をいったん獲得すれば、その表現はさまざまな用途に再利用できる。生成はその用途の一つにすぎない。
7.1節「埋め込みと意味表現」では、言語モデルが意味をとらえた密なベクトル表現をどのように作り出すかを見る。この埋め込み(エンベディング)によって、意味の近さにもとづく検索、クラスタリング、分類が可能になる。高次元のベクトル空間が概念どうしの関係をどう符号化しているのか、そしてなぜこの表現が多くのAIアプリケーションの中核になっているのかを考える。
7.2節「生成と検索」では、互いを補い合う二つのパラダイムを対比する。生成は、学習した分布にもとづいて新しいテキストを合成する。検索は、外部のデータベースから関連する情報を取り出す。それぞれがどのような場面に向いているか、信頼性・コスト・解釈可能性の面でどう違うかを分析する。
7.3節「外部メモリを持つハイブリッドモデル」では、モデルの重みに蓄えられたパラメトリックな知識と、外部に置かれたノンパラメトリックな知識を組み合わせるアーキテクチャを扱う。こうしたシステムでは、モデルは情報を内側に抱え込んだ閉じた世界ではなく、メモリシステムにつながった推論エンジンとして位置づけられる。
7.4節「検索拡張生成(RAG)」では、このハイブリッド方式の実践的な実装を取り上げる。推論処理の時点で関連文書を検索し、それを条件として生成を行うことで、RAGシステムは事実への根拠づけを強め、ハルシネーションを減らす。アーキテクチャのパターン、インデックス作成の戦略、トレードオフについて論じる。
7.5節「マルチモーダルへの拡張」では、テキストの枠そのものを越える。最先端のモデルは今や、言語と並んで画像や音声などのモダリティを日常的に扱っている。共有された表現空間とモダリティ間の注意機構が、視覚と言語を統合するシステムをどのように実現しているかを見ていく。
まずは、これらの拡張すべてを支えるもっとも強力な抽象化、すなわち意味のベクトル表現から始めよう。
7.1 埋め込みと意味表現
大規模言語モデルというと、生成されるテキストに目が向きがちである。しかし、LLMのもっとも強力な能力の一つは表からは見えないところにある。意味を高次元空間のベクトルとして表す能力だ。このベクトルは埋め込みと呼ばれ、セマンティック検索、クラスタリング、推薦システム、検索拡張型のアーキテクチャを支える基盤になっている。
かみくだいて言うと
埋め込みとは、ひとまとまりのテキストを、その意味をとらえた数値の並びに変換する方法である。意味の似たテキストには似た数値が割り当てられる。言い回しが違っていても検索エンジンが関連する結果を見つけられるのはこのためで、現在のAI製品の検索機能の多くがこの仕組みの上に成り立っている。
埋め込みとは、トークン、文、文書を表す密な数値ベクトルである。学習の過程で、モデルは離散的なトークンを連続的なベクトル空間へ写像することを学ぶ。この空間では、意味の関係が幾何学的な関係に対応する。意味の近い単語や文は、この空間の中で互いに近い位置に埋め込まれやすい。近さは通常、コサイン類似度や内積で測る。
埋め込みがなぜうまく働くのかを理解するために、モデルが文脈から次のトークンを予測するように学習していることを思い出そう。正確に予測するには、どの語がどの語と一緒に現れやすいかという共起のパターンを内部に取り込まなければならない。似た文脈に現れる単語には、似たベクトル表現が割り当てられる。この過程が積み重なると、近さが意味の共通性を反映する「意味の地形」ができあがる。初期の単語埋め込みモデルで最初に見いだされた有名な観察、すなわちベクトルの差が類推をとらえられるという現象(たとえば “king”(王)−“man”(男性)+“woman”(女性)が “queen”(女王)に近くなる)は、こうして学習された幾何構造から生まれる。
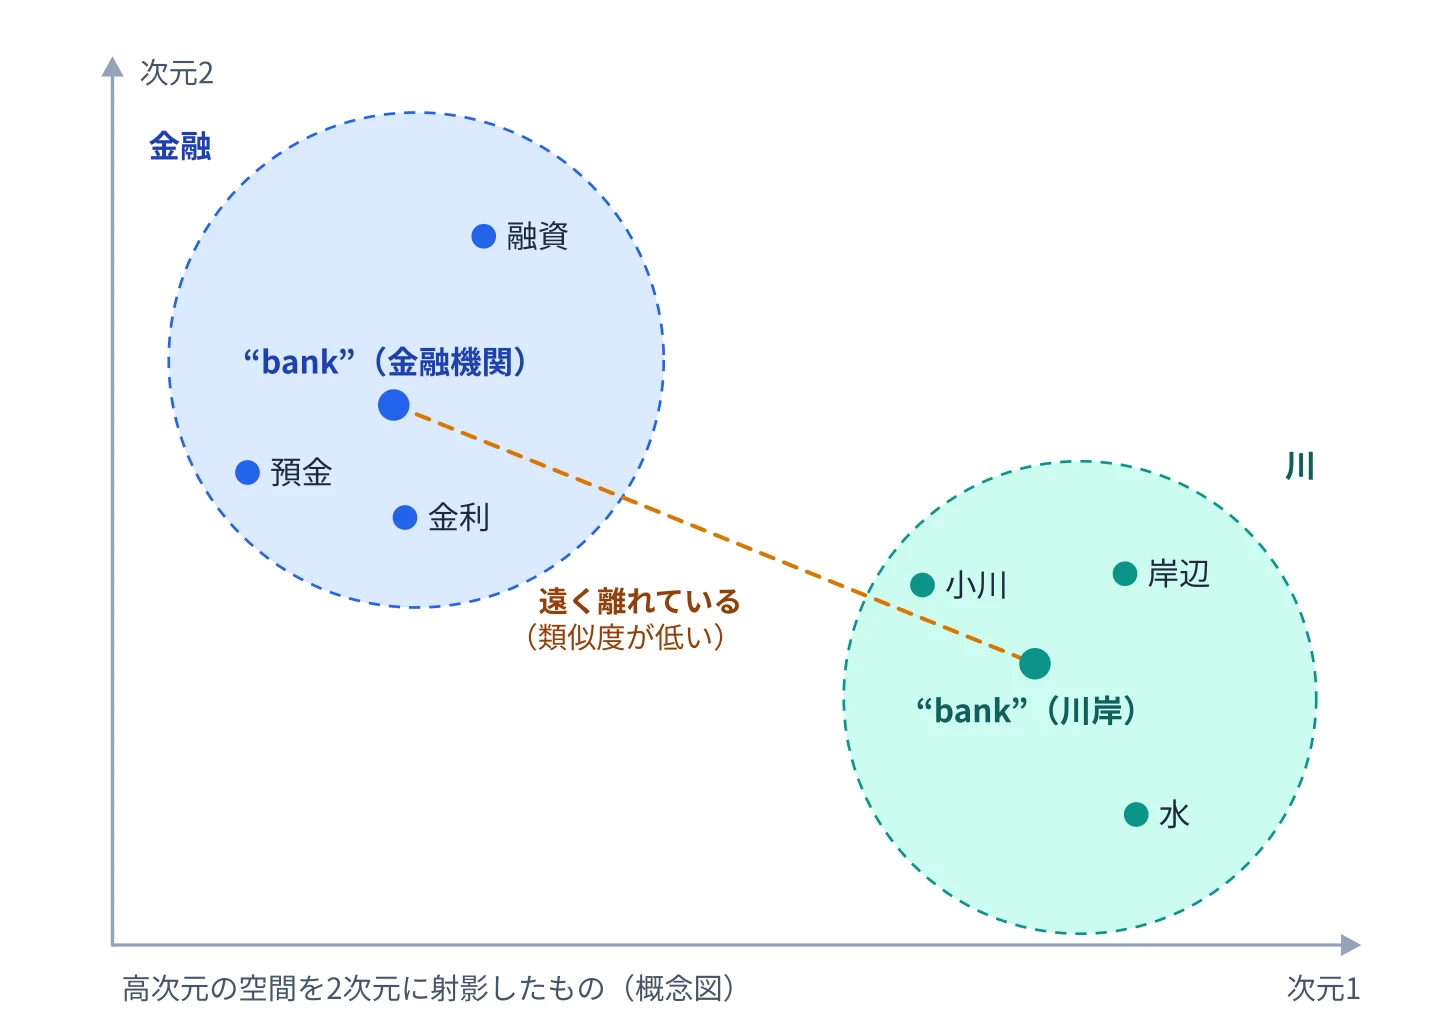
現在のLLMは文脈依存の埋め込みを生成する。単語の種類ごとに一つのベクトルを割り当てていた初期の単語埋め込みモデルとは異なり、Transformerは文脈に応じて変わる表現を作る。英語の “bank” は、“river bank”(川岸)の中と “financial bank”(金融機関)の中とでは異なる埋め込みになる。日本語でいえば、「橋を渡る」の「はし」と「箸を使う」の「はし」が区別されるようなものだ。この文脈への感度によって、意味の精度は大きく向上する。
埋め込みは、Transformerの中間層から取り出すこともできる。どの層を選ぶかによって、統語的な構造、意味内容、より高次の抽象のどれが強く表れるかが変わる。実際のシステムでは、トークンごとの表現を平均したり、専用のプーリング手法を使ったりして、文や文書全体を一つのベクトルにまとめることが多い。ただし、生成モデルの隠れ状態をそのまま使っても、文の埋め込みとしては平凡な品質にとどまる。実運用の埋め込みモデルは、通常さらに対照学習の目的関数で追加学習されている。これは、クエリと関連する文章のような対応するペアのベクトルを引き寄せ、無関係なペアを遠ざける学習である。現在もっとも性能の高い埋め込みモデルの多くは、デコーダのみの言語モデルを土台として、この方法で作られている。
埋め込みによってセマンティック検索が可能になる。キーワードの完全一致を探す代わりに、クエリと文書をベクトルに変換し、クエリの埋め込みにもっとも近い埋め込みを持つ文書を取り出す。この方法なら、言い回しが違っていても意味をとらえられる。質問応答や知識統合に使われる現在の検索システムは、この仕組みを土台にしている。
もう一つの応用がクラスタリングと分類である。文書をベクトル空間に写像すれば、近さにもとづいてグループにまとめることができ、明示的なラベル付けなしにテーマの構造が浮かび上がる。ファインチューニングによって特定のタスク向けに埋め込みの品質をさらに高めることもできるが、事前学習済みの埋め込みだけでも、かなりの意味構造をとらえていることが多い。
とはいえ、埋め込みは完璧な意味の符号化器ではない。学習データの統計的なパターンを反映しており、バイアスや不完全な知識を含むことがある。さらに、ベクトルが似ていることは事実として正しいことを保証しない。埋め込みが測っているのは分布上の類似性であって、真偽ではない。
埋め込みが保存済みのテキストから意味を取り出すことを可能にする一方で、生成は新しいテキストを合成することを可能にする。検索と生成という二つのパラダイムは、言語処理に対する相補的なアプローチである。次の7.2節「生成と検索」で、両者を直接比較する。
7.2 生成と検索
大規模言語モデルは生成システムである。文脈が与えられると、学習した確率分布からサンプリングして新しいテキストを生み出す。しかし、現実のアプリケーションの多くは生成だけでなく検索、つまり蓄積されたコーパスから関連する情報を選び出す処理にも依存している。この二つのパラダイムの違いと、互いを補い合う強みを理解することは、信頼できるAIシステムを設計するうえで欠かせない。
かみくだいて言うと
生成とは、モデルがテキストを一から作り出すことである。検索とは、システムが既存のテキストの中から関連するものを探し出すことである。どちらにも使いどころがある。生成は創造的で柔軟だが、間違えることがある。検索は事実に忠実だが、手持ちの資料にあるものしか返せない。本格的なシステムの多くは、この二つを組み合わせている。
生成はモデルのパラメータの内側で行われる。事前学習の過程で、知識は重み行列の中に暗黙的に符号化される。プロンプトが与えられると、モデルは学習中に取り込んだパターンにもとづいて応答を合成する。そのため柔軟な組み立てが可能になる。生成モデルは、外部の文書に直接アクセスしなくても、アイデアを組み合わせ、文章を要約し、言語間で翻訳し、コードの下書きを書くことができる。出力はデータベースからコピーされたものではなく、1トークンずつ組み立てられたものである。
生成の強みは抽象化と合成にある。知識がパラメータ全体に分散しているため、モデルはパターンの間を補間し、見たことのない組み合わせにも一般化できる。LLMが慣れない言い回しの質問に答えたり、学習データにそのままの形では存在しなかった説明を作り出したりできるのはこのためである。
一方で、生成モデルには限界もある。パラメトリックな知識は学習が終わった時点で固定される。世の中が変わっても、再学習しない限りモデルの内部表現は更新されない。さらに、生成はもっともらしいが誤った記述を生み出すことがある。この現象は一般にハルシネーションと呼ばれる。出力は確率分布からサンプリングされるので、文章が流暢であることは事実として正確であることを保証しない。
これに対して検索は、明示的に保存されたデータを対象に動く。クエリが与えられると、検索システムはデータベースや文書インデックスを探索し、関連する項目を返す。検索システムは、元になるコーパスを変更するだけで簡単に更新できる。また、追跡可能性もある。返された文書は直接確認できる。法令の参照や診療ガイドラインのように、最新の正確さが重要な分野では、検索が大きな強みを発揮する。
純粋な検索の限界は、新しいテキストを合成しないことにある。返せるのは既存の文書や文章の一部だけだ。ユーザーの質問に答えるために複数の情報源を統合する必要がある場合、検索だけでは筋の通った回答にならないことがある。また、検索はインデックスの作り方や類似度の尺度に大きく左右される。データの構造が整っていないと、効果が落ちる。
したがって、生成と検索の対比はどちらが優れているかという話ではなく、トレードオフの話である。生成は抽象化と組み立てに優れ、検索は根拠づけと追跡可能性に優れる。現在のシステムでは、両者の強みを生かすために組み合わせる形がますます増えている。
この二つが相補的であると認識すると、パラメトリックな推論と外部メモリシステムを統合するハイブリッドなアーキテクチャへと自然に話が進む。
7.3 外部メモリを持つハイブリッドモデル
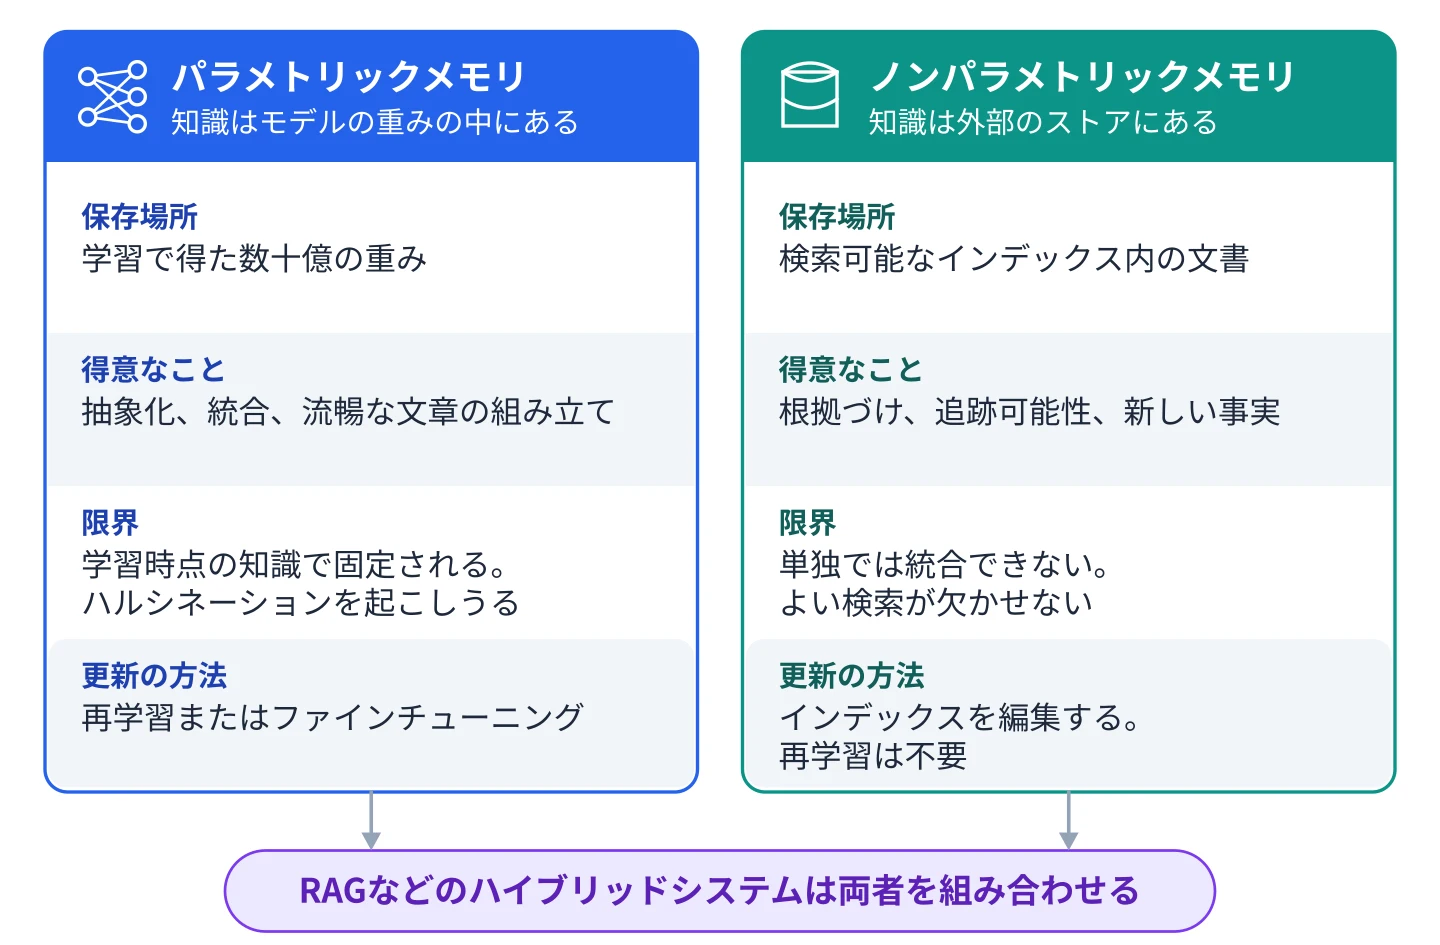
大規模言語モデルは、知識をパラメータの中に暗黙的に蓄えている。このパラメトリックメモリは強力だが、固定されている。いったん学習が終わると、新しい情報が現れてもモデルの内部表現は自動的には更新されない。さらに、パラメトリックメモリは圧縮されている。事実は明示的な項目として保存されているのではなく、分散した重みのパターンとして保存されている。そのため、中身を直接確かめたり修正したりすることが難しい。
かみくだいて言うと
ハイブリッドシステムは、モデルが学習中に覚えたことだけに頼るのではなく、外部の参考資料の書棚をモデルが使えるようにする。質問が来た時点で、システムはその書棚から関連するページを取り出し、モデルに渡して使わせる。これにより、再学習なしで最新の情報や専門的な情報を扱えるようになる。
ハイブリッドモデルは、これを補う別の形のメモリ、すなわち外部のノンパラメトリックなストレージを導入する。モデルは内部に取り込んだ知識だけに頼るのではなく、外部のデータベース、文書ストア、ベクトルインデックスにつながる。推論処理の時点で関連する情報が検索され、モデルのコンテキストに挿入される。モデルは、プロンプトと検索された資料の両方を条件として生成を行う。
概念的には、このアーキテクチャは推論と保存を切り離している。モデルは情報を合成し説明する推論エンジンとして働き、外部メモリは動的な知識ベースとして働く。メモリはモデルのパラメータとは独立に更新できる。ネットワーク全体を再学習しなくても、新しい文書をインデックスに加えられる。
この分離によって、純粋な生成システムの限界のいくつかが解消される。第一に、事実への根拠づけが強まる。関連文書をコンテキストウィンドウに直接与えることで、モデルの出力は内部の近似だけに頼るのではなく、明示的な情報によって制約される。第二に、透明性が高まる。検索された文書を引用したりユーザーに示したりでき、信頼性と監査可能性が向上する。第三に、知識の規模を拡張しやすくなる。分野の知識をすべてパラメータの中に詰め込むのは非効率で更新も難しいが、外部メモリならより自然に規模を広げられる。
技術的には、ハイブリッドシステムでは埋め込みを使って文書をインデックス化することが多い。各文書はベクトル表現に変換され、検索可能なデータベースに保存される。クエリが届くと、クエリも同様に埋め込みに変換され、類似度検索によってもっとも関連の深い文書が取り出される。取り出された文書は、追加のコンテキストとしてモデルの入力に付け加えられる。
ただし、ハイブリッドなアーキテクチャには設計上の課題がある。検索の質は出力の質に直結する。検索がうまくいかず不適切な文書が選ばれると、生成を誤った方向へ導くおそれがある。コンテキストウィンドウの上限によって、挿入できる検索結果の量も制約される。ウィンドウが数十万から数百万トークンに達した現在でも、それを埋めるにはコストがかかる。また、モデルは非常に長い入力を短い入力ほど確実には活用できない傾向がある。そのため、すべてを入れるよりも関連性の高い文章をいくつか選ぶほうが、たいていうまくいく。システムは、検索結果をどう順位づけし、絞り込み、整形するかを決めなければならない。さらに、検索と生成が別々のステップになるため、レイテンシも増える。
こうした複雑さはあっても、ハイブリッドモデルはLLMシステムの展開のしかたに実践的な転換をもたらしている。モデルを何でも知っている存在として扱うのではなく、検索、インデックス作成、知識管理を含むより大きなシステムの一つの構成要素として扱うのである。
この考え方のもっとも広く採用されている実装の一つが、検索拡張生成である。次の7.4節「検索拡張生成(RAG)」で、その構造と意味合いを見ていく。
7.4 検索拡張生成(RAG)
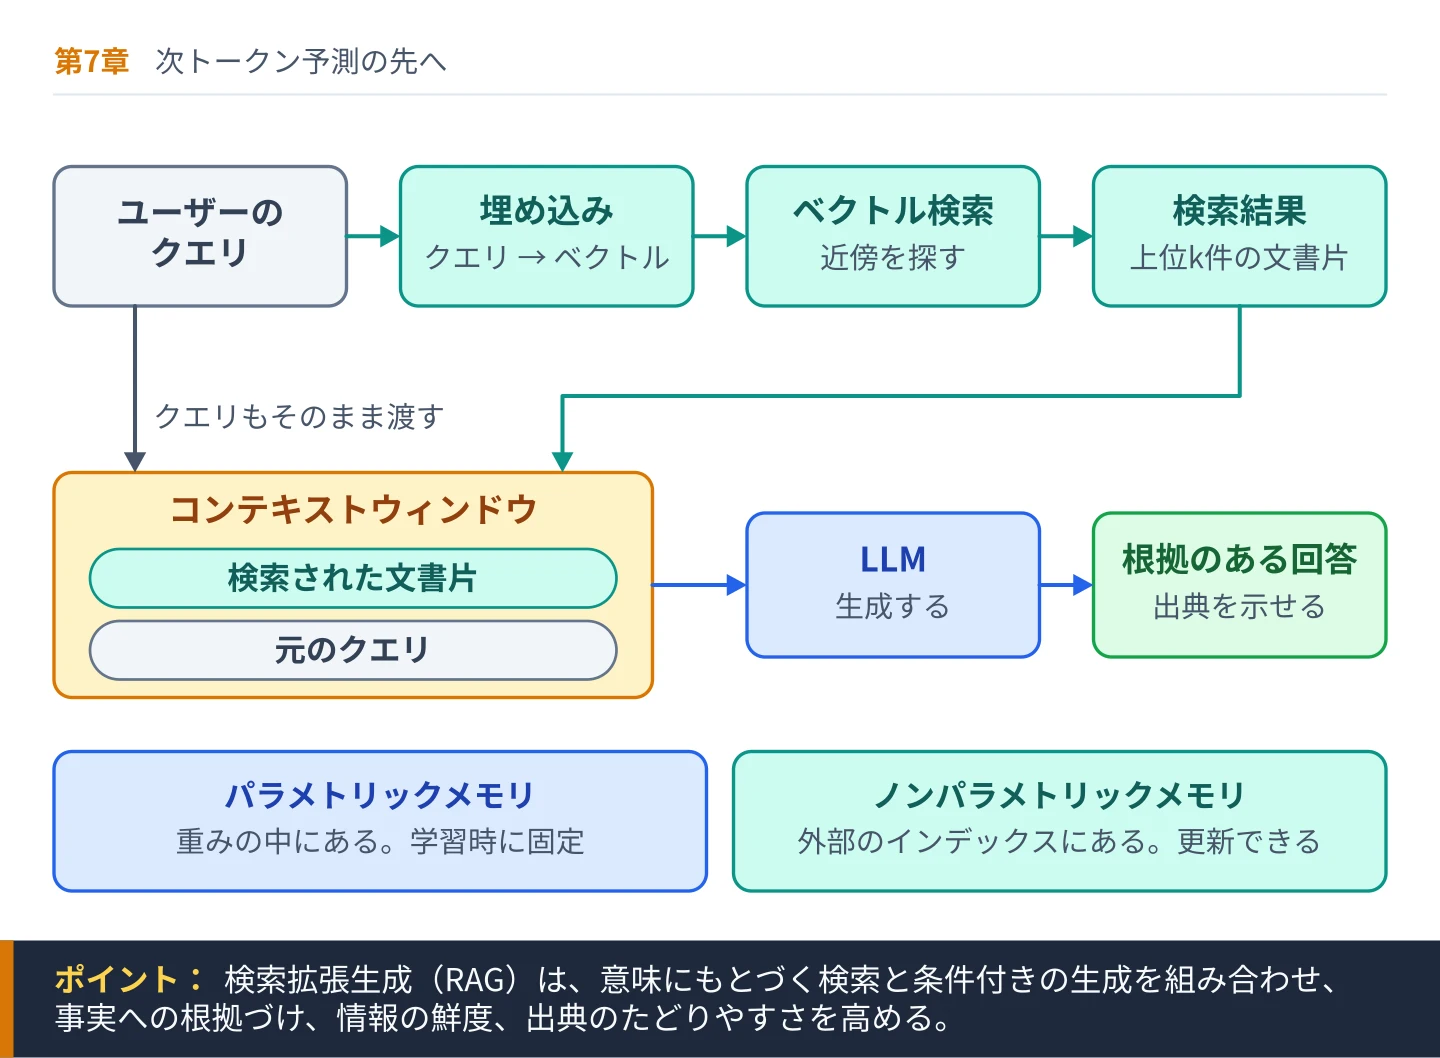
検索拡張生成(Retrieval-Augmented Generation)、略してRAGは、検索と生成を一つのパイプラインに統合した具体的なアーキテクチャである。RAGシステムは、モデルの重みに蓄えられたパラメトリックな知識だけに頼るのではなく、推論処理の時点で関連文書を検索し、その文書を条件としてモデルに出力させる。この設計は、大規模言語モデルが抱える二つの中心的な課題、すなわち事実への根拠づけと知識の鮮度に対処するものである。
かみくだいて言うと
RAGはもっとも一般的なハイブリッドのパターンである。質問をすると、システムはまず知識ベースからもっとも関連する文章を探し、質問とその文章をまとめてモデルに渡し、それを使って答えるよう求める。多くの企業向けAIアシスタントが社内固有の情報について正確さを保てるのは、この仕組みによる。
大まかに言えば、RAGシステムは四つのステップで動く。第一に、ユーザーのクエリを埋め込みベクトルに変換する。第二に、このベクトルを使って文書インデックスを検索し、もっとも関連する文章を取り出す。インデックスにはベクトルデータベースを使うことが多く、キーワード検索と組み合わせることもよくある。第三に、取り出した文章を元のクエリとまとめて一つのプロンプトにする。第四に、言語モデルがクエリと検索したコンテキストの両方を条件として応答を生成する。
検索の部分は、通常セマンティック検索に頼る。知識ベースの各文書は、同じモデル、または互換性のあるモデルで埋め込みに変換されている。クエリが届くと、コサイン類似度などの類似度の尺度を使って、ベクトル空間でもっとも近い文書を特定する。これにより、キーワードの一致を超えて意味的な関連性をとらえた検索ができる。実際には、実運用のシステムの多くがこの密ベクトル検索に従来のキーワード検索を組み合わせている(ハイブリッド検索)。キーワード検索は、正確な識別子やまれな用語の検索では今も優れているからだ。そのうえで、統合した候補をリランキング用のモデルで採点し直してから、生成側に渡す。
生成の部分では、検索された文章を入力コンテキストの一部として扱う。Transformerはそれまでのすべてのトークンを条件として予測するので、検索された情報を推論の過程に直接取り込める。検索された文章に答えがそのまま含まれていれば、モデルはそれを要約したり統合したりできる。複数の文章が互いに補い合う詳細を含んでいれば、モデルはそれらを組み合わせて筋の通った説明にまとめられる。
RAGの利点は実践的で、効果も大きい。第一に、応答を外部文書に根拠づけることで事実の正確さが向上する。第二に、ベースモデルを再学習しなくても知識を更新できる。文書インデックスを更新するだけでよい。第三に、透明性が得られる。検索された文書を生成された回答と一緒に示せるので、ユーザーが情報源を確認できる。
とはいえ、RAGは差し込めばすぐ動くような単純な解決策ではない。検索の質が決定的に重要である。インデックスの作りが悪い、文書にノイズが多い、埋め込みの質が低いといった問題があれば、性能は落ちる。コンテキストの長さと効率の間にもトレードオフがある。プロンプトに含める文書が多いほど計算コストは高くなり、無関係な情報がコンテキストを薄めるリスクも大きくなる。一貫性を保つには、チャンク分割、順位づけ、プロンプトの整形を慎重に行う必要がある。
もう一つの課題は統合のしかたにある。モデルは検索されたテキストを写すだけでなく、それを適切に解釈し、統合しなければならない。プロンプトには「以下の文書を使って質問に答えてください」のような明示的な指示を含めることが多い。こうした指示は、自由な推測ではなく根拠にもとづいた推論へと生成を導く助けになる。
さらに進んだ形として、検索をモデル自身の制御下に置く方式がある。エージェント型検索(agentic retrieval)では、言語モデルにツールとして検索機能が与えられる。モデルは検索が必要かどうかを判断し、自分でクエリを組み立て、結果を確認し、答えるのに十分な根拠が集まるまで追加の検索を行う。これにより、固定された四つのステップのパイプラインがループになり、1回の検索では取りこぼしてしまう多段階の質問にも対応できる。その代わり、レイテンシは大きくなり、挙動は予測しにくくなる。根底にある仕組みは変わらない。検索されたテキストがモデルに届くのは、あくまでコンテキストに置かれることによってである。
RAGシステムは、より一般的なアーキテクチャのパターンを示している。大規模言語モデルは、知識を明示的に管理する構造化されたシステムに組み込まれたときにもっともよく機能する。LLMは検索を置き換えるのではなく、検索を強化するのである。
リスト7.1 4ステップのRAGパイプライン。実運用のシステムでは、この骨格の周りにチャンク分割、リランキング、キャッシュ、出力検証が加わる。
# 検索拡張生成(概念的な骨格)
query_vec    = embed(user_query)                  # 1. query to vector
hits         = vector_store.search(query_vec, k)  # 2. nearest neighbors
context      = concat(doc.text for doc in hits)   # 3. build grounded context
prompt       = template.format(ctx=context, q=user_query)
answer       = llm.generate(prompt)               # 4. conditioned generation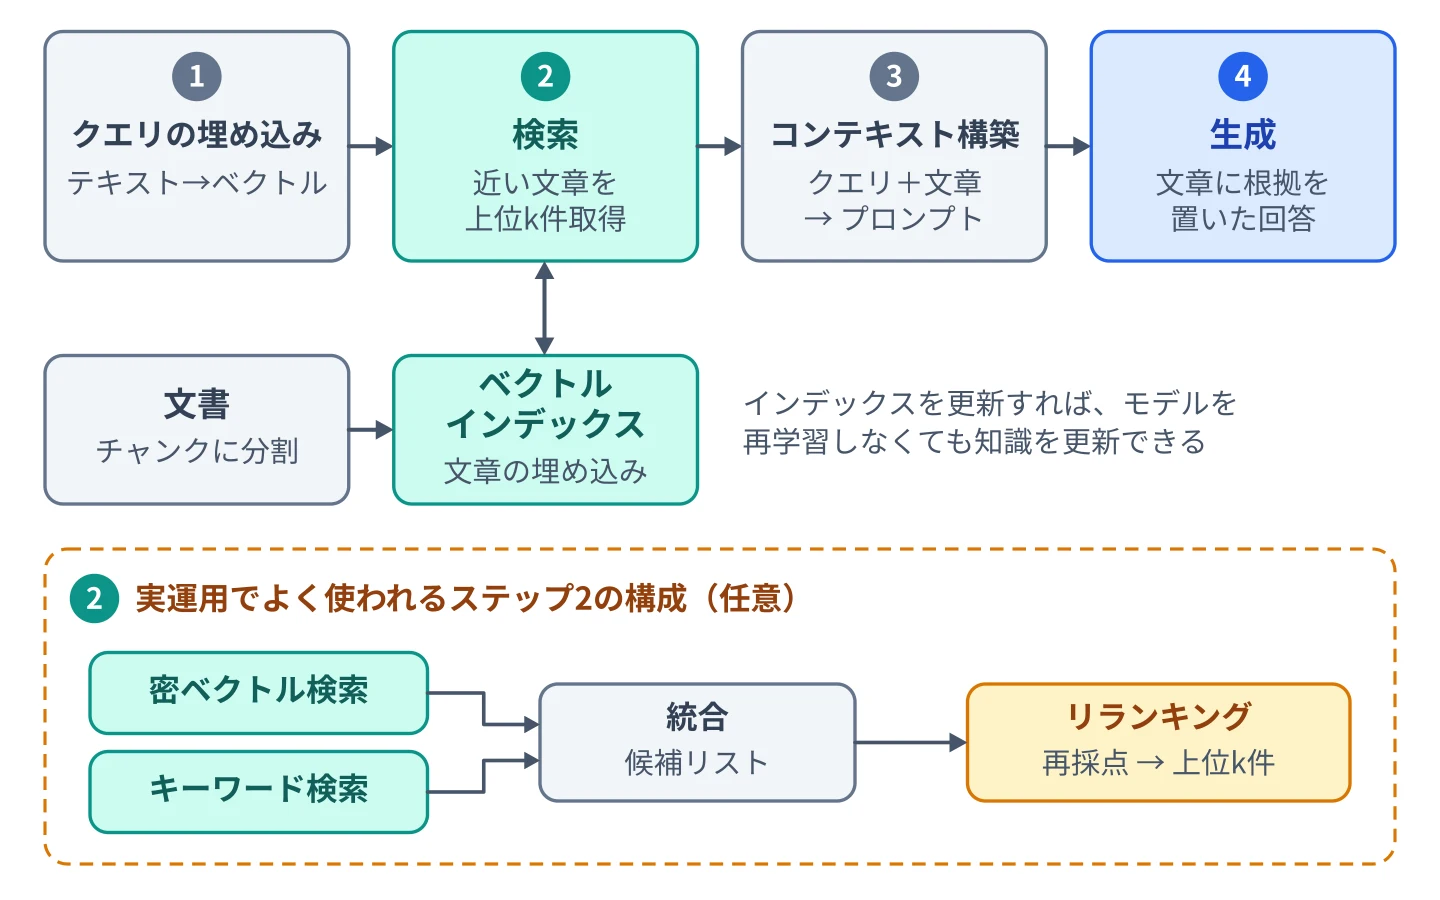
さらに深く:文書のパース、チャンク分割の戦略、ベクトルデータベースの選定、検索パイプライン、アクセス制御、評価など、実運用向けのRAGシステムの構築については、LLM Primer III — Enhancing Enterprise AI with RAG(英語版)で扱う。
検索と外部メモリは、言語モデルをある一つの方向に拡張する。現在のシステムはもう一つの方向にも拡張している。画像や音声といった他のモダリティとテキストの統合である。次の節では、ここまでの原理が言語の外へどのように広がるかを見ていく。
7.5 マルチモーダルへの拡張
ここまでは、言語を主要なモダリティとして扱ってきた。トークンはテキストを表し、注意機構はテキストの系列の上で働き、検索システムは文書をインデックス化する。しかし、人間のコミュニケーションはテキストだけでできているわけではない。画像、音声、図、動画も情報を運ぶ。マルチモーダルへの拡張は、大規模言語モデルの原理をテキストの外へ広げ、複数の形式のデータを統一的な表現に統合するシステムを可能にする。
かみくだいて言うと
マルチモーダルとは、モデルがテキスト以外も扱えることを意味する。典型的にはテキストと画像を一緒に扱い、最近では音声や動画も扱えるようになっている。根底にある数学はテキスト処理とほぼ同じだが、単語に加えて画素や音声フレームを表す「トークン」も扱う点が異なる。マルチモーダルモデルは、写真を見て説明したり、グラフを読み取って要約したりできる。
概念的には、マルチモーダルなモデル化には二つの能力が必要である。第一に、テキスト以外の入力を、言語の埋め込みと互換性のあるベクトル表現に符号化できること。第二に、あるモダリティの情報が別のモダリティの解釈に影響を与えられるよう、モダリティ間の相互作用を可能にすることである。
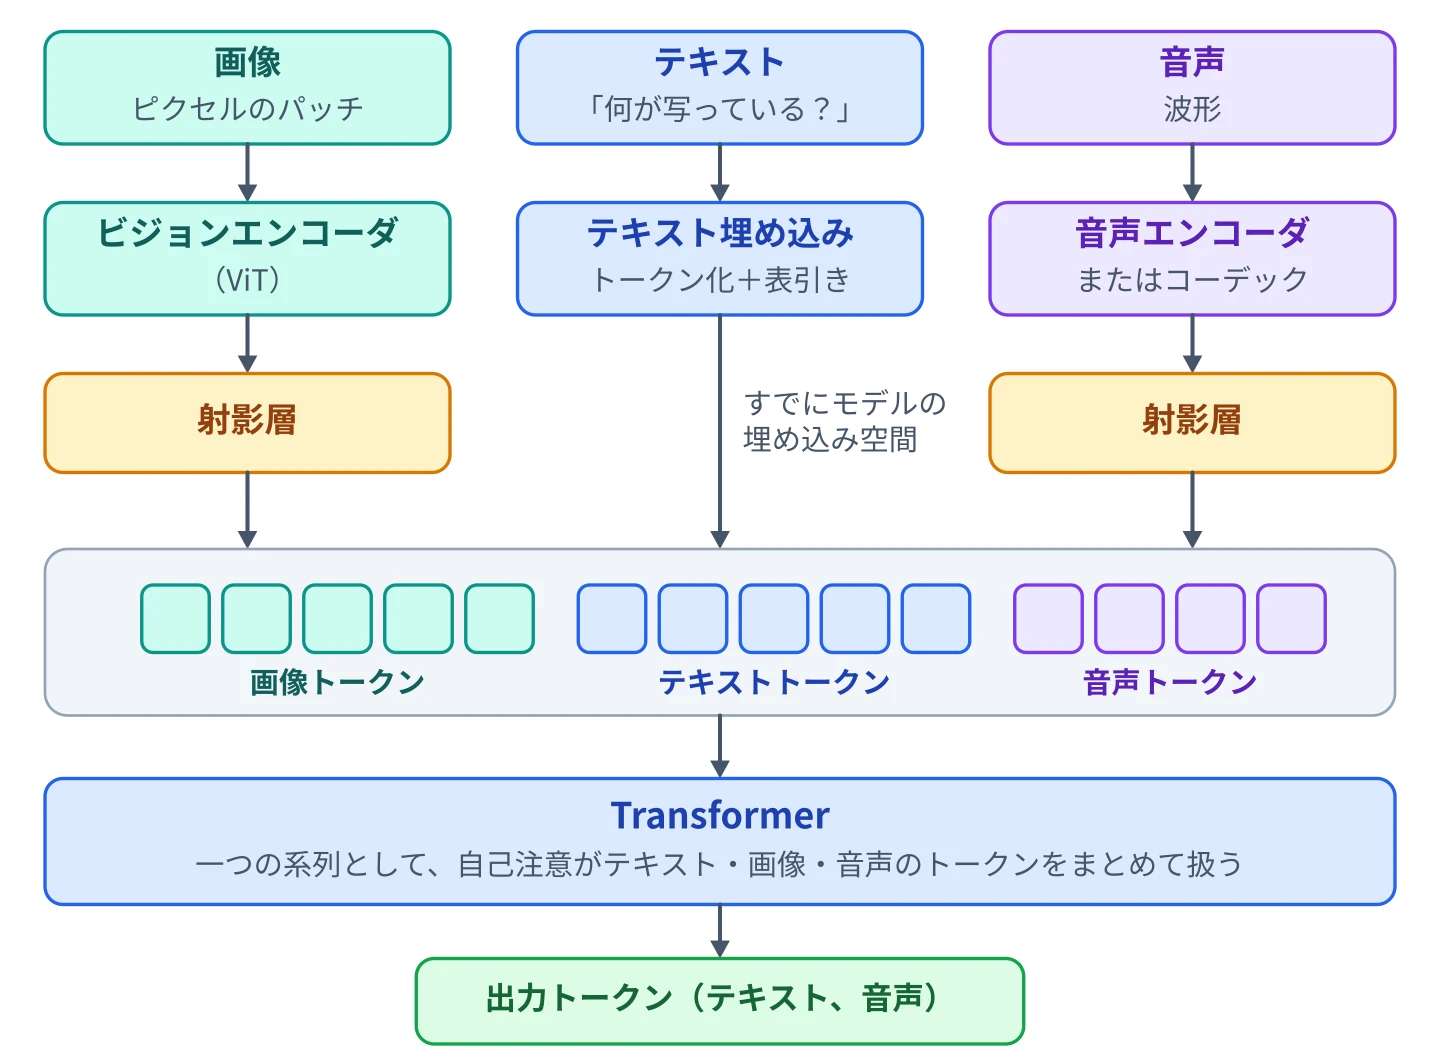
視覚言語モデルを例に考えよう。画像は視覚エンコーダで処理される。現在はビジョンTransformerが一般的で、以前は畳み込みニューラルネットワークがよく使われていた。視覚エンコーダは画素データを視覚埋め込みの系列に変換する。この埋め込みは、共有された表現空間の中でテキストの埋め込みと位置合わせされる。よく使われる設計では、小さな射影層で各視覚埋め込みを言語モデル自身のトークン埋め込み空間に写し、画像のパッチが追加のトークンであるかのようにモデルに入力されるようにする。新しいモデルの中にはさらに一歩進んで、別に学習した視覚エンコーダを後から取り付けるのではなく、テキストと画像のトークンが交互に並んだデータで最初から学習するものもある。学習の過程で、モデルは画像と、それに対応するキャプションや説明文との関連を学ぶ。その結果、画像を条件としてテキストを生成したり、視覚的な内容についての質問に答えたり、さらにはテキストのクエリから画像を検索したりできるようになる。
ここで中心的な役割を果たすのが、モダリティ間の注意機構(クロスモーダル注意)である。自己注意がトークンどうしの間で注意を向けることを可能にするのと同じように、マルチモーダルのアーキテクチャでは、テキストのトークンが視覚のトークンに注意を向け、その逆も可能になる。専用のクロス注意層を使う方式もあれば、射影を使う設計のように、視覚トークンとテキストトークンが一つの系列を共有し、通常の自己注意が両方にまたがるだけという方式もある。この相互作用によって、モデルは言語を知覚的な特徴に結びつけられる。たとえば「この車は何色ですか」と尋ねられると、テキストのクエリが画像内の車にあたる領域に注意を向け、関連する特徴を取り出す。
音声や発話も同じように組み込める。音声波形はスペクトログラムなどの中間表現に変換され、それが埋め込みに符号化される。この埋め込みをテキストの書き起こしと位置合わせすることで、音声認識、音声合成、マルチモーダルな対話システムといったタスクが可能になる。より新しい音声モデルは、ニューラル音声コーデックを使って音声を離散的なトークンに変換し、そのトークンをテキストと並べて直接モデル化する。これにより、音声をいったんテキストに書き起こしてから返答を音声合成するという手順を踏まずに、リアルタイムで音声による会話ができる。
マルチモーダルなモデル化における重要な課題の一つが、位置合わせ(アライメント)である。モダリティごとに構造も次元も異なるなかで、モデルはモダリティ間の一貫した対応関係を学ばなければならない。画像は空間的な構造を持ち、テキストは系列的であり、音声は時間的である。こうした対応づけを確立するには、画像とキャプション、音声とテキスト、動画と書き起こしといった、丁寧に構築したペアのデータセットが学習に必要になる。
もう一つの課題は規模である。マルチモーダルのデータセットは、テキストだけのコーパスに比べて小さいか、整備に費用がかかることが多い。過学習を避けながらモダリティ間のバランスをとるには、サンプリング戦略を慎重に設計する必要がある。さらに、より複雑なエンコーダやクロス注意層を組み込むほど、計算コストも増える。
こうした課題はあっても、マルチモーダルシステムはLLMの原理の自然な拡張である。その中核は、依然としてトークンのような表現の上の確率モデルである。違いは、トークンが視覚のパッチ、音声のフレーム、その他の感覚的な単位を表しうることにある。注意機構、埋め込みの位置合わせ、大規模な学習という同じアーキテクチャ上のパターンが、モダリティをまたいだ統合を可能にしている。
ポイント:埋め込み、検索、外部メモリ、マルチモーダル性は、いずれも次トークン予測を置き換えるのではなく拡張するものである。どの場合も、モデルはトークンのような表現の上の確率的な予測器であり続ける。変わるのは、その表現が何を符号化しているかである。
こうして視野を広げたことで、純粋な次トークン予測を越え、検索し、根拠づけ、複数のモダリティを統合するシステムへと進んできた。ここからは、内部の仕組みから、現実世界での応用と展開へと焦点を移す。本書の次の部、第III部「実践的な視点」に進もう。
ここまで、大規模言語モデルを内側から見てきました。確率的な基盤を定義し、Transformerアーキテクチャを学び、大規模な学習パイプラインを分析し、適応の戦略やハイブリッドシステムを探ってきました。第III部では視点を切り替えます。LLMが内部でどう動くかではなく、実運用のシステムの中でどう振る舞うのか、エンジニアはそれを前提にどう設計すべきなのかを問います。
この部のテーマは、実務のエンジニアリングにおける判断です。現実の運用には、理論だけではとらえきれない制約があります。レイテンシの要件、コストの上限、信頼性の基準、安全面の配慮、ユーザー体験の設計などです。製品に組み込まれたLLMは、こうした制約の範囲内で動きながら、なおかつ価値を提供しなければなりません。
第8章「アプリケーションでのLLM活用」では、具体的な応用パターンを探ります。チャットボットと対話エージェント、要約システム、検索の強化、コード生成アシスタント、知識抽出パイプライン、ベンチマークにもとづくモデル選定、そしてモデルがツールを組み合わせて動かすエージェント型システムを取り上げます。モデルをブラックボックスとして扱うのではなく、プロンプト、検索層、構造化出力がどう組み合わさって実際に機能するシステムになるのかを分析します。重点を置くのは、単発のデモではなく設計パターンです。
第9章「性能、スケーリング、コスト」では、運用上のトレードオフに焦点を当てます。モデルの規模は能力を左右しますが、レイテンシや費用にも影響します。スループットの最適化、バッチ処理とキャッシュの戦略、量子化をはじめとする推論処理の効率化技術、そしてクラウドでの推論処理からエッジデバイスまでの展開環境について論じます。これらのトレードオフを理解することは、持続可能なシステム設計に欠かせません。
第10章「安全性、倫理、信頼」では、信頼性とガバナンスを扱います。大規模言語モデルは、流暢でありながら誤った内容や偏った内容を生成することがあります。ハルシネーション、バイアスの緩和、ガードレール、説明可能性、責任あるAIの実践について検討します。この章では、展開を単なる技術的な課題ではなく、社会と技術の両面にまたがる責任として捉え直します。
ポイント:LLMを効果的に展開するには、アーキテクチャについての理解を、実務上のエンジニアリングの制約、コスト意識、安全面の配慮と結びつける必要があります。
この応用編は、大規模言語モデルが現実のシステムやワークフローにどう組み込まれているかを見ることから始めます。
ポチっとでの実践
検索した記憶を使う前に
好みや記憶は本人が訂正・削除できるデータとして管理します。たとえば「屋内コートが好き」という記憶を使うときは、同じ本人の最新の記録か、今回の希望と矛盾しないかを確認します。検索で近いという理由だけで事実を確定しません。
下田昌平 著『LLM 生成AIのしくみ』2026年版。書籍をAmazonで見る